데이터 파이프라인에서 RDB와 S3를 나누는 기준
수집한 데이터를 전부 RDB에 두던 습관을 멘토님 피드백으로 다시 본 기록. 저장소는 "편한 곳"이 아니라 "데이터의 역할"로 정한다.
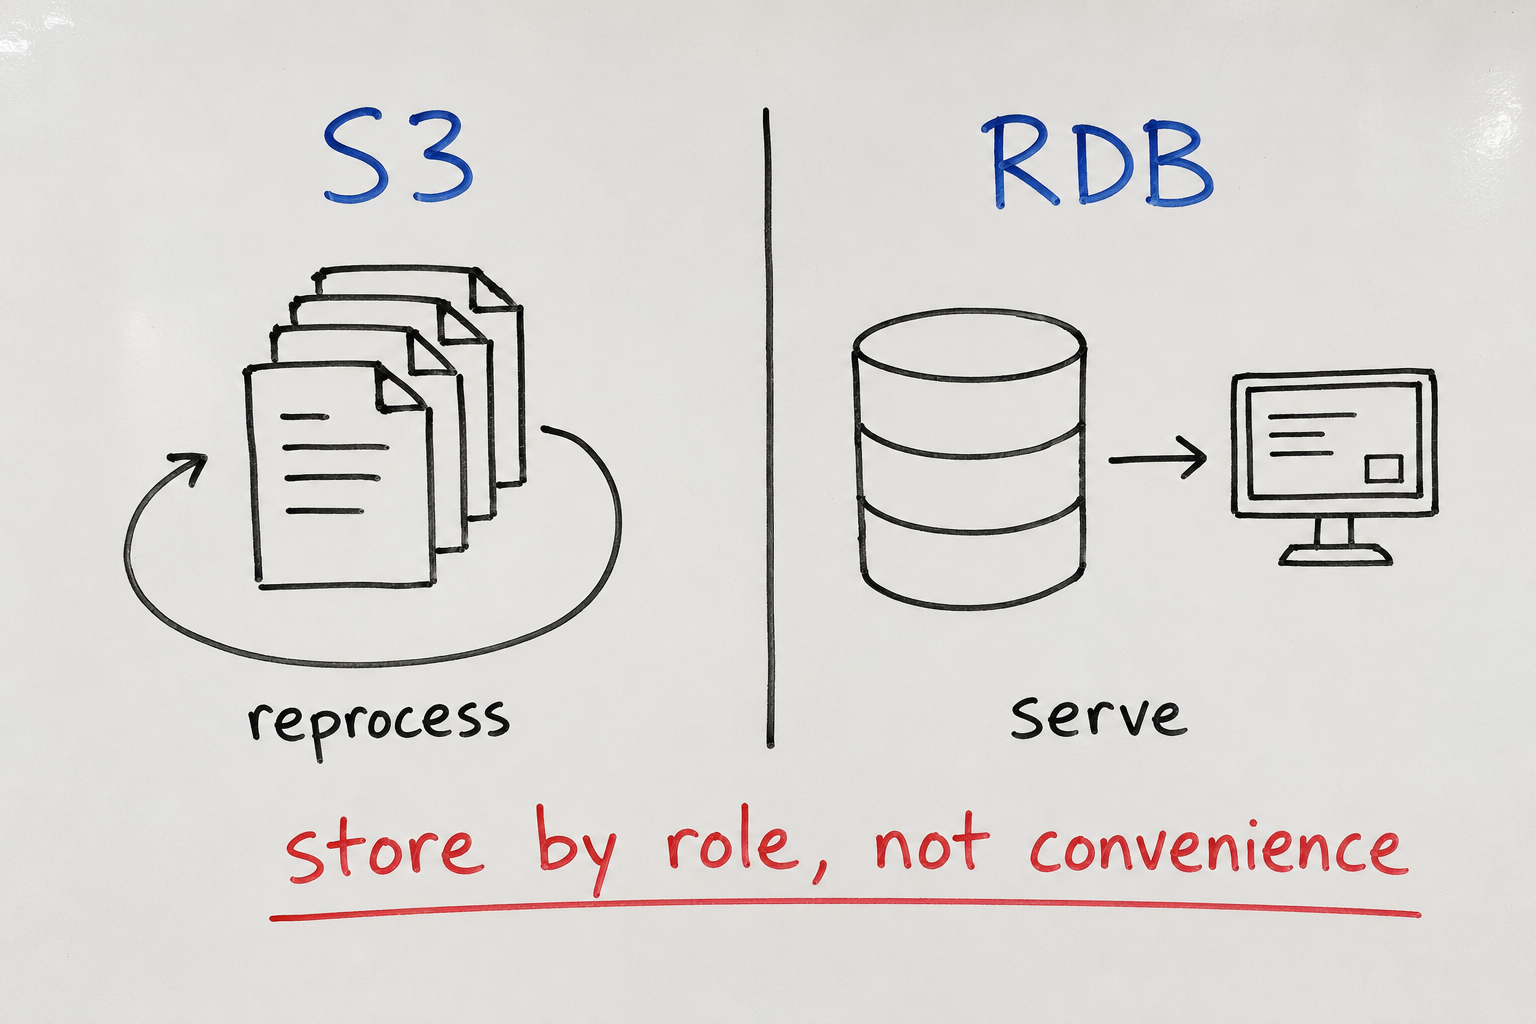
처음 데이터 파이프라인을 만들었을 때, 수집한 데이터를 전부 RDB에 넣었다. 뉴스 원문, 가격, 재무제표, 새로 만든 피처까지 전부 테이블에 직접 박았다. 한 곳에 다 있으니까 편하다고 생각했다.
그런데 데이터를 다시 만들어야 하는 순간이 자주 왔다. 정규화 규칙을 손보거나 원천 API가 바뀌면 외부에서 다시 받아 저장하는 흐름을 처음부터 돌렸다. 그때마다 수집 코드를 다시 굴렸고, 이미 RDB에 있던 테이블은 다시 덮어쓰는 식이라 이전 상태가 남아 있지도 않았다.
멘토님에게서 한 줄 피드백을 받았다. 컨슈머가 직접 소비하는 최종 데이터는 RDB에 두고, 그 이전 단계의 원천과 중간 산출물은 S3에 두는 편이 좋겠다는 내용이었다. 처음엔 어차피 데이터인데 어디에 넣든 뭐가 다를까 싶었다. 그런데 우리 파이프라인은 뉴스와 가격을 계속 쌓고 다시 처리해야 하고, 전 종목 커버리지와 준실시간성을 함께 챙겨야 했다. 그러면 저장소를 정하는 기준은 어디가 편한가가 아니라 그 데이터가 어떤 역할을 하는가여야 했다.
처리 성격과 적재 순서를 구분하면 저장소의 역할이 보인다
멘토님 피드백은 저장소 이름보다 처리 방식과 데이터의 역할을 먼저 보라는 의미로 받아들였다. 처리 성격, 적재 순서, 저장 구조를 나눠 보면 이 결정을 설명할 수 있다.
OLTP와 OLAP. OLTP는 지금 발생하는 거래·요청을 한 건 단위로 정확히 처리하는 쪽이고, OLAP은 쌓인 데이터를 대량으로 스캔·집계하는 쪽이다. 작은 단위의 조회·갱신에는 행 지향 RDB가, 넓은 범위의 집계에는 열 지향 분석 DB가 자주 쓰이지만, 처리 성격과 저장소 종류가 일대일로 대응하는 것은 아니다. 우리 파이프라인이라면 기간별 가격 흐름을 비교하거나 팩터를 계산하려고 전 종목을 훑는 작업은 OLAP 쪽이고, 특정 종목의 설명 결과를 한 건 내려주는 건 OLTP 쪽이다.
ETL과 ELT. 데이터를 변환한 뒤 대상에 적재하는 순서가 ETL이고, 먼저 적재한 뒤 변환하는 순서가 ELT다. 원본을 별도로 보관할지는 이 순서와 별개의 결정이므로 ETL이라고 원본이 반드시 사라지는 것은 아니다. 우리 파이프라인에서는 S3에 원본을 먼저 남겨 변환 로직이 바뀌어도 다시 처리할 출발점을 확보하는 쪽을 택했다.
Lake와 Warehouse. 형식을 가리지 않고 원천과 중간 산출물을 그대로 쌓아 두고 읽을 때 스키마를 입히는(schema-on-read) 쪽이 Data Lake고, 적재 시점에 스키마가 정해지고 (schema-on-write) 정형 조회에 최적화된 쪽이 Data Warehouse다.
세 개를 겹쳐 보면 그림이 나온다. 원천과 중간 산출물은 schema-on-read로 S3에 남겨 재처리에 열어두고, 최종 마트는 정형 저장소에 모아 컨슈머가 바로 읽게 한다. 멘토님 피드백이 말한 게 정확히 이 그림이었다.
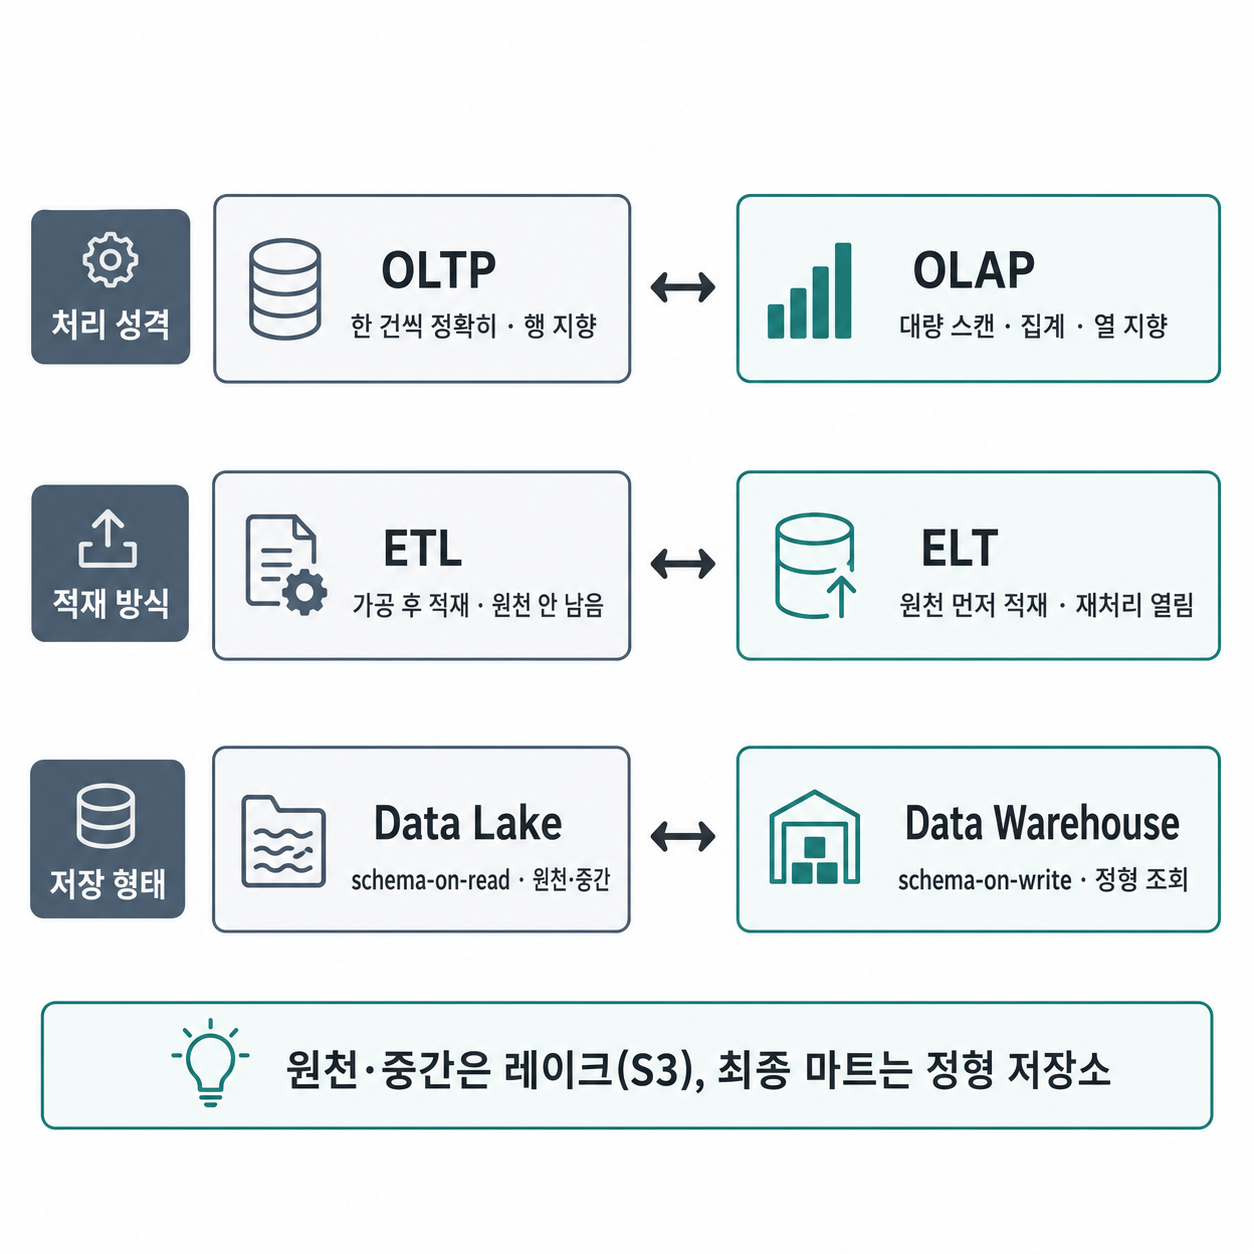 저장소를 가르는 세 축 — 처리 성격, 적재 방식, 저장 형태.
이 파이프라인은 원본 보존과 직접 조회의 역할을 나눈다
멘토님 피드백의 핵심은 “RDB를 쓰지 말자”가 아니라 RDB와 S3의 역할을 나누자는 것이었다. 이 프로젝트에서 정한 기준은 재처리에 사용할 원본·정제 데이터를 S3에 두고, 분석 엔진과 서빙이 직접 조회하는 결과를 RDB에 두는 것이다. 모든 시스템에 적용되는 저장소 분류가 아니라 현재 파이프라인의 조회 방식과 보관 요구에 맞춘 결정이다.
S3에는 원천과 정제 결과를 둔다. 뉴스·가격·재무제표·공시 원본과 그걸 표준 스키마로 정규화한 결과다. 정규화 규칙이나 품질 기준이 바뀌면 과거 구간을 다시 만들어야 하는데, 원본이 남아 있으면 외부 API를 다시 부르지 않고 정제만 다시 돌리면 된다.
RDB에는 소비되는 데이터를 둔다. 팩터, 분석 산출물, 설명 결과처럼 분석 엔진과 서빙이 바로 읽는 데이터다. 처음에 나는 “소비자”를 API 서버로만 좁게 봤다. 그런데 분석 엔진도 소비자다. 팩터와 피처도 계산을 다시 할 수 있는 데이터지만, 분석 엔진이 곧바로 읽는 입력이라는 역할도 있다. 현재 구조에서는 이 직접 조회를 RDB가 맡도록 정했다. S3에서 직접 소비하는 구성이 불가능해서가 아니라, 읽는 쪽의 접근 방식까지 함께 선택한 것이다.
따라서 소비자는 API 서버뿐 아니라 분석 엔진까지 포함한다. 같은 데이터가 재처리와 직접 조회에 모두 필요할 수 있으므로, 이름만 보고 중간 데이터와 최종 데이터로 나누지는 않는다.
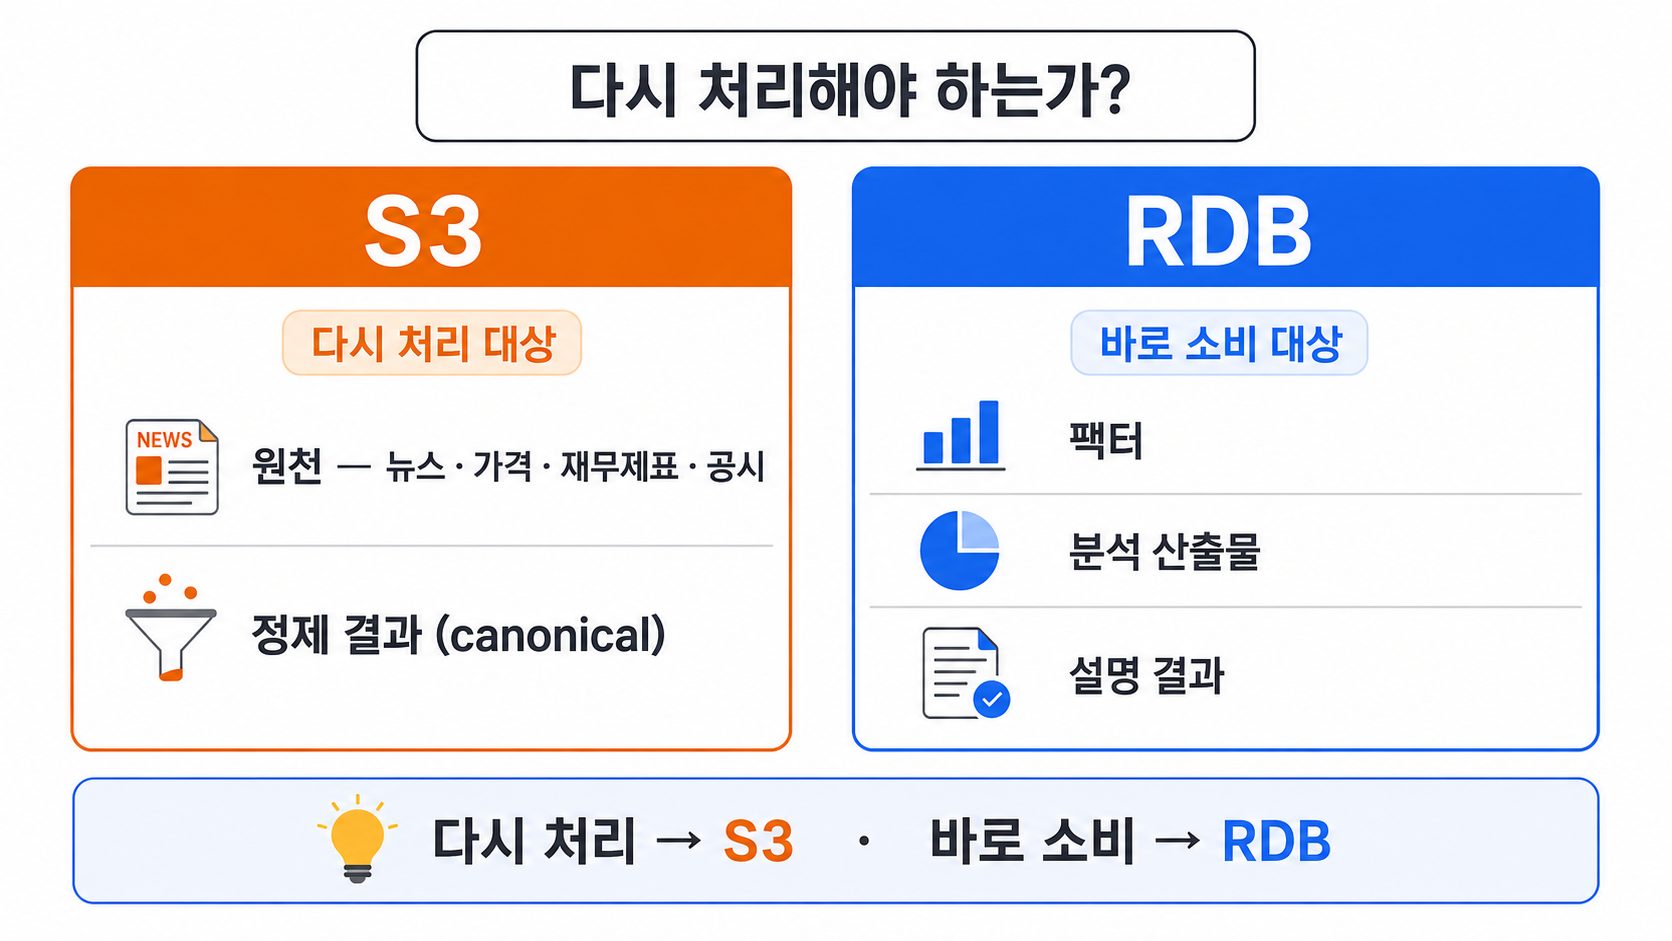 이 프로젝트에서는 재처리용 원본·정제 데이터는 S3에, 직접 조회하는 결과는 RDB에 둔다.
마무리
처음에는 수집한 데이터를 한곳에 모으는 편의성을 우선했지만, 다시 계산할 때 사용할 원본과 직접 조회할 결과의 역할을 나눌 필요가 있었다. 멘토님 피드백을 바탕으로 원본·정제 데이터는 S3에, 분석 엔진과 서빙이 읽는 결과는 RDB에 두는 기준을 정했다.
이 기준이 모든 데이터를 둘로 나누지는 않는다. 팩터처럼 재계산 대상이면서 직접 소비되는 데이터도 있다. 저장 위치를 정할 때는 필요한 이력이 남는지와 소비자가 어떤 방식으로 조회하는지를 함께 봐야 한다.
RDB와 S3 중 어느 쪽이 항상 낫다는 결론은 아니다. 현재 선택은 이 파이프라인의 역할 분담이며, 데이터 규모나 조회 패턴이 달라지면 보관과 소비 방식을 다시 검토할 수 있다.