Airflow 전환에서 재접속과 재실행 보류를 선택한 이유
EDGE에서는 수집·정제·적재로 끝나는 배치의 오케스트레이션을 작업군별로 Airflow로 옮기기 시작했다. 첫 전환 대상은 AWS 개발 환경의 장중 수급 배치였다. 업무 코드는 기존 ECS 컨테이너를 사용하고, 그 작업의 실행 순서와 결과를 관리하는 주체를 바꿨다.
전환 과정에서 중요한 문제는 Airflow가 실패를 표시한 뒤 ECS 작업이 어떻게 되는지였다. Airflow 워커가 중단되거나 응답을 잃더라도, 이미 제출한 ECS 컨테이너는 계속 실행될 수 있다. Airflow의 재시도를 곧바로 새 ECS 작업의 실행으로 연결하면 같은 일을 겹쳐 수행할 수 있었다.
나는 실행 중인 작업에는 재접속하고, 상태를 확인하지 못한 작업은 자동으로 다시 시작하지 않는 정책을 택했다. 이관 구현과 실험에는 AI 에이전트의 도움을 받았다. 첫 전환에서는 자동 복구 범위를 줄이고 일부 수집 공백을 감수하는 대신, 어떤 증거가 있을 때 다시 실행할지를 분명히 했다.
Airflow task가 끝나도 ECS 작업은 계속 실행될 수 있었다
Airflow task는 배치의 한 단계를 관리한다. 이 프로젝트에서는 task가 ECS에 업무 컨테이너를 제출하고, 그 컨테이너의 종료를 기다렸다. Airflow가 실행하는 대기 코드와 ECS에서 데이터를 쓰는 업무 코드는 다른 프로세스이며 수명도 다르다.
정제 컨테이너가 실행 중일 때 Airflow 서비스만 재배포된다면, 새 시도에서 기존 정제 작업을 찾아야 한다. 새 컨테이너부터 띄우면 같은 파티션을 동시에 갱신할 가능성이 생긴다.
당시 Amazon provider 9.36.0의 EcsRunTaskOperator는 reattach=True일 때 같은 task instance의 실행 중 태스크를 찾았다. 하지만 기본 재접속 경로는 RUNNING 조회를 사용한다. 이미 종료된 태스크의 결과를 놓친 경우나 제출 응답만 잃은 경우까지 프로젝트 정책대로 판단해 주지는 않았다.
종료 처리도 따로 확인해야 했다. stop_task_on_failure=False는 태스크 제출 후 대기 오류에서 ECS를 멈추는 동작을 제어하지만, 당시 on_kill()은 이 옵션과 별도로 StopTask를 호출했다. 대기를 끝내면서 업무 컨테이너까지 중간에 끊으면, 외부 호출이나 저장이 어디까지 됐는지 모르는 상태가 될 수 있었다.
프로젝트의 EdgeStep은 on_kill()에서 로그 수집을 정리하되 ECS 작업에는 종료 요청을 보내지 않도록 했다. 남겨 둔 작업의 종료 추적과 중복 실행 방지는 재접속 코드와 업무 원장이 맡았다.
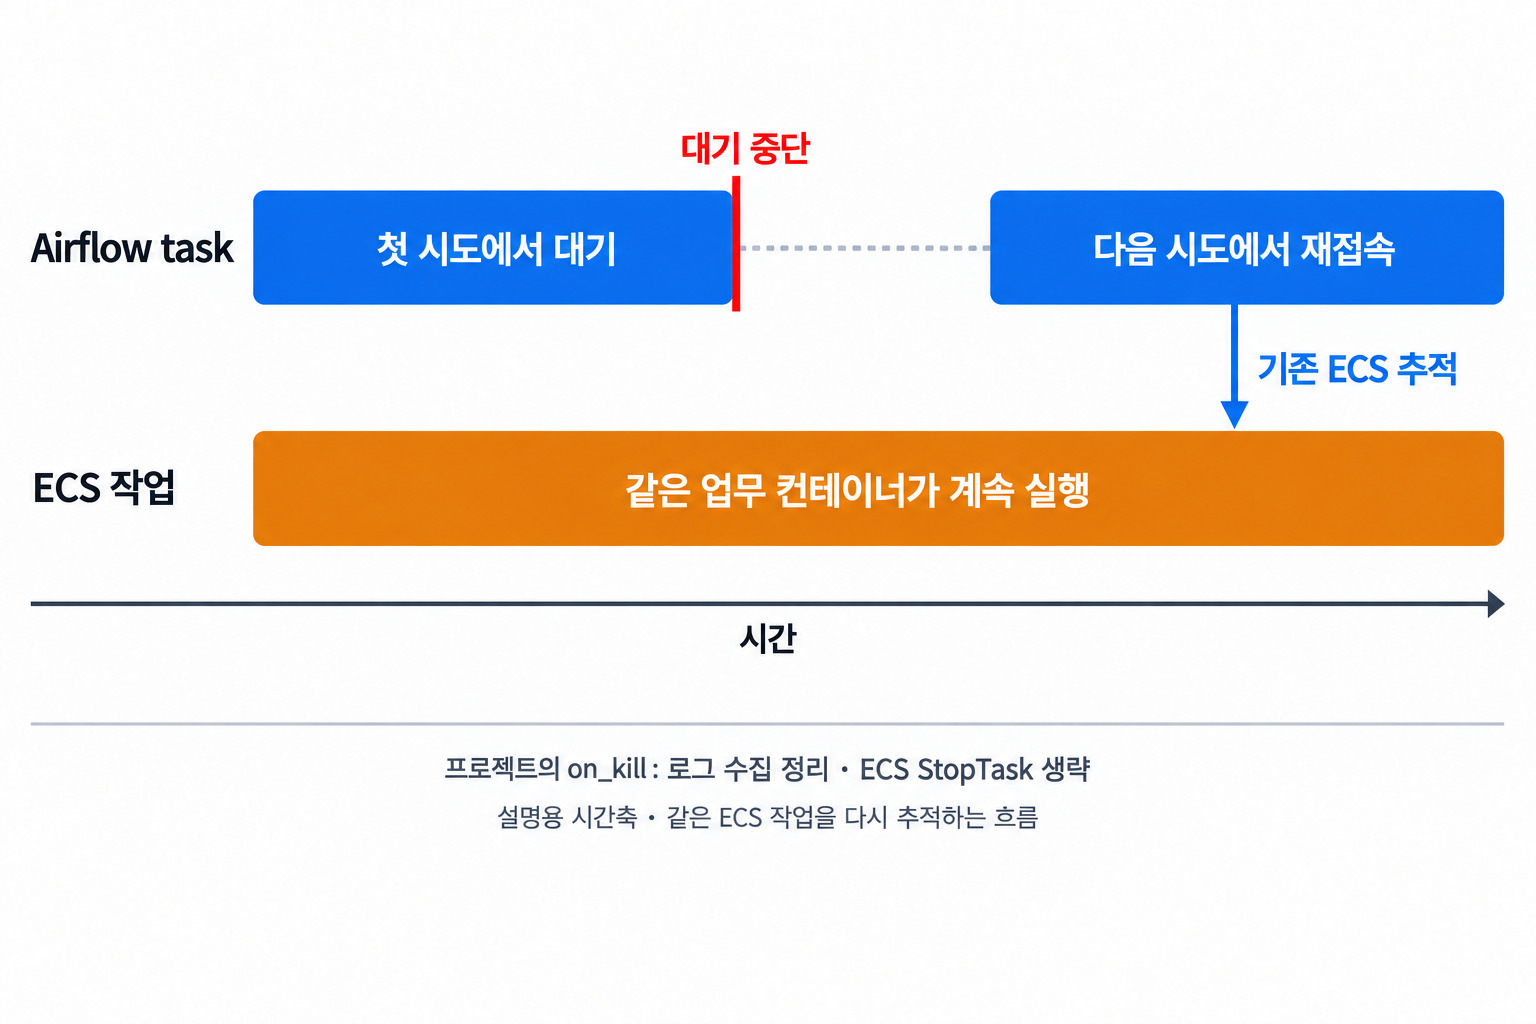 Airflow 대기가 끝났다는 이유로 ECS 업무를 다시 시작하지 않는다
기존 실행의 상태를 확인한 뒤 재접속과 재실행을 나눴다
EdgeStep은 제출 전에 기존 태스크를 조회하고, 실행 중인지, 종료됐는지, 업무를 시작하지 못했는지를 나눴다. STOPPED는 작업이 멈췄다는 상태이므로, 성공 여부는 종료 코드와 중단 사유로 판단했다.
자동 재시도에서 새 업무를 허용하는 근거는 기동 실패나 업무 미시작의 확인이다. 반대로 업무가 일부 수행됐을 수 있다면, 종료 결과를 사용하거나 확인할 때까지 보류한다. 단순히 Airflow가 실패했다는 표시만으로 이 둘을 구분할 수는 없다.
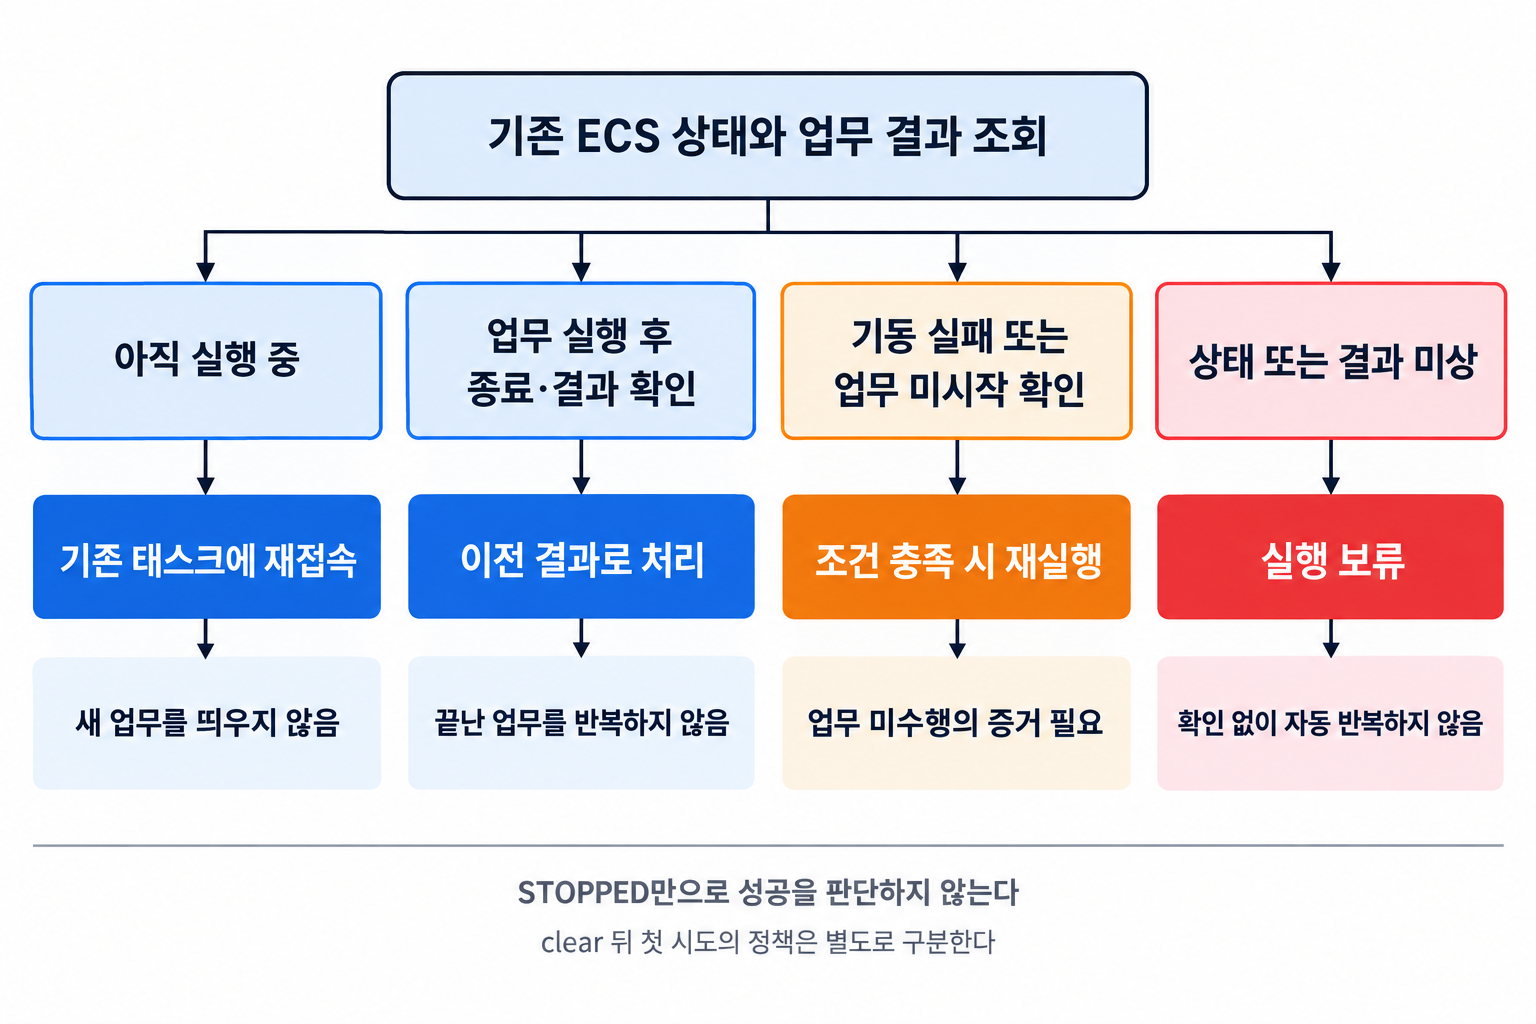 업무 미시작이 확인된 경우와 이미 수행됐을 수 있는 경우를 나눠 재실행을 결정한다
ECS 제출에는 시도·제출별 clientToken도 넣었다. 같은 제출 요청이 통신 문제로 재전송될 때 중복 태스크가 생기는 것을 줄이기 위한 장치다. 하지만 토큰만으로 외부 API 호출과 DB·파일 쓰기까지 정확히 한 번 수행된다고 보장할 수는 없다.
RunTask 응답을 받지 못하면 같은 task instance의 startedBy로 태스크를 찾아 재접속한다. 조회해도 찾지 못했을 때는 “제출하지 않았다”로 바꾸지 않고 상태 불명으로 보류한다. 앞선 요청이 처리됐지만 아직 조회되지 않거나, 이전 실행 기록을 더 이상 확인할 수 없는 경우와 구분할 수 없기 때문이다.
자동 재시도와 clear — 결과를 재사용해야 하는 요청이 다르다
자동 재시도는 기존 업무의 결과를 놓친 상황을 복구하는 경우가 많다. 반면 Airflow에서 끝난 task를 clear하는 것은 작업을 다시 수행하려는 명시적 요청일 수 있다. 두 경우 모두 이전 결과를 무조건 재사용하면, 변경된 입력을 정제하거나 새 보류 상태를 보고해야 하는 작업까지 건너뛰게 된다.
프로젝트는 자동 재시도에서 완료된 앞 시도의 결과를 재사용했다. 명시적으로 끝난 task를 clear했을 때는 성공한 수집 결과를 재사용하고, 정제·적재 등은 종료를 확인한 뒤 다시 수행하도록 구분했다. 수집은 외부 API를 다시 부르는 비용이 있고, 정제·적재는 갱신된 입력을 반영해야 하기 때문이다.
실행 중인 task를 clear해도 새 업무는 시작하지 않는다. 업무를 다시 수행하려면 기존 실행이 끝난 뒤 다시 clear해야 한다.
결과를 모를 때는 수집 공백을 감수하고 재실행을 보류했다
업무 컨테이너에는 같은 작업의 실행을 겹치지 않게 하는 PostgreSQL 세션 락이 있다. 하지만 락 연결이 끊겨도 업무 프로세스는 살아서 쓰기를 계속할 수 있다. 다음 컨테이너가 락을 얻었다는 사실만으로 이전 작업의 종료를 증명할 수는 없었다.
그래서 락을 얻은 뒤에도 원장에서 같은 작업의 미종료 시도와 미해결 보류를 확인한다. 앞선 실행이 끝났는지 모르면 새 컨테이너는 업무를 시작하지 않고 종료 코드 76으로 멈춘다. 이미 실행 중인 프로세스의 쓰기를 저장소에서 거부하는 fencing을 구현한 것은 아니며, 새 업무가 겹쳐 시작되는 것을 막는 정책이다.
보류도 모두 같은 의미는 아니다. ECS 실행 상태 불명인 ECS_STATE_UNKNOWN은 이전 작업이 아직 데이터를 쓰는지 확인하지 못하는 상태이고, 결과 미상인 RESULT_UNKNOWN은 종료는 확인했지만 어느 결과를 남겼는지 모르는 상태다.
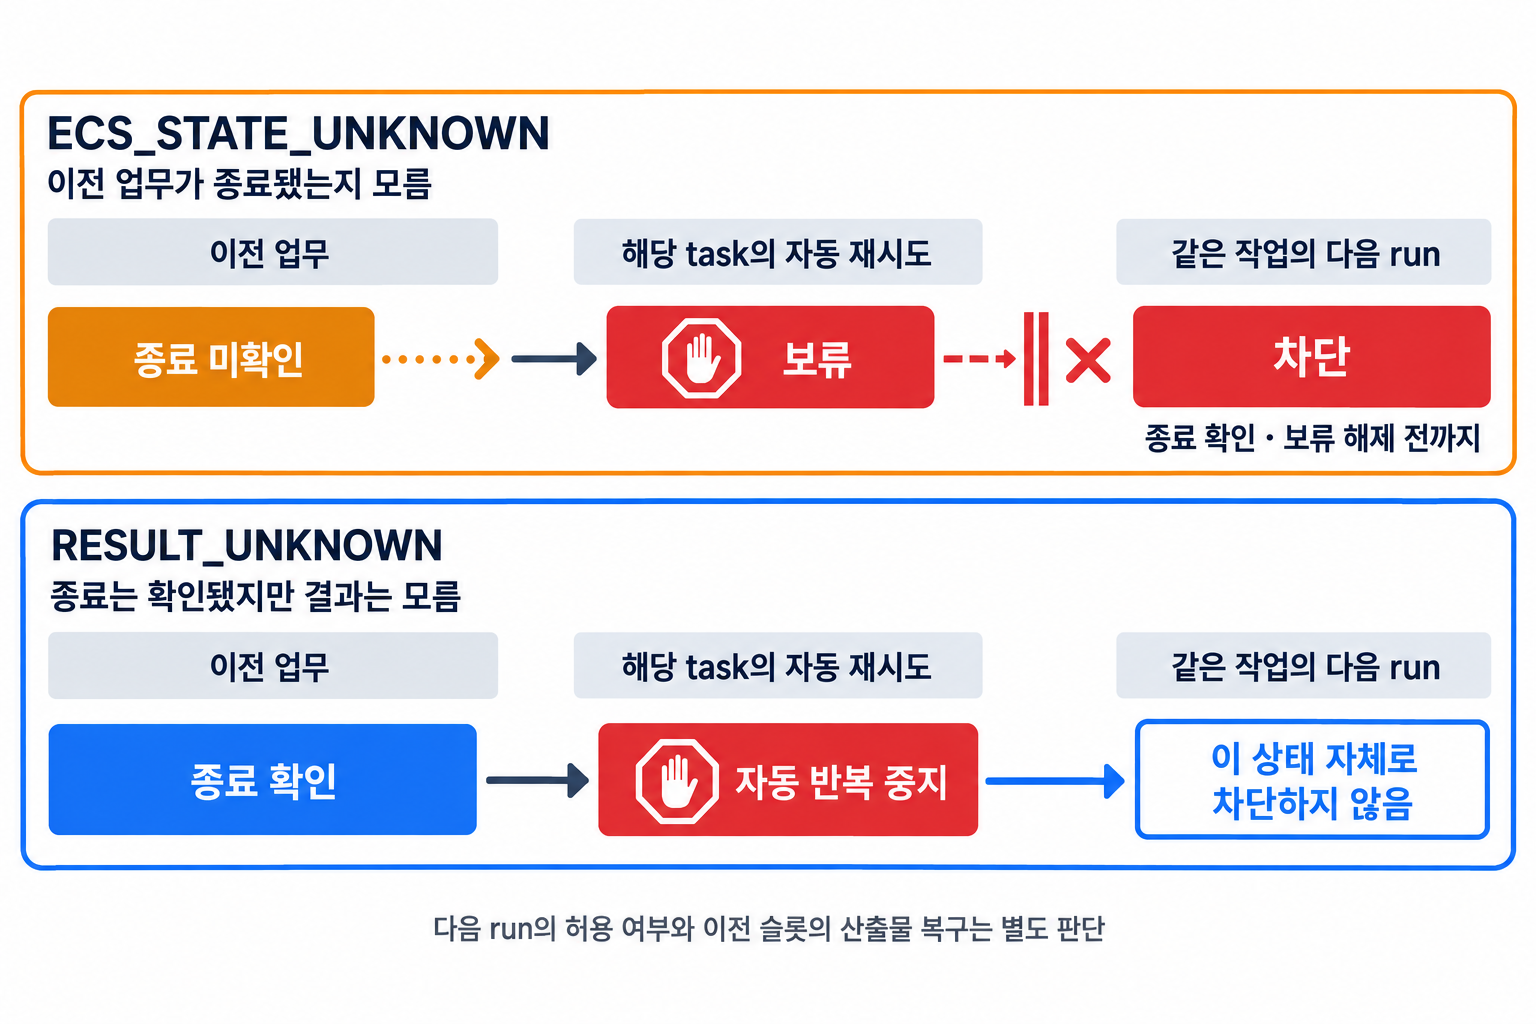 이전 작업의 종료를 모르는 보류와 결과만 모르는 보류는 다음 run에 미치는 영향이 다르다
RESULT_UNKNOWN으로 남은 슬롯은 다음 run의 시작 여부와 별개로, 산출물이 어디까지 만들어졌는지 확인해 복구해야 한다.
이관 첫 단계에서는 저장소의 쓰기 세대 관리와 강제 차단을 추가하지 않고, 확인되지 않은 실행을 보류하기로 했다. 실행 상태가 불명인 보류는 종료를 확인한 뒤 수동으로 해제해야 하므로, 그동안의 수집 공백을 감수했다.
장중 수급 API는 과거 날짜를 지정해 같은 시점의 데이터를 다시 수집하는 방식도 아니었다. DAG를 멈춘 동안의 슬롯을 나중에 모두 실행하는 catchup을 껐고, 놓친 슬롯은 공백으로 남겼다. 당일 누적 응답으로 다음 슬롯에서 상당 부분을 회수할 수 있어도, 모든 공백이 복구된다고 가정하지 않았다.
수동 복구에서는 먼저 ECS의 실제 종료와 원장 기록을 대조한다. StopTask 요청을 보낸 것과 STOPPED를 확인한 것을 구분하고, 산출물을 확인한 뒤 보류를 해제하거나 정제·적재를 재처리한다. 상태를 확인하지 못하면 수집을 비워 두는 쪽을 택했다.
재접속과 보류 해제 후 복구를 격리 환경에서 확인했다
로컬에서는 ECS 등 외부 응답을 대체한 환경에서 DAG와 실행 정책을 검사했다. 이후 AWS에서는 기존 장중 수급 raw 하나를 읽어 전용 검증 버킷으로 복사하고, 검증용 태스크와 DB에만 산출물을 쓰는 격리 시험을 진행했다. 실제 외부 공급자를 반복 호출한 운영 부하 시험은 아니다.
AWS 시험에서는 ECS 태스크 수, 업무 시작 횟수, 원장의 시도와 최종 상태, 파티션 쓰기 기록을 함께 대조해 중복 실행 여부를 확인했다.
2026년 9월 30일의 복구·보류 시험에서 확인한 동작은 다음과 같다.
| 시험 조건 | 실행에서 확인한 동작 | 확인한 결과 |
|---|---|---|
| 정제 대기 중 Airflow 서비스 강제 재배포 | 기존 정제 ECS 태스크 추적 | 정제 태스크 1개·업무 시작 1회, 원장 성공 |
| 제출 응답 유실과 조회 실패 | 실행 상태 불명으로 보류 | 수집 ECS는 실제로 1개 실행, 추가 제출하지 않음 |
| 보류가 남아 있는 상태에서 새 run | 새 수집 컨테이너가 게이트에서 중단 | exit 76, 업무 시작 0회 |
| 관련 태스크의 STOPPED 확인 후 보류 해제 | 다음 run 재개 | 정상 종료와 산출물 확인 |
응답 유실 시험에서 Airflow는 결과를 알 수 없어 보류했지만, 실제 수집 태스크는 종료 코드 0으로 끝났다.
복구 시나리오는 통과했지만, ECS 종료부터 Airflow task 종료까지의 지연 p95는 32.5초로 기준 30초를 넘었다. heartbeat 관측에도 도구 문제로 공백이 생겼다.
종료 감지 지연 — 업무가 끝나도 로그 수집 스레드를 기다렸다
당시 operator는 ECS 태스크가 끝난 뒤 로그 수집 스레드를 멈추고 join했다. 이 스레드의 기본 로그 조회 간격이 30초라, 이미 끝난 업무를 Airflow가 마감하는 데 기다림이 추가됐다. 업무 처리시간과 오케스트레이터가 종료를 인식하는 시간을 분리해야 보이는 지연이었다.
로그 조회 간격을 조정한 뒤 10월 1일 실제 AWS에서 heartbeat와 종료 감지를 다시 검증해 두 항목이 통과했다. 장중 수급 DAG 하나의 정상 실행을 검사한 결과로, 추가 배치 수용량은 검증하지 않았다.
장중 수급은 10월 3일 Airflow 상시 운영으로 전환했다
격리 시험 뒤 실제 전환은 2026년 10월 3일 AWS 개발 환경에서 완료했다. 전환 PR #1105가 병합되면서 장중 수급의 실행 주체를 AIRFLOW로 바꾸고, 기존 Step Functions를 시작하던 스케줄 다섯 개를 비활성화했다. 이어 edge_investor_intraday DAG를 활성화했으며, 결과는 PR #1113에 남겼다.
전환 전에 원장의 실행 중 시도, 살아 있는 관련 ECS 태스크, 실행 중인 Step Functions와 Airflow run, 미해결 보류를 확인했다. 두 실행 주체가 같은 작업을 맡는 순간을 만들지 않기 위한 절차였다. Step Functions 상태 머신 자체는 롤백을 위해 남겼다.
장중 수급의 실행 주체는 현재 원격 코드에서도 Airflow다. 이번 전환 범위는 AWS 개발 환경의 장중 수급 배치다.
신규 원천 관측 DAG도 매일 실행하도록 별도로 활성화했다. 첫 정기 실행은 데이터를 적재했지만 일부 정제 판정 때문에 FAILED로 끝났다. 후속 PR #1118에서는 예정된 run이 아예 생성되지 않은 경우도 원장에서 감지하도록 보완했다.
롤백도 스케줄을 반대로 켜는 조작만으로 끝나지 않는다. Airflow DAG를 pause해도 이미 실행 중인 ECS 업무가 멈추지는 않는다. 기존 작업의 종료와 보류를 확인한 뒤 Step Functions 경로를 다시 켜야 하며, 특히 그 경로는 Airflow의 보류 게이트를 그대로 거치지 않으므로 전환 절차가 중요하다.
전환 완료는 병합된 설정 변경과 활성화 결과로 확인했다. 전환 뒤 모든 거래일의 실행 성공률과 장기 안정성은 추가 관측이 필요하다.
프로젝트의 종료 정책을 선택 가능한 Airflow 옵션으로 제안했다
프로젝트에서 필요했던 종료 동작은 Airflow가 대기를 끝낼 때 ECS 업무를 계속 둘 수 있게 하는 것이었다. 당시에는 EcsRunTaskOperator.on_kill()을 직접 재정의해야 했다. 이 선택을 DAG에서 옵션으로 지정할 수 있도록 stop_task_on_kill을 upstream에 제안했다.
기본값은 True로 기존 종료 동작을 유지한다. False이면 로컬 로그 수집을 정리한 뒤 ECS StopTask 요청을 생략한다. 대기 오류를 다루는 기존 stop_task_on_failure와는 독립된 옵션이다.
리뷰에서는 ECS client나 task ARN이 없더라도 로그 수집 정리가 누락되지 않아야 한다는 점을 보완했다. 로그 스레드를 정리하는 코드를 client·ARN 검사보다 앞으로 옮기고, 두 정보가 없는 경우의 회귀 테스트를 추가했다. 관련 ECS 테스트 117개가 통과한 결과를 PR에 남겼다.
이 옵션은 워커가 실제로 on_kill()을 호출하는 경로에 적용된다. 워커가 갑자기 사라져 콜백을 실행하지 못한 경우까지 정리를 보장하지 않으며, 비동기 대기로 넘긴 뒤의 취소 동작 전체를 바꾸는 것도 아니다. 계속 실행하도록 남겨 둔 ECS 작업은 별도로 관측하고 정리해야 한다.
PR #74129는 2026년 10월 11일 확인 기준 리뷰 승인을 받은 열린 PR이며, 아직 병합되지 않았다. AI 공동 작성 사실은 PR에 명시했다. upstream 검증은 실제 AWS 리소스를 사용하지 않았고, 응답을 대체한 테스트와 로컬 실행 검증이었다.
upstream에는 종료 옵션을 제안했고, 재접속·업무 원장·보류 해제·중복 실행 방지 정책은 EDGE에 남겼다.
마무리
Airflow 전환에서 먼저 정한 것은 재시도 횟수보다 다시 실행할 수 있는 조건이었다. 실행 중이면 재접속하고, 완료된 업무의 결과를 놓쳤다면 그 결과를 사용하며, 실행 여부나 결과를 모르면 확인할 때까지 자동 반복을 멈췄다.
중복 실행 가능성을 줄이기 위해 자동 복구 범위를 줄이고 수집 공백을 감수했다. 기존 작업자의 쓰기를 강제로 차단할 수 없는 상태였으므로, 종료 증거와 산출물을 확인한 뒤 복구하도록 했다.
장중 수급의 실제 전환까지 마친 뒤에도 Airflow의 상태와 업무 결과를 구분하는 원칙은 유지된다. task가 끝났다는 표시보다 어떤 업무가 시작됐고, 무엇을 썼으며, 어느 결과로 종료됐는지가 다음 실행의 근거다.