Airflow DAG와 실행 모델
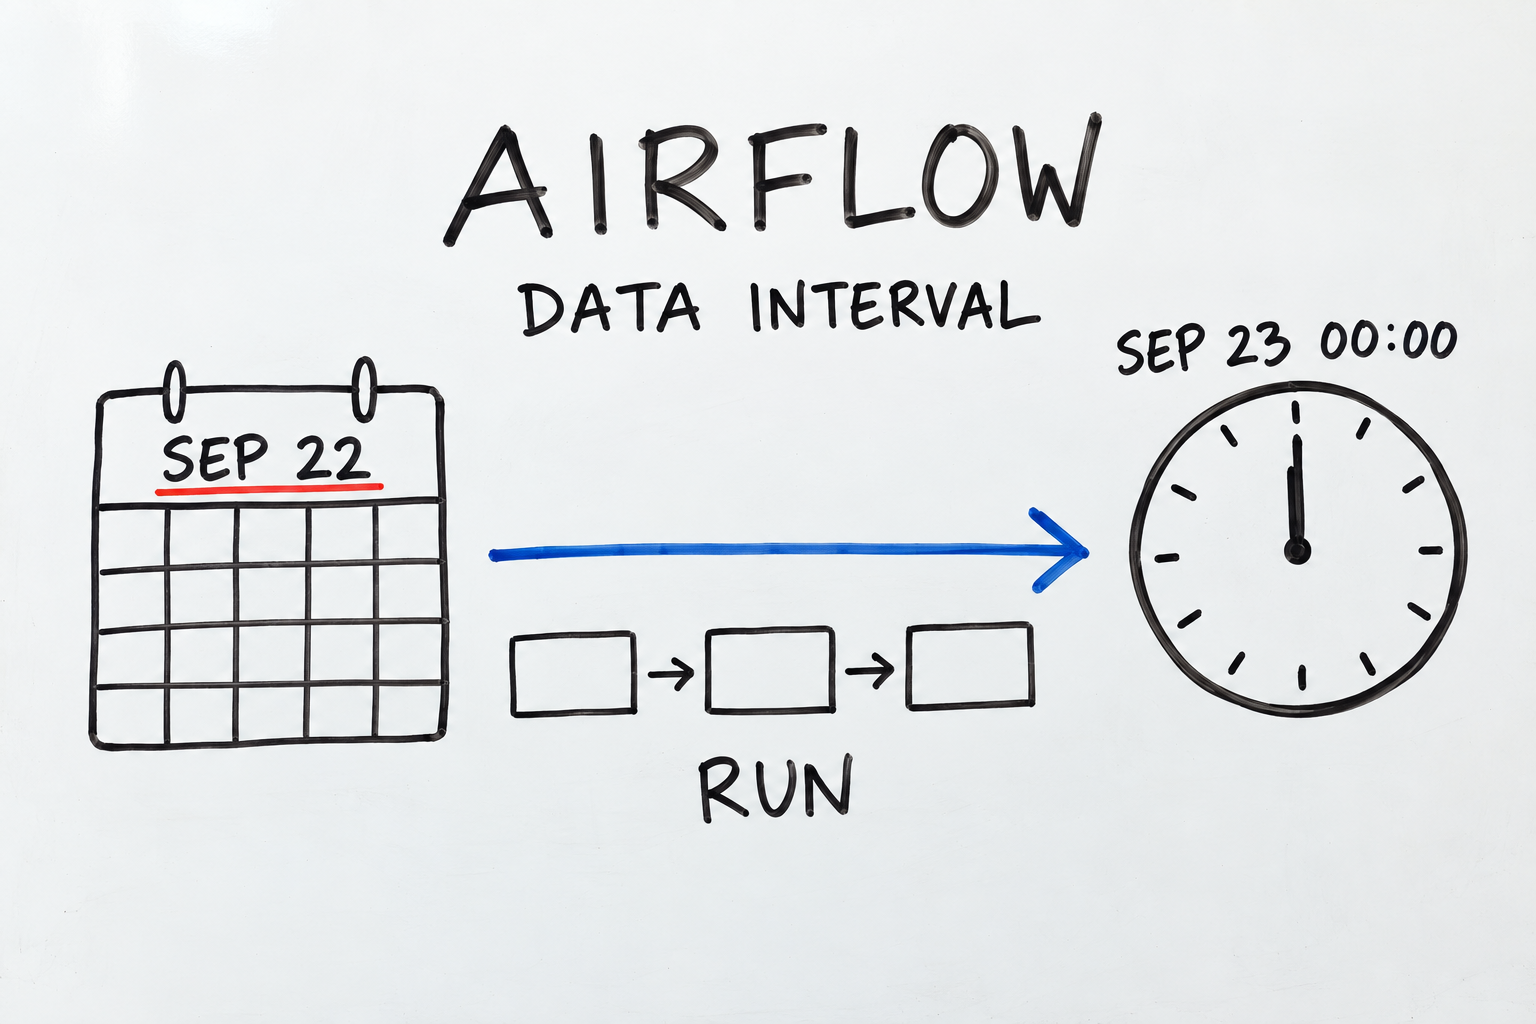
Airflow는 여러 작업으로 이뤄진 워크플로를 코드로 정의하고 실행을 관리하는 플랫폼이다. 데이터 수집·가공·저장처럼 여러 단계가 이어지는 파이프라인에서 각 작업을 언제, 어떤 조건으로 실행할지 조정한다.
정해진 시각에 시작하는 것만으로는 이런 흐름을 운영하기 어렵다. 앞 단계가 끝나야 다음 단계를 진행할 수 있고, 실패하면 다시 실행할 대상을 찾아야 한다. 매일 반복하는 작업이라면 어느 날짜의 처리가 끝났는지도 구분해야 한다.
Airflow는 작업 사이의 관계를 정의한 DAG와 그 정의에서 만들어진 개별 실행을 나눠 관리한다. 여기에 각 실행이 처리할 데이터 구간을 연결하면, 작업의 순서와 실패 상태뿐 아니라 무엇을 다시 처리해야 하는지도 설명할 수 있다.
DAG는 작업이 실행되기 위한 조건을 연결한다
매일 전날 매출을 집계하는 흐름을 가정해보자. 주문을 수집한 뒤 누락된 값이 없는지 검증하고 금액을 집계한다. 검증과 집계가 모두 성공하면 결과를 공개하려 한다.
이 흐름에서 수집·검증·집계·공개는 각각 하나의 Task다. 작업 사이에는 기다려야 할 관계가 있다. 검증과 집계는 수집이 끝나기를 기다리고, 공개는 검증과 집계의 성공을 기다린다.
이처럼 작업을 점으로, 작업 사이의 의존성을 화살표로 나타낸 구조가 DAG다. Directed Acyclic Graph의 약자로, 방향이 있고 순환이 없는 그래프라는 뜻이다. Airflow의 DAG에는 이 구조와 함께 스케줄이나 재시도 같은 실행 설정도 담긴다.
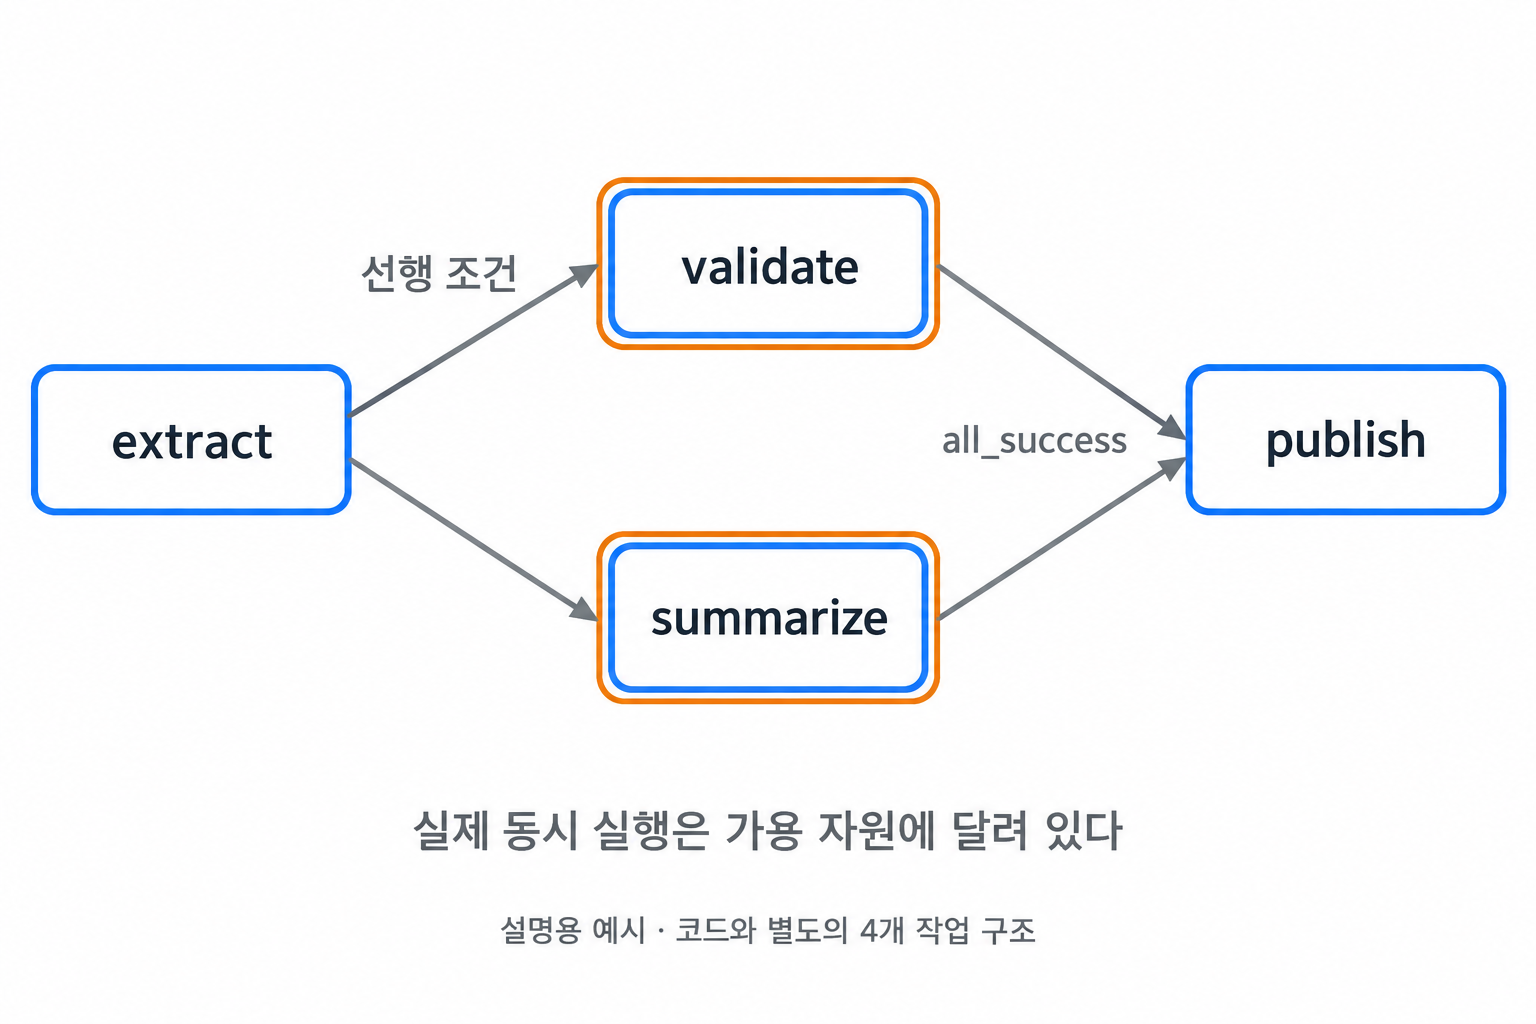
수집 뒤 검증과 집계가 모두 성공해야 결과를 공개한다
그림의 validate와 summarize 사이에는 선후 관계가 없다. extract가 성공하면 둘 다 실행할 수 있고, publish는 기본 설정에서 두 작업의 성공을 기다린다. 따라서 화살표는 정확한 시작 시각보다 다음 단계가 기다릴 조건을 나타낸다.
실행 조건을 만족했다고 해서 두 작업이 반드시 같은 순간에 시작하는 것은 아니다. 작업을 실행할 자리가 부족하거나 동시 실행 수가 제한되어 있다면 한쪽은 기다릴 수 있다. 의존성은 병렬 실행이 가능한지를 정하고, 실제 시작 시점은 실행 자원의 영향도 받는다.
순환이 없다는 조건도 이 의존성에 관한 말이다. A → B → A로 연결하면 A는 B를, B는 A를 기다리게 된다. 반면 같은 DAG를 내일 다시 실행하거나 실패한 작업을 재시도하는 것은 기존 그래프에 순환 의존성을 추가하는 일이 아니다.
같은 DAG를 실행해도 실행 이력은 각각 남는다
DAG는 작업 흐름의 정의이므로 한 번 작성해서 여러 번 실행할 수 있다. 레시피 하나로 여러 끼를 만들 수 있는 것과 같다. Airflow는 DAG를 한 번 실행하는 단위를 Dag Run이라고 부른다.
일별 매출 집계라면 9월 22일 데이터를 처리하는 실행과 9월 23일 데이터를 처리하는 실행이 각각 존재한다. 같은 DAG를 사용해도 한쪽은 성공하고 다른 쪽은 실패할 수 있다. 정의가 같다는 이유로 실행 상태까지 하나로 묶이지는 않는다.
작업에도 같은 구분이 필요하다. DAG 안의 summarize는 집계를 하라는 작업 정의이고, 특정 Dag Run에 속해 실제로 실행되는 summarize는 Task Instance다. 성공·실패와 같은 상태를 갖는 것은 이 개별 실행 단위다.
| 구분 | 정의 | 개별 실행 |
|---|---|---|
| 전체 흐름 | DAG | Dag Run |
| 흐름 안의 작업 | Task | Task Instance |
| 매출 집계 예시 | 매일 사용할 집계 절차 | 특정 날짜 구간을 처리한 이력 |
예를 들어 “집계가 실패했다”는 말만으로는 재실행 대상을 찾기 어렵다. “9월 23일 데이터 구간을 처리하는 Dag Run에서 summarize Task Instance가 실패했다”라고 하면 어떤 실행의 어느 단계를 살펴봐야 하는지 분명해진다.
작업을 만드는 방법은 여러 가지다. SQL 실행이나 명령 실행처럼 정해진 종류의 작업을 만들 때 사용하는 틀이 Operator다. 직접 작성한 Python 함수를 작업으로 만들 수도 있는데, 뒤의 코드에서 사용하는 @task가 그 방식이다.
실행 시각과 처리할 데이터 구간은 다르다
전날 매출을 집계하려면 하루 동안의 주문이 모인 뒤 작업을 시작해야 한다. 한국 시간으로 9월 23일 00시에 시작한다면, 처리할 주문은 9월 22일 00시부터 9월 23일 00시 직전까지다.
이때 작업이 시작된 시각은 9월 23일이지만 처리 대상은 9월 22일이다. Airflow에서는 이렇게 한 실행이 담당하는 시간 범위를 data interval, 데이터 구간으로 표현한다. 실행 시각과 처리 범위를 나누면 작업이 늦게 시작되더라도 무엇을 처리할지 유지할 수 있다.
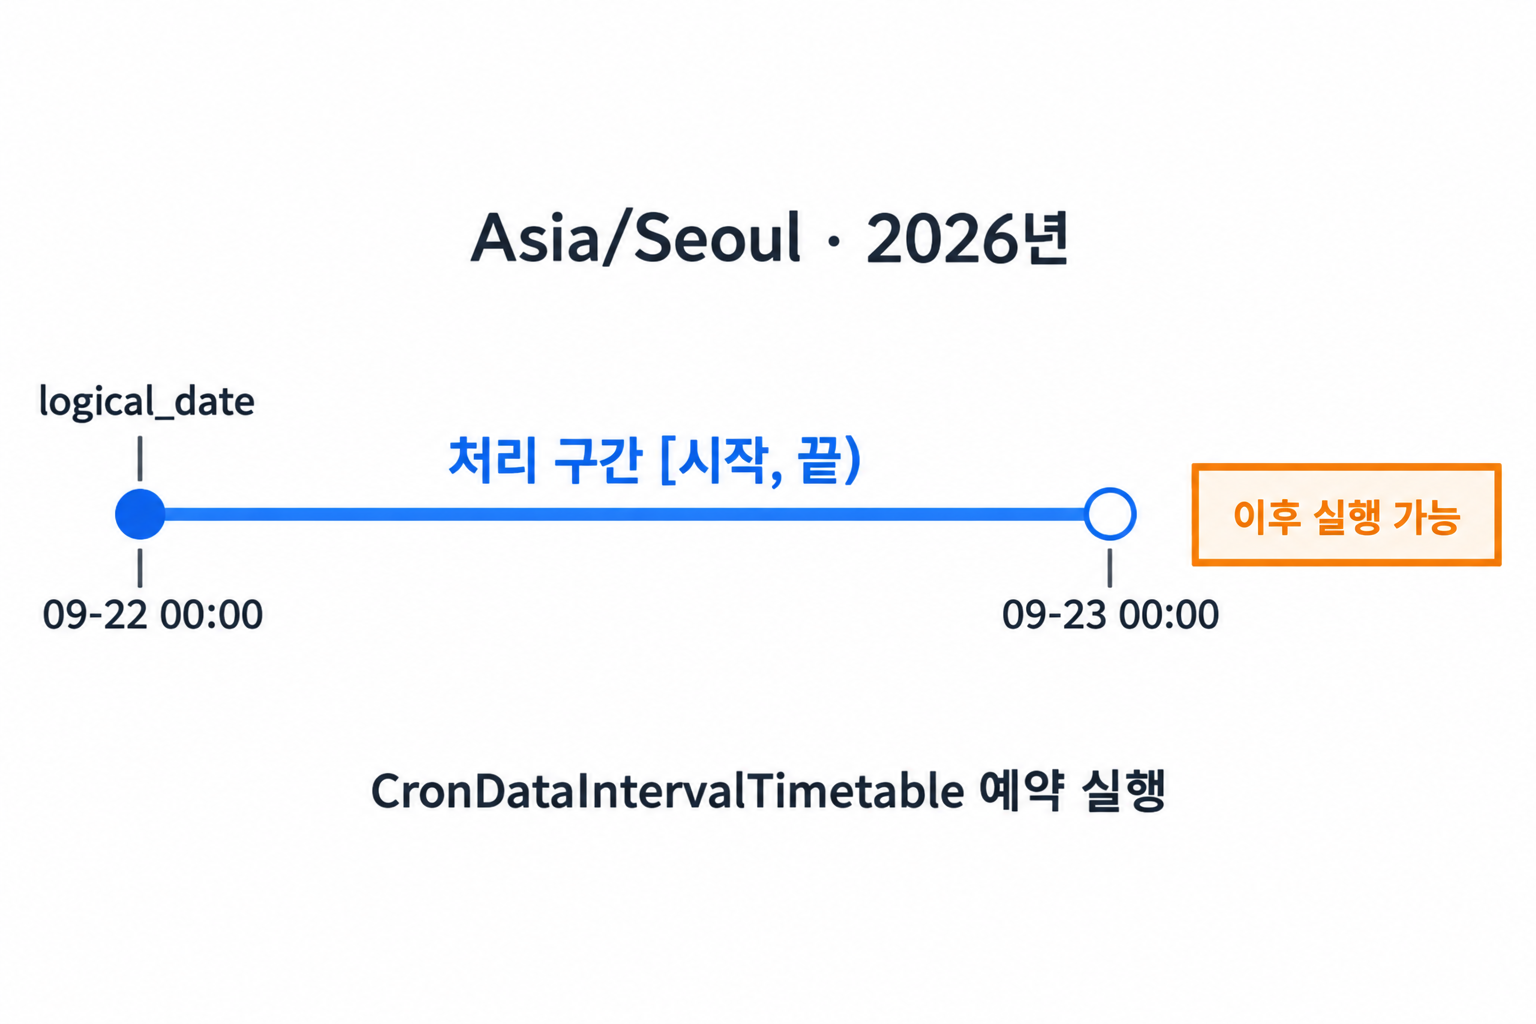
데이터 구간이 끝난 다음 해당 구간의 작업을 실행할 수 있다
이 예시에서는 하루 구간이 끝난 뒤 실행을 예약하는 CronDataIntervalTimetable을 사용한다. 구간의 시작은 data_interval_start, 끝은 data_interval_end로 확인한다. 시작을 포함하고 끝을 제외해 주문을 조회하면 인접한 날짜 구간이 같은 경계의 주문을 중복으로 읽는 것을 피할 수 있다.
그림에 나온 logical_date는 이 시간표의 예약 실행에서 데이터 구간의 시작을 가리킨다. 실제 시작 시각을 뜻하는 값은 아니다. 다른 시간표나 수동 실행에서는 의미가 달라질 수 있으므로, 처리 범위를 정할 때는 해당 실행의 데이터 구간을 확인해야 한다.
DAG 설정의 start_date와 schedule도 함께 읽어야 한다. 이 예시에서 start_date는 첫 데이터 구간을 잡는 기준이고, schedule은 구간과 실행 시점을 계산하는 규칙이다. 실제 작업은 구간이 끝난 뒤 실행할 수 있으며, 실행 자원 상황에 따라 더 늦게 시작할 수도 있다.
Python 함수로 작업과 의존성을 정의할 수 있다
Python 함수를 Airflow의 작업으로 만들고 함수 사이에 결과를 전달하는 방식이 TaskFlow다. 함수에 @task를 붙여 작업을 정의하고, 다른 작업의 결과를 인자로 넘기면 Airflow가 그 관계를 의존성으로 연결한다.
아래는 수집·합산·출력 세 단계로 단순화한 학습용 예시다. 가상의 금액 목록만 사용하며 실제 주문 조회나 DB 저장은 하지 않는다. 코드의 API 기준은 Airflow 3.3.2다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
from datetime import timedelta

import pendulum
from airflow.sdk import CronDataIntervalTimetable, dag, task


@dag(
    dag_id="daily_sales_example",
    start_date=pendulum.datetime(2026, 9, 22, tz="Asia/Seoul"),
    schedule=CronDataIntervalTimetable(
        "0 0 * * *", timezone="Asia/Seoul"
    ),
    catchup=False,
    default_args={
        "retries": 2,
        "retry_delay": timedelta(minutes=1),
    },
    tags=["learning"],
)
def daily_sales_example():
    @task
    def extract():
        return [12000, 18000, 5000]  # 학습용 가상 금액

    @task
    def summarize(amounts: list[int]):
        return sum(amounts)

    @task
    def report(total: int):
        print(f"example_total={total}")

    report(summarize(extract()))


daily_sales_example()
extract가 금액 목록을 만들고 summarize가 합산한 뒤 report가 합계를 출력하도록 연결한다. 앞의 검증·공개 예시와 달리 이 코드에는 세 작업이 있다. 날짜 구간별 조회를 구현하지 않았으므로 어느 구간을 처리하든 같은 학습용 입력을 사용한다.
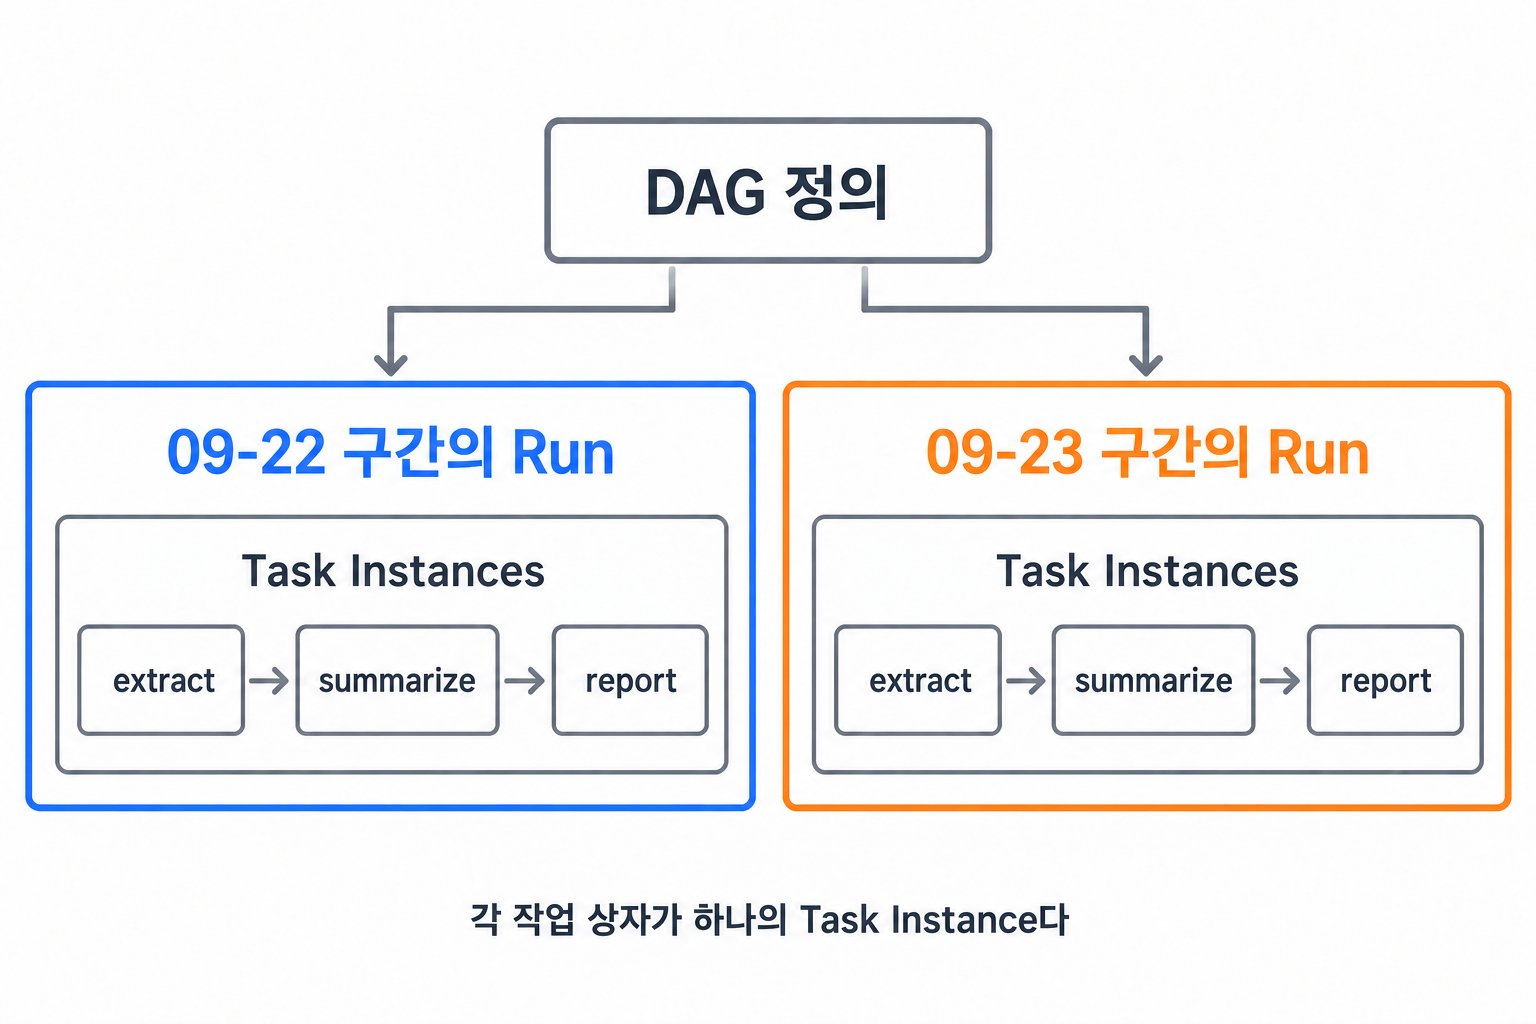
DAG 정의 하나에서 여러 Dag Run이 만들어지고 각 실행은 세 작업의 Task Instance를 따로 갖는다
중첩된 함수 호출은 평범한 Python 코드처럼 보이지만, DAG를 구성할 때 세 함수의 업무 로직을 바로 실행하는 것은 아니다. extract()의 반환값 참조를 summarize에 넘기고, 그 결과 참조를 report에 넘겨 작업 관계를 만든다. 실제 값은 각 작업이 실행될 때 전달된다.
Airflow는 DAG 파일에서 이런 정의를 읽는 단계와 작업을 실행하는 단계를 구분한다. 실행 시점과 조건을 확인해 작업을 고르는 역할은 Scheduler가 맡고, 선택된 작업은 실행 환경에서 수행된다. DAG 파일을 등록하는 것과 그 안의 작업을 한 번 실행하는 것은 별개의 일이다.
다만 파일의 최상위에 놓인 일반 Python 코드는 DAG를 읽는 과정에서도 실행될 수 있다. 따라서 외부 API 조회나 대량 데이터 처리처럼 실제 업무에 해당하는 코드는 작업 함수 안에 둔다. 위 예시도 금액 목록을 만들고 합산하는 로직은 각각의 @task 함수 안에 있다.
실패한 작업을 재시도하는 것과 과거 구간을 채우는 것은 다르다
작업 중 외부 연결이 잠깐 끊겼다면 같은 작업을 다시 시도해서 복구할 수 있다. 이것이 retry, 재시도다. 예시의 retries=2는 최초 시도 뒤 최대 두 번 더 시도할 수 있다는 뜻이며, DAG 전체를 처음부터 세 번 실행한다는 뜻은 아니다.
한편 며칠 동안 스케줄이 중단되어 실행 자체가 빠졌다면 문제의 단위가 달라진다. 누락된 데이터 구간마다 실행을 만들어 따라잡는 기능이 catchup이다. 예시의 catchup=False는 과거 구간을 모두 자동으로 채우지 않겠다는 설정이다.
이미 처리한 지난달 매출을 새 집계 방식으로 다시 계산할 수도 있다. 이처럼 기간을 직접 지정해 과거 구간을 처리하는 기능이 backfill이다. Catchup을 끄더라도 필요한 기간을 명시적으로 재처리할 수 있다.
| 구분 | 다시 처리하는 대상 | 예시 |
|---|---|---|
| Retry | 실패한 작업의 추가 시도 | 잠깐 끊어진 연결에 재접속한다 |
| Catchup | 스케줄상 빠진 과거 구간 | 중단 중 놓친 일별 집계를 자동으로 채운다 |
| Backfill | 직접 지정한 과거 범위 | 집계 로직을 고친 뒤 지난달을 다시 계산한다 |
이 셋을 구분하면 “다시 돌린다”는 요청도 구체적으로 바뀐다. 실패한 작업을 복구할 것인지, 빠진 실행을 만들 것인지, 이미 처리한 기간까지 다시 계산할 것인지에 따라 방법을 고를 수 있다.
과거 실행을 만들 수 있다고 해서 당시의 데이터까지 복원되는 것은 아니다. 지난달을 다시 계산하려면 그때 처리해야 할 원천 데이터가 남아 있어야 한다. Airflow의 실행 관리와 입력 데이터의 보관은 함께 설계해야 한다.
작업 사이의 데이터 전달은 따로 설계해야 한다
DAG의 화살표는 작업의 의존성을 나타내므로 선 하나를 연결했다고 원본 데이터까지 자동으로 옮겨지는 것은 아니다. 작업은 서로 다른 실행 환경에 배치될 수 있고 메모리나 로컬 파일을 공유한다고 가정할 수 없다.
Airflow에서 작은 값을 작업 사이에 전달하는 기능이 XCom이다. 앞의 TaskFlow 예시도 내부적으로 XCom을 사용해 금액 목록과 합계를 넘긴다. 정수 몇 개처럼 작은 값은 이런 방식으로 다루기 쉽다.
원본 주문 전체나 큰 DataFrame을 전달할 때는 다른 접근이 필요하다. 수집 작업이 데이터를 외부 저장소에 기록하고, 다음 작업에 저장 경로만 넘기도록 구성할 수 있다. 다음 작업은 그 경로를 받아 필요한 데이터를 직접 읽는다.
1
2
extract ── 원본 저장 ──> 외부 저장소 <── 원본 읽기 ── summarize
   └── 파일 경로 반환 ──> XCom ── 파일 경로 전달 ──────┘
이 구조에서 실제 데이터는 저장소가 보관하고 XCom은 위치와 같은 작은 정보를 전달한다. 수집 작업의 로컬 디스크에 파일을 두는 방식과 달리, 다음 작업이 다른 환경에서 실행되더라도 같은 저장 위치에 접근하도록 설계할 수 있다.
같은 구간을 재실행해도 결과가 중복되지 않아야 한다
9월 22일 매출 집계를 며칠 뒤 복구한다고 가정해보자. 주문 조회 기준으로 실행 당시의 오늘 날짜를 사용하면 원래 처리하려던 주문과 다른 데이터를 읽는다. 재실행할 때도 9월 22일 구간의 입력을 선택해야 같은 작업의 복구가 된다.
날짜뿐 아니라 입력의 내용도 중요하다. 매번 최신 파일을 읽으면 재시도 사이에 파일이 바뀔 수 있다. 날짜별 저장 위치나 고정된 입력 버전을 사용해 다시 실행할 때 무엇을 읽는지 명확하게 해야 한다.
입력을 고정한 다음에는 결과를 저장하는 방식도 봐야 한다. 같은 집계를 실행할 때마다 결과 행을 추가하면 재시도할수록 매출이 중복된다. 같은 입력으로 작업을 반복해도 의도한 최종 상태가 유지되는 성질을 멱등성이라고 한다.
일별 집계라면 날짜를 결과의 기준 키로 삼고, 같은 날짜의 결과를 교체하거나 갱신하는 방식을 고려할 수 있다. Airflow의 재시도 설정은 작업을 다시 실행할 기회를 제공하지만 외부 DB에 기록하는 방식을 자동으로 바꾸지는 않는다. 반복 실행해도 중복 반영되지 않게 만드는 책임은 작업 구현에 있다.
작업의 관계와 복구를 관리할 때 Airflow가 유용하다
스크립트 하나를 정해진 시각에 실행하면 되고 실패 복구도 단순하다면 cron 같은 스케줄러로 충분할 수 있다. 여러 단계의 성공 조건과 실행 이력을 관리하고, 누락된 날짜를 찾아 재처리해야 한다면 Airflow가 제공하는 실행 모델이 유용하다.
실시간 이벤트를 다루는 Kafka와는 역할이 다르다. Kafka로 들어오는 이벤트를 저장하고, Airflow로 저장된 데이터의 일별 집계나 과거 기간 재처리를 조정하는 구성을 생각할 수 있다. 이벤트를 계기로 워크플로를 시작할 수 있어도 Airflow 자체가 낮은 지연의 스트림 처리 엔진이 되는 것은 아니다.
도입 여부는 예약 실행이 필요하다는 사실만으로 결정하기보다, 작업 사이의 관계와 실패 이후 복구를 얼마나 관리해야 하는지에 따라 판단할 수 있다. DAG와 실행 이력이 필요한 이유가 분명할수록 Airflow가 맡을 역할도 구체적이다.
마무리
DAG는 작업과 의존성을 정의하고, Dag Run은 그 흐름의 한 번의 실행을 나타낸다. 그 안의 각 작업은 Task Instance로 실행 상태를 갖는다. 이 구분 덕분에 같은 흐름을 반복하더라도 어느 실행의 어느 단계가 실패했는지 찾을 수 있다.
데이터 구간은 실행 시각과 별개로 처리 대상을 정한다. 작업이 늦게 시작되거나 과거 실행을 다시 처리해도 원래 담당한 구간을 유지할 수 있다.
Airflow로 실행과 재처리를 관리하려면 작업의 입력과 저장 방식도 이에 맞아야 한다. 같은 구간을 다시 읽을 수 있고 결과가 중복 반영되지 않아야, 재실행이 실제 복구로 이어진다.
참고 자료
- Apache Airflow — Dags, Tasks, Operators: 작업 정의, 의존성, 개별 작업의 실행 단위
- Apache Airflow — Dag Runs, Timetables: 개별 실행과 데이터 구간, 실행 시점을 정하는 규칙
- Apache Airflow — TaskFlow tutorial, DAG File Processing: 함수로 작업을 연결하는 방법과 DAG 정의 처리
- Apache Airflow — Backfill, Best Practices, XComs: 과거 구간 재처리, 멱등한 작업 설계, 작업 간 데이터 전달
- Apache Airflow — Architecture Overview, Scheduler: 작업 실행을 조정하는 역할과 실행 자원 제약
- Astronomer — Schedule DAGs in Apache Airflow: 스케줄 설정과 실행 시각, 스트림 처리와의 역할 구분