프로메테우스와 그라파나의 역할과 모니터링 흐름
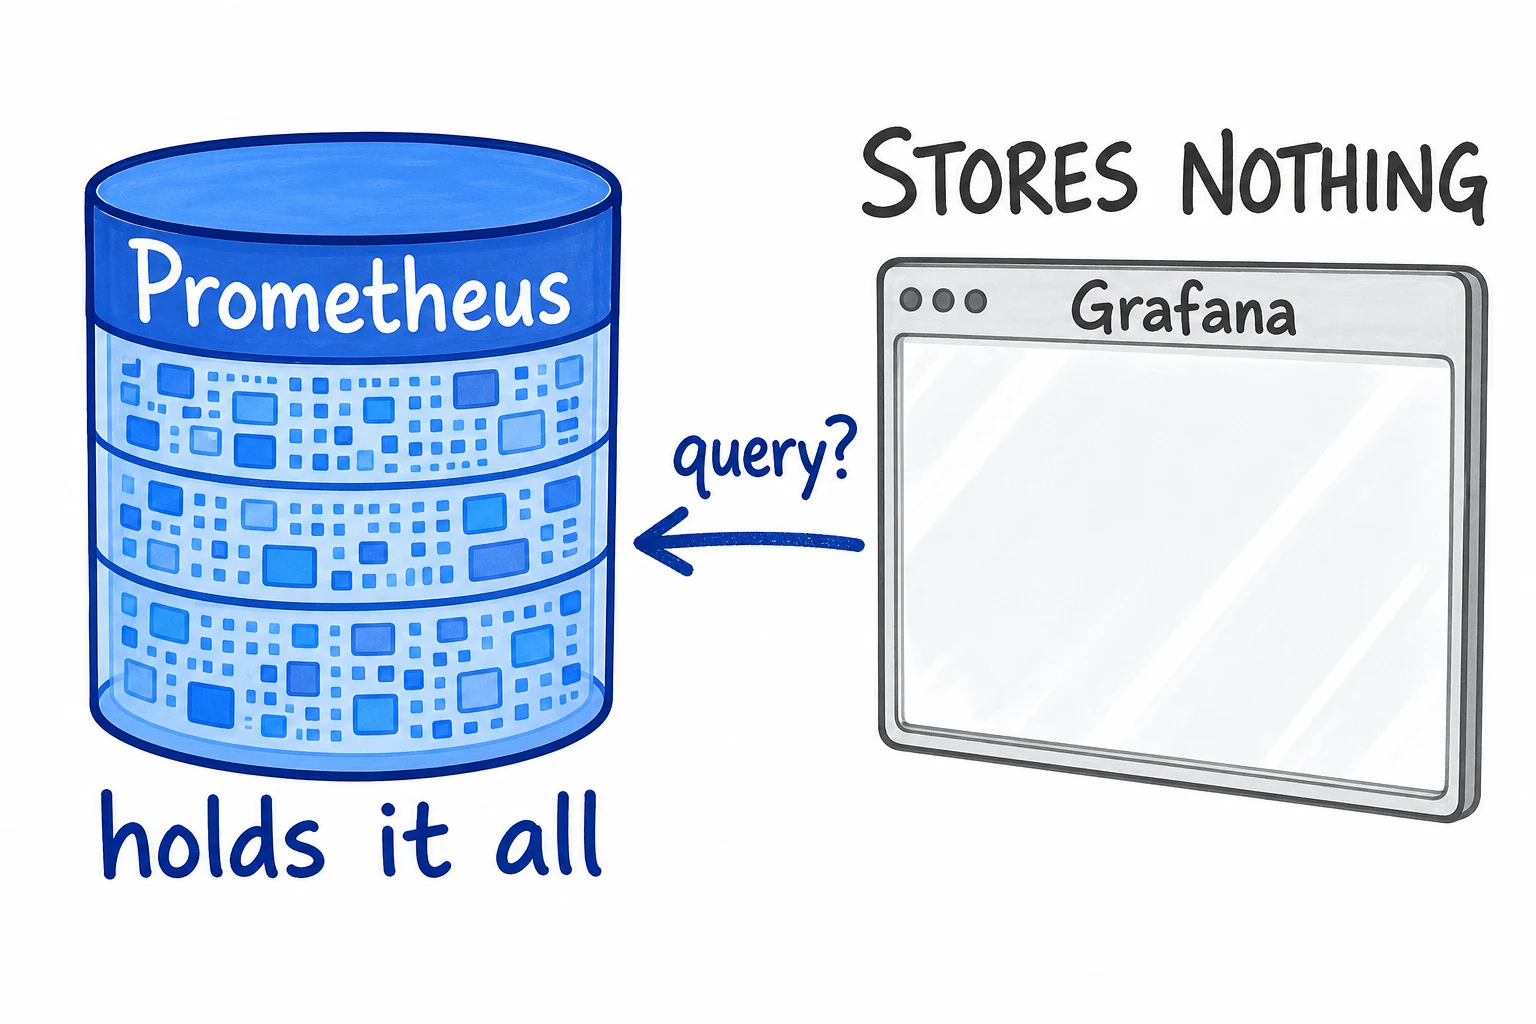
프로메테우스와 그라파나는 모니터링에서 서로 다른 역할을 맡는다. 프로메테우스는 시스템의 지표를 수집하고 저장하며, 그라파나는 저장된 데이터에 질의해 대시보드로 보여준다.
두 도구를 함께 사용하면 지표가 화면에 나타나는 흐름을 만들 수 있다. 하지만 지표가 빠졌을 때 수집 설정을 봐야 하는지, 대시보드 질의를 봐야 하는지 알려면 각 역할의 경계를 이해해야 한다.
알람도 시각화와 별도로 구분해야 한다. 프로메테우스에서 조건을 평가할 수도 있고 그라파나의 알람 기능을 사용할 수도 있다. 수집·저장·질의·알람·시각화를 나눠 보면 어떤 설정을 어디에서 관리할지 분명해진다.
프로메테우스는 지표를 저장하고 그라파나는 조회해 보여준다
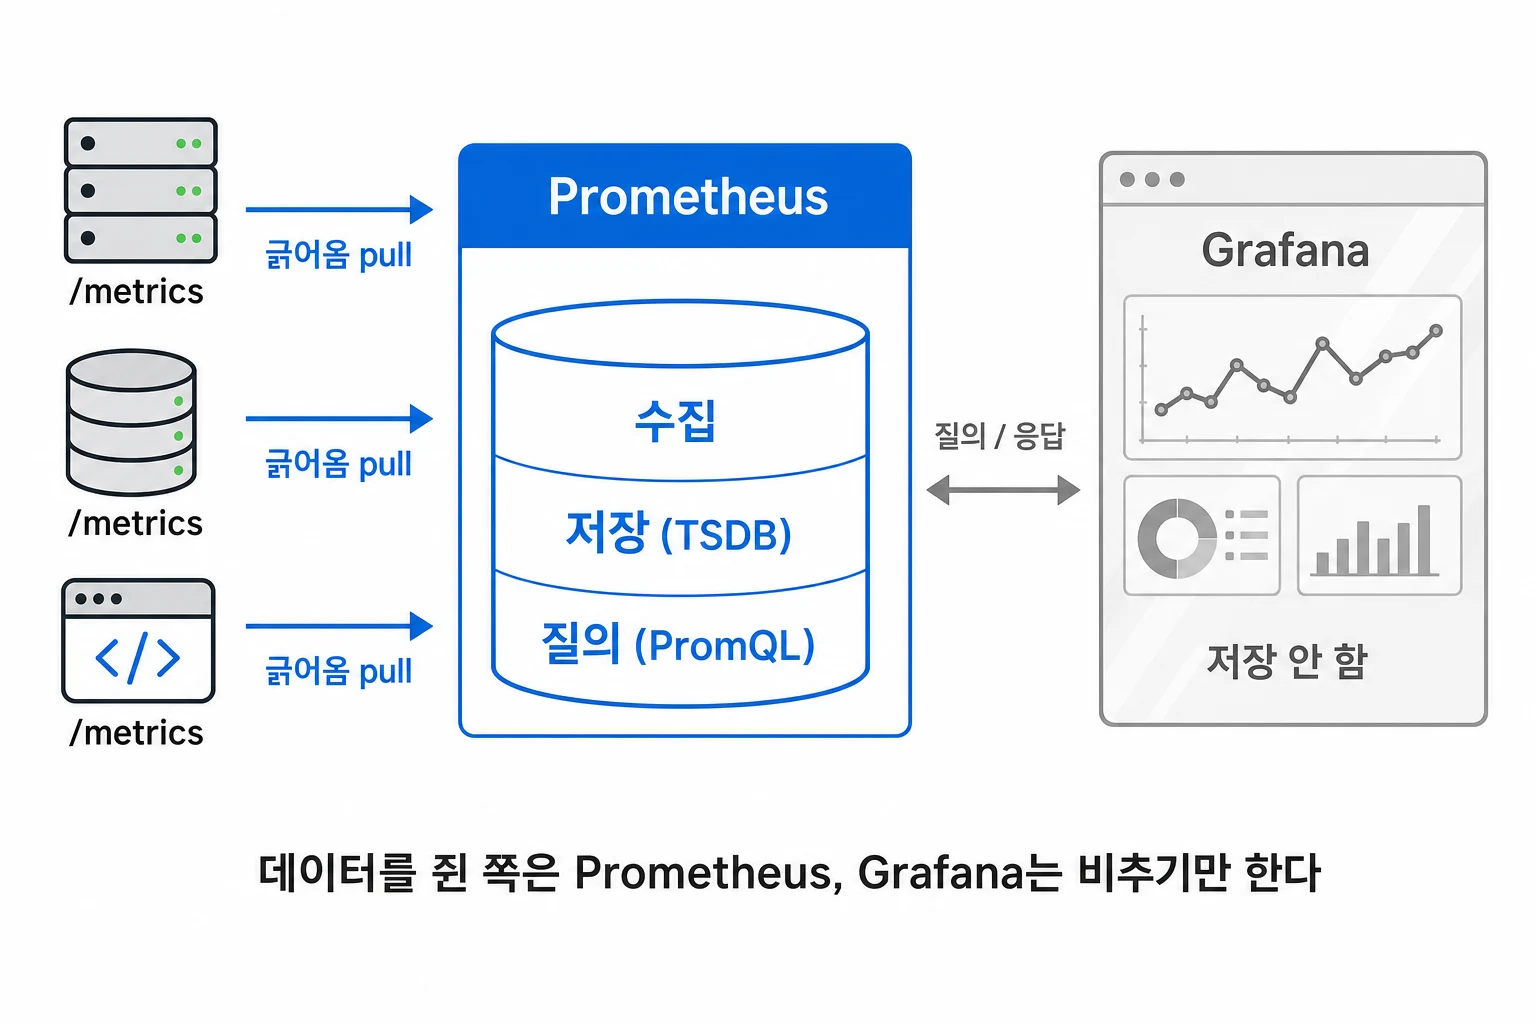 프로메테우스가 수집한 지표를 보관하고 그라파나는 필요한 데이터를 질의해 시각화한다
웹 서버의 요청 수를 모니터링한다고 가정해보자. 애플리케이션이 요청 수를 지표로 내보내면 프로메테우스가 이를 주기적으로 수집하고, 그라파나는 프로메테우스에 특정 시간 구간의 데이터를 요청해 그래프로 표시한다.
이 구성에서 과거 요청 수를 보관하는 곳은 프로메테우스다. 그라파나에 그래프를 만든다고 지표 원본이 그라파나의 DB로 옮겨지는 것은 아니다.
프로메테우스 — 시간에 따른 지표를 수집하고 질의한다
같은 지표를 시간별로 기록한 데이터를 시계열이라고 한다. 예를 들어 CPU 사용률을 15초 간격으로 측정하면 시간과 값이 짝을 이루며 쌓인다. 프로메테우스는 이런 시계열을 저장하고, 질의 언어인 PromQL로 조회할 수 있게 한다.
프로메테우스는 그라파나가 없어도 지표를 수집하고 질의할 수 있다. 그라파나는 그 데이터를 여러 패널과 대시보드로 구성해 비교하고 탐색하기 편하게 만든다.
그라파나 — 데이터소스와 화면 설정을 연결한다
그라파나는 프로메테우스 외에도 로그 저장소나 SQL DB 같은 여러 데이터소스에 연결할 수 있다. 지표와 로그를 한 대시보드에 배치하는 식으로 서로 다른 데이터를 함께 보여준다.
그렇다고 그라파나가 데이터를 전혀 저장하지 않는 것은 아니다. 자체 DB에는 대시보드와 사용자 등 운영에 필요한 정보를 저장한다. 대시보드 설정의 저장과 지표 원본의 저장은 서로 다른 역할이다.
여기서 설명하는 것은 프로메테우스를 데이터소스로 연결한 Grafana 애플리케이션의 역할이다. 저장 서비스를 함께 제공하는 Grafana Cloud 전체와 동일하게 이해하면 안 된다.
프로메테우스는 대상에 접속해 지표를 가져온다
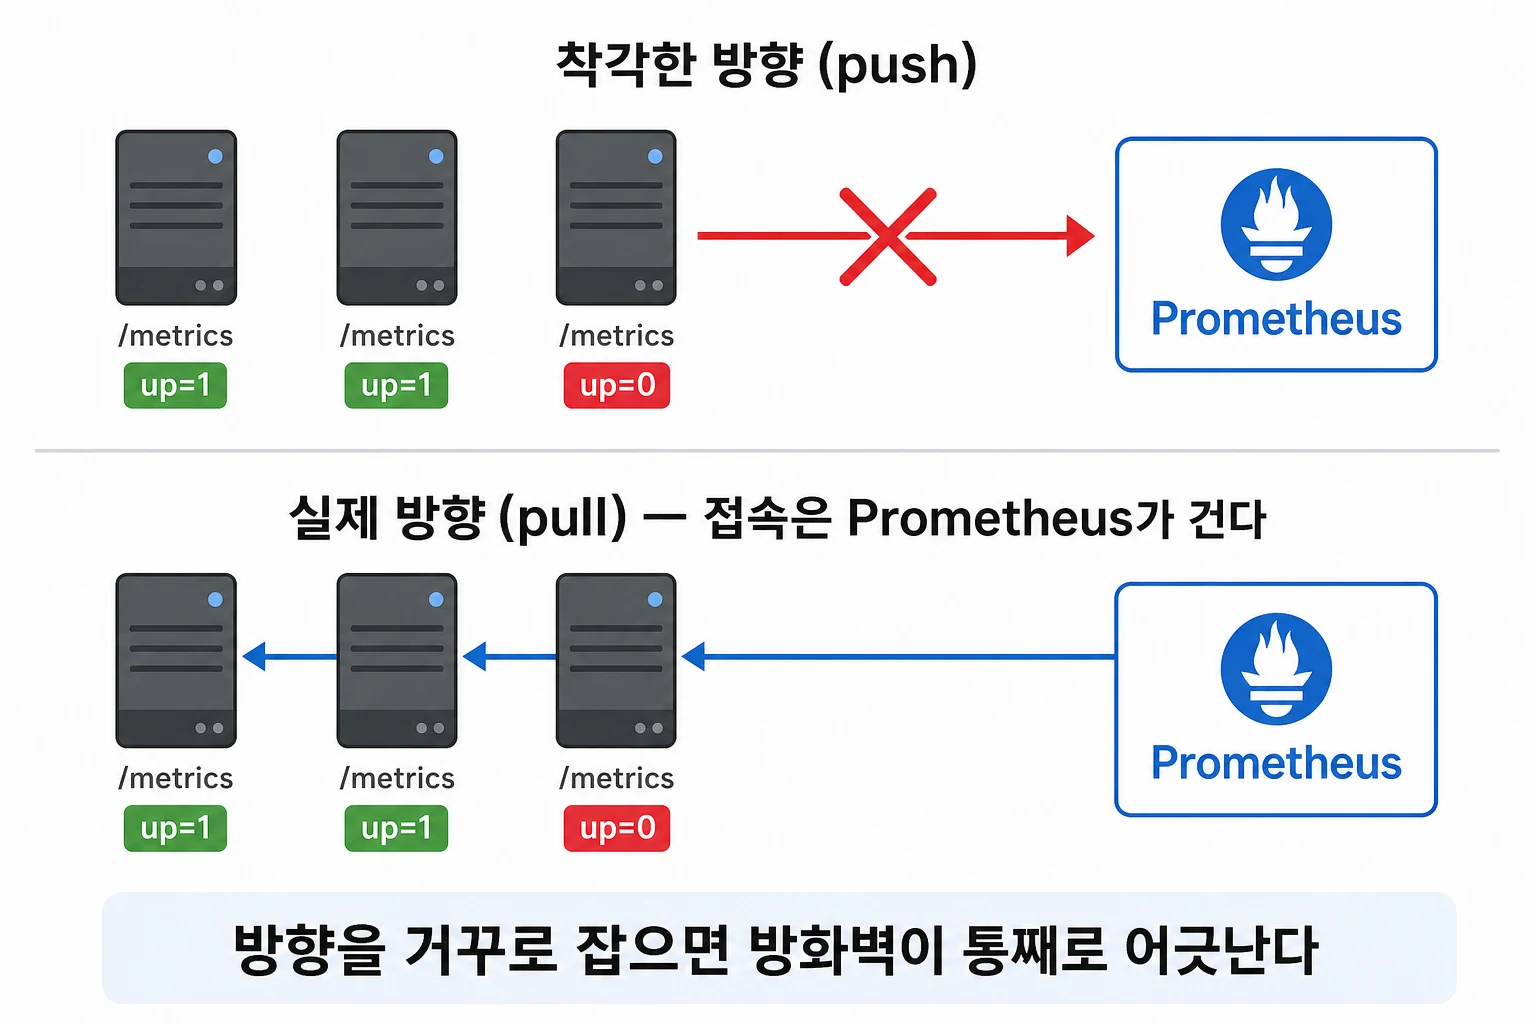 프로메테우스가 수집 대상에 접속하므로 대상의 지표 엔드포인트에 접근할 수 있어야 한다
프로메테우스의 기본 수집 방식은 대상에 HTTP로 접속해 지표를 가져오는 pull 모델이다. 대상 애플리케이션은 보통 /metrics 같은 주소에서 지표 이름과 라벨, 값을 제공한다.
다음은 형식을 보여주는 예시다. 실제 서비스의 측정 결과를 나타내는 것은 아니다.
1
2
3
4
# HELP http_requests_total 총 처리한 요청 수
# TYPE http_requests_total counter
http_requests_total{method="GET",status="200"} 20345
http_requests_total{method="GET",status="500"} 12
http_requests_total은 요청 누적값이고, method와 status는 어떤 요청인지 구분하는 라벨이다. 같은 지표 이름이라도 라벨 조합이 다르면 별도 시계열로 저장된다.
수집 대상과 주기는 설정 파일에서 지정한다. 아래 예시는 15초마다 10.0.0.5:8080의 지표를 가져온다.
1
2
3
4
5
scrape_configs:
  - job_name: "my-app"
    scrape_interval: 15s
    static_configs:
      - targets: ["10.0.0.5:8080"]
scrape_interval은 지표를 수집하는 간격이다. 이 예시에서는 기본 지표 경로인 /metrics에 접속하며, job_name을 통해 수집 작업을 구분한다.
프로메테우스는 수집 성공 여부를 up 지표로도 남긴다. 1은 수집 성공, 0은 수집 실패를 뜻한다. 네트워크 문제나 응답 오류로도 실패할 수 있으므로, up=0만으로 서버 자체가 종료됐다고 단정할 수는 없다.
exporter — 시스템 상태를 수집 가능한 지표로 제공한다
모든 시스템이 프로메테우스 형식의 지표를 직접 제공하는 것은 아니다. 이런 시스템의 상태를 읽어 지표로 내보내는 중간 프로그램을 exporter라고 부른다.
호스트의 CPU·메모리를 다루는 node_exporter, MySQL 상태를 다루는 mysqld_exporter가 예다. 애플리케이션 코드에 직접 계측 기능을 넣어 지표를 제공할 수도 있다.
Pushgateway — 짧은 배치 작업의 결과를 수집에 연결한다
수집 주기보다 빨리 끝나는 배치 작업은 프로메테우스가 접속하기 전에 종료될 수 있다. 이런 경우 일부 서비스 수준의 배치 작업은 결과 지표를 Pushgateway에 보내고, 프로메테우스가 그곳에서 가져오도록 구성할 수 있다.
Pushgateway의 지표 수명은 원래 작업의 수명과 다르다. 작업이 종료됐다고 지표가 자동 삭제되지 않으므로 정리 방식도 함께 관리해야 한다. 또한 Pushgateway 수집이 성공했다는 사실로 원래 작업의 현재 상태까지 알 수 있는 것은 아니다.
지표의 종류에 따라 읽는 방법이 달라진다
누적 요청 수와 현재 메모리 사용량은 같은 방식으로 해석할 수 없다. 요청 수는 얼마나 빠르게 늘어나는지가 중요하고, 메모리 사용량은 현재 값이나 변화 폭을 본다.
대표적인 지표 종류는 다음과 같다.
| 종류 | 성질 | 예시 | 읽는 방법 |
|---|---|---|---|
| Counter | 증가하다가 재시작 등으로 리셋될 수 있다 | 총 요청 수 | rate() 등으로 증가율 확인 |
| Gauge | 값이 오르내린다 | 메모리 사용량, 큐 길이 | 현재 값과 변화 확인 |
| Histogram | 관측값의 분포를 담는다 | 응답 시간 | 분포를 집계하고 분위수 계산 |
| Summary | 관측값의 합계·개수와 설정된 분위수를 제공한다 | 응답 시간 | 클라이언트가 계산한 분위수 등 확인 |
여러 서버의 응답 시간을 합쳐 p99를 보고 싶다면 집계 가능한 형태인지가 중요하다. Histogram의 분포는 합쳐서 분위수를 계산할 수 있지만, Summary에서 이미 계산한 각 서버의 p99를 단순히 합쳐 전체 p99로 만들 수는 없다.
PromQL — 누적값에서 현재의 처리 속도를 읽는다
요청 누적값만 그래프로 그리면 서버가 계속 동작하는 동안 숫자가 커진다. 트래픽이 늘었는지 줄었는지를 보려면 일정 시간 동안의 증가 속도를 계산해야 한다.
rate(http_requests_total[5m])은 최근 5분 구간에서 초당 평균 몇 건씩 증가했는지를 계산한다. Counter가 재시작으로 리셋되는 경우도 고려하므로, 누적값을 단순히 빼는 것보다 용도에 맞는다.
sum by(job)(rate(http_requests_total[5m]))는 이를 job별로 합친다. 그라파나에서 프로메테우스 데이터를 표시하는 패널은 이런 질의 결과를 그래프로 보여줄 수 있다.
라벨 — 필요한 구분만 남긴다
라벨은 지표를 구분하는 기준이지만, 값의 조합마다 시계열이 늘어난다. user_id나 request_id처럼 계속 새로운 값이 생기는 항목을 붙이면 수집·저장해야 하는 시계열도 크게 늘 수 있다.
따라서 라벨은 상태 코드나 작업 종류처럼 실제로 묶어서 비교할 기준을 중심으로 정한다. 개별 요청의 상세 추적이 필요한 것과 집계 지표가 필요한 것을 구분해야 한다.
알람은 조건 판단과 전달 경로를 나눠 구성한다
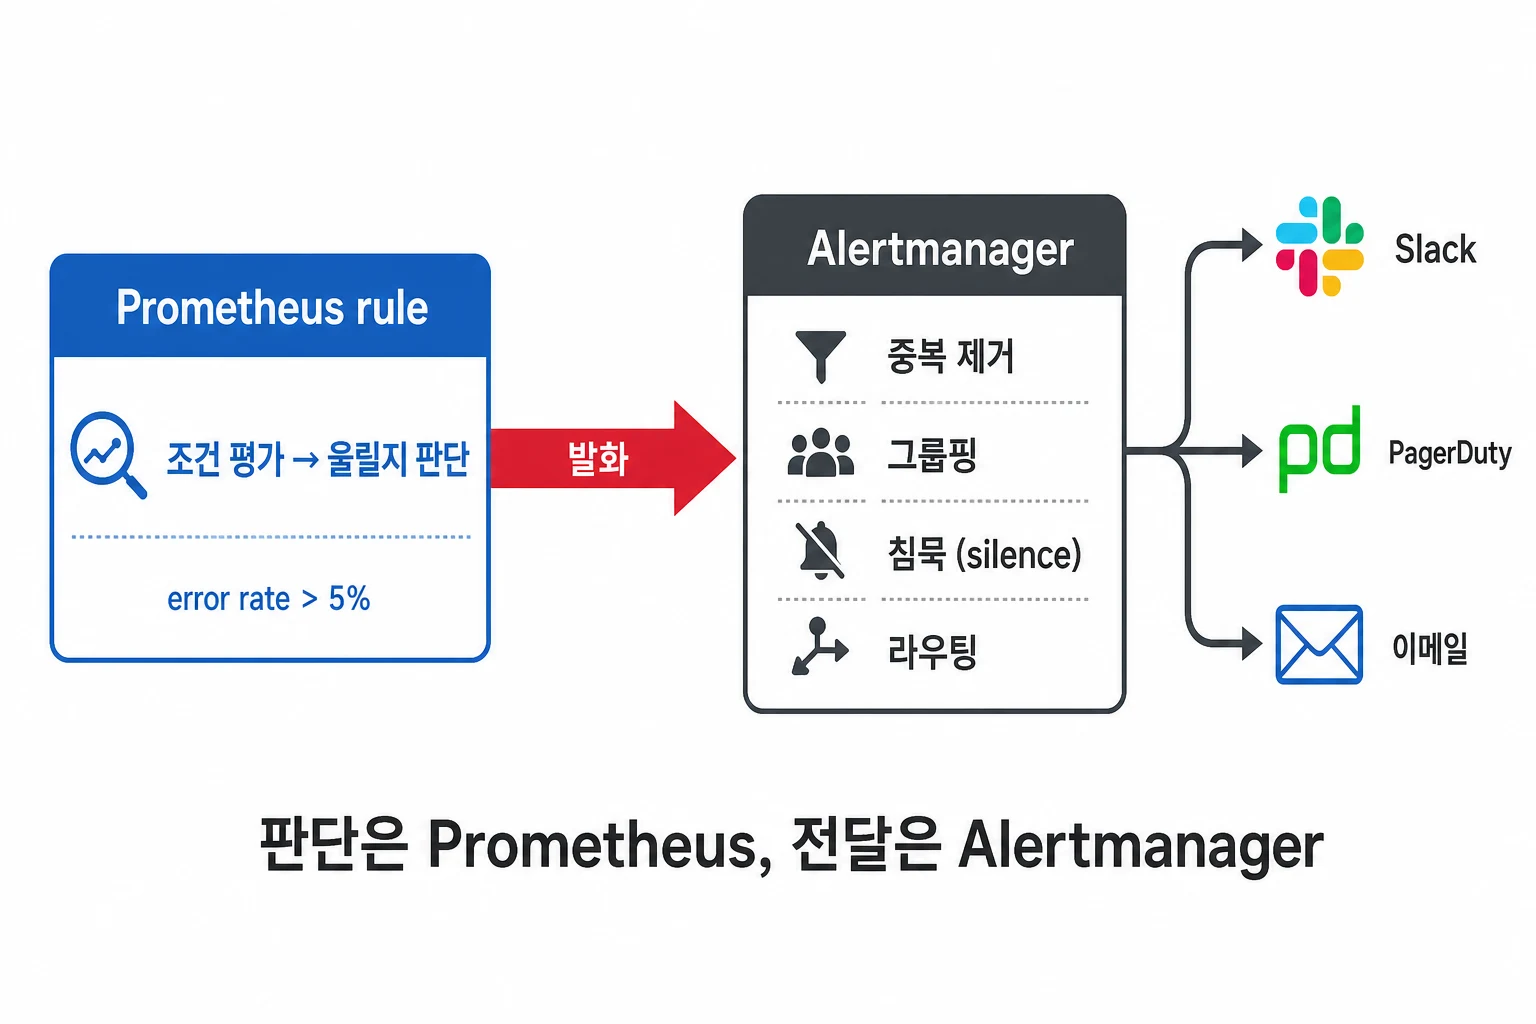 프로메테우스 방식에서는 규칙으로 알람 조건을 판단하고 Alertmanager가 알림 전달을 맡는다
프로메테우스는 PromQL로 작성한 알람 조건을 주기적으로 평가한다. 예를 들어 오류 요청의 초당 평균 발생 건수가 정해 둔 값을 넘는지 검사할 수 있다.
1
2
3
4
5
6
7
8
9
10
groups:
  - name: app
    rules:
      - alert: HighErrorRate
        expr: rate(http_requests_total{status="500"}[5m]) > 0.05
        for: 5m
        labels:
          severity: page
        annotations:
          summary: "HTTP 500 응답이 초당 0.05건을 초과하는 상태가 5분간 지속됐다"
이 예시의 조건은 최근 5분 기준 HTTP 500 응답이 초당 0.05건을 초과하는 상태다. 이 상태가 for: 5m 동안 유지되면 알람이 발생한다. 전체 요청 중 오류 비율을 계산한 식은 아니므로 5% 오류율로 해석하면 안 된다.
프로메테우스의 알람을 받아 실제 알림으로 전달하는 역할은 Alertmanager가 맡는다. 같은 알람을 묶거나 중복을 줄이고, 점검 시간의 알림을 억제하거나 담당 채널로 전달한다.
그라파나에도 알람 조건을 평가하고 알림을 관리하는 기능이 있다. 지원하는 여러 데이터소스의 결과를 활용할 수 있고, 화면뿐 아니라 코드로 알람 리소스를 관리하는 방법도 제공한다.
| 구분 | 프로메테우스 알람 | 그라파나 알람 |
|---|---|---|
| 조건 평가 | 프로메테우스 규칙 | Grafana-managed 규칙 등 |
| 데이터 범위 | 프로메테우스에서 질의하는 지표 | 지원하는 여러 데이터소스 |
| 알림 구성 | Alertmanager와 연결 | 연락 지점과 알림 정책 등으로 구성 |
| 규칙 관리 | YAML 파일 등 | UI 또는 프로비저닝 등 |
이미 프로메테우스 규칙과 Alertmanager를 운영한다면 그 흐름을 유지할 수 있다. 여러 데이터소스를 묶어 알람을 관리하려면 그라파나 방식도 검토할 수 있다. 같은 조건을 양쪽에 중복 등록해 알림이 두 번 전달되지 않도록 관리 범위를 정하는 것이 중요하다.
필요한 보관과 장애 대응 범위에 맞춰 구성한다
프로메테우스와 그라파나를 함께 사용하면 지표 수집부터 대시보드까지 연결할 수 있다. 여기에 프로메테우스 알람을 사용할 경우 Alertmanager를 연결하는 식으로 역할을 더한다.
프로메테우스의 로컬 저장소가 여러 서버에 자동 복제되는 것은 아니다. 보관 기간과 디스크 용량, 수집 서버 장애 때의 공백을 고려해야 한다. 장기 보관이나 이중화가 필요하면 별도의 저장·복구 구성을 함께 검토한다.
구성은 대시보드 화면 수보다 어떤 지표를 얼마나 오래 보관하고, 어느 장애까지 감지해야 하는지에 따라 달라진다. 수집 실패와 실제 업무 장애도 구분해야 한다.
정리하면
프로메테우스는 지표를 수집하고 저장하며 질의와 규칙 평가를 담당한다. 그라파나는 연결한 데이터소스를 조회해 화면으로 보여주고, 필요하면 자체 알람 기능도 사용한다.
그라파나 자체에도 대시보드와 사용자 같은 저장 데이터가 있다. 다만 프로메테우스에 쌓인 지표 원본과 그라파나의 화면 설정은 구분해야 한다.
역할을 나누면 지표가 비어 있을 때 수집 경로를 확인할지, 질의를 확인할지 판단하기 쉽다. 알람 조건을 평가하는 곳과 알림을 전달하는 곳까지 정하면 모니터링의 전체 흐름이 분명해진다.
참고 자료
- Prometheus — Overview — 수집·저장·질의 구성
- Grafana — Data sources — 데이터소스 연결과 조회
- Grafana — Database configuration — 사용자·대시보드 등 자체 데이터 저장
- Prometheus — Jobs and instances —
up과 수집 성공 여부 - Prometheus — When to use the Pushgateway — 적용 대상과 지표 수명 관리
- Prometheus — Query functions —
rate()의 단위와 Counter 리셋 처리 - Prometheus — Alerting rules — 조건과 지속 시간의 의미
- Grafana — Provision Alerting resources — 알람 리소스의 코드 관리