Kafka 쿠폰 접수의 재전달과 장애 복구 검증
선착순 쿠폰 발급 프로젝트에서 요청이 순간적으로 몰리자 DB 연결을 기다리는 요청이 쌓였다. 발급 수량의 정합성을 지키더라도, 사용자가 응답을 기다리는 시간까지 짧아지는 것은 아니었다. 폭주가 끝난 뒤 들어온 요청도 앞선 작업이 빠져나가기를 기다렸다.
Kafka를 붙인 첫 경로에서는 신청 접수와 실제 발급을 나눴다. API는 신청을 Kafka에 기록한 뒤 접수를 알리고, Consumer가 DB에서 발급 여부를 판단했다. 접수 이후 중단된 신청이 복구되는지, 최종 발급까지 얼마나 기다리는지를 각각 확인해야 했다.
당시에는 Redis 예약 없이 Kafka로 신청을 직접 접수했다. 이후 추가한 Redis 예약 구조는 이 글의 복구·성능 측정에 포함하지 않았다.
접수 성공과 쿠폰 발급 성공을 다른 응답으로 다뤘다
동기 경로의 HTTP 200은 발급 처리가 끝났다는 응답이었다. Kafka 경로의 HTTP 202는 해당 신청을 접수했다는 응답이다. 아직 Consumer가 발급 가능 여부를 판단하지 않았으므로, 202를 받았더라도 최종 결과는 ISSUED 또는 REJECTED가 될 수 있다.
당시 API는 클라이언트가 보내는 requestId와 쿠폰·사용자 ID로 메시지를 만들었다. Producer의 전송 결과를 확인한 뒤 202와 ACCEPTED를 반환했다.
전송 도중 연결이 끊기거나 응답을 기다리다 시간 초과가 나면, 메시지가 기록되지 않았다고 확정할 수 없다. 브로커는 기록했지만 애플리케이션이 그 응답을 받지 못했을 가능성이 있기 때문이다. API는 이 경우 접수 여부를 확인하지 못했다는 오류와 함께 같은 requestId로 재시도하도록 안내했다.
새 ID를 만들면 Consumer에게는 새로운 신청으로 보인다. 같은 ID를 유지하면 이미 처리된 신청인지 DB 결과에서 확인할 수 있다. 한 ID로 다른 쿠폰이나 사용자를 보내는 요청은 충돌로 다뤄, 기존 결과를 엉뚱한 신청의 결과로 반환하지 않도록 했다.
Kafka에는 순간 유입을 기록해 두고 DB 처리 속도에 맞춰 꺼내도록 했다. 접수를 마친 뒤에도 발급 대기가 남으므로, 최종 처리량과 대기 시간은 별도로 측정해야 했다.
발급 수량과 이력, 요청 결과를 한 트랜잭션에 기록했다
Consumer는 CouponIssueProcessor.process()를 호출한다. 이 서비스는 먼저 해당 요청 ID의 처리 결과가 있는지 확인하고, 결과가 있으면 쿠폰·사용자가 같은지 비교한 뒤 기존 결과를 반환한다. 재전달된 메시지를 처리할 때 수량을 다시 증가시키지 않는 첫 번째 조건이다.
처리 결과가 없으면 쿠폰의 유효성과 기존 발급 여부를 검사한다. 재고 반영은 현재 발급 수량이 총수량보다 작고 쿠폰이 활성 상태인 경우에만 증가하는 조건부 UPDATE를 사용했다. DB의 중복 발급 제약도 함께 유지했다.
발급 수량 변경, 발급 이력 저장, 요청 ID별 최종 결과 저장은 하나의 DB 트랜잭션에 넣었다. 수량만 늘었거나 이력만 남은 상태에서 결과가 누락되면, 같은 메시지를 다시 받았을 때 무엇을 재사용해야 하는지 판단하기 어려워진다. 세 기록이 함께 커밋되거나 함께 롤백돼야 한다.
실험 당시 처리 코드에서 기존 결과를 재사용하는 부분은 다음과 같다.
1
2
3
4
5
6
7
8
9
10
11
12
var existing = resultRepository.findByRequestId(requestId);

if (existing.isPresent()) {
    CouponIssueResult result = existing.get();
    if (!result.getCouponId().equals(couponId)
            || !result.getUserId().equals(userId)) {
        throw new IllegalArgumentException(
                "같은 요청 ID에 다른 요청 신청 내용을 사용할 수 없습니다."
        );
    }
    return result;
}
이 검사는 @Transactional이 적용된 처리 메서드 안에 있다. 기존 결과가 없는 경로에서는 발급 처리와 결과 저장을 수행하며, DB 오류가 나면 트랜잭션 전체가 롤백된다. 거절도 요청에 대한 최종 결과이므로 REJECTED로 남긴다.
Kafka 설정은 자동 offset 커밋을 끄고, 레코드 단위 RECORD와 동기 커밋을 사용했다. Spring Kafka 컨테이너는 리스너 호출이 반환된 뒤 해당 레코드의 offset을 커밋한다. 이 구현에서는 별도 트랜잭션 서비스가 커밋을 마치고 반환한 다음 리스너가 반환하므로, DB 커밋이 offset 커밋보다 앞선다.
DB 커밋과 Kafka offset 커밋 사이에서 프로세스가 종료되면 같은 레코드가 다시 전달될 수 있다. Consumer는 DB에 저장된 요청 결과를 재사용해 같은 발급을 반복하지 않도록 했다.
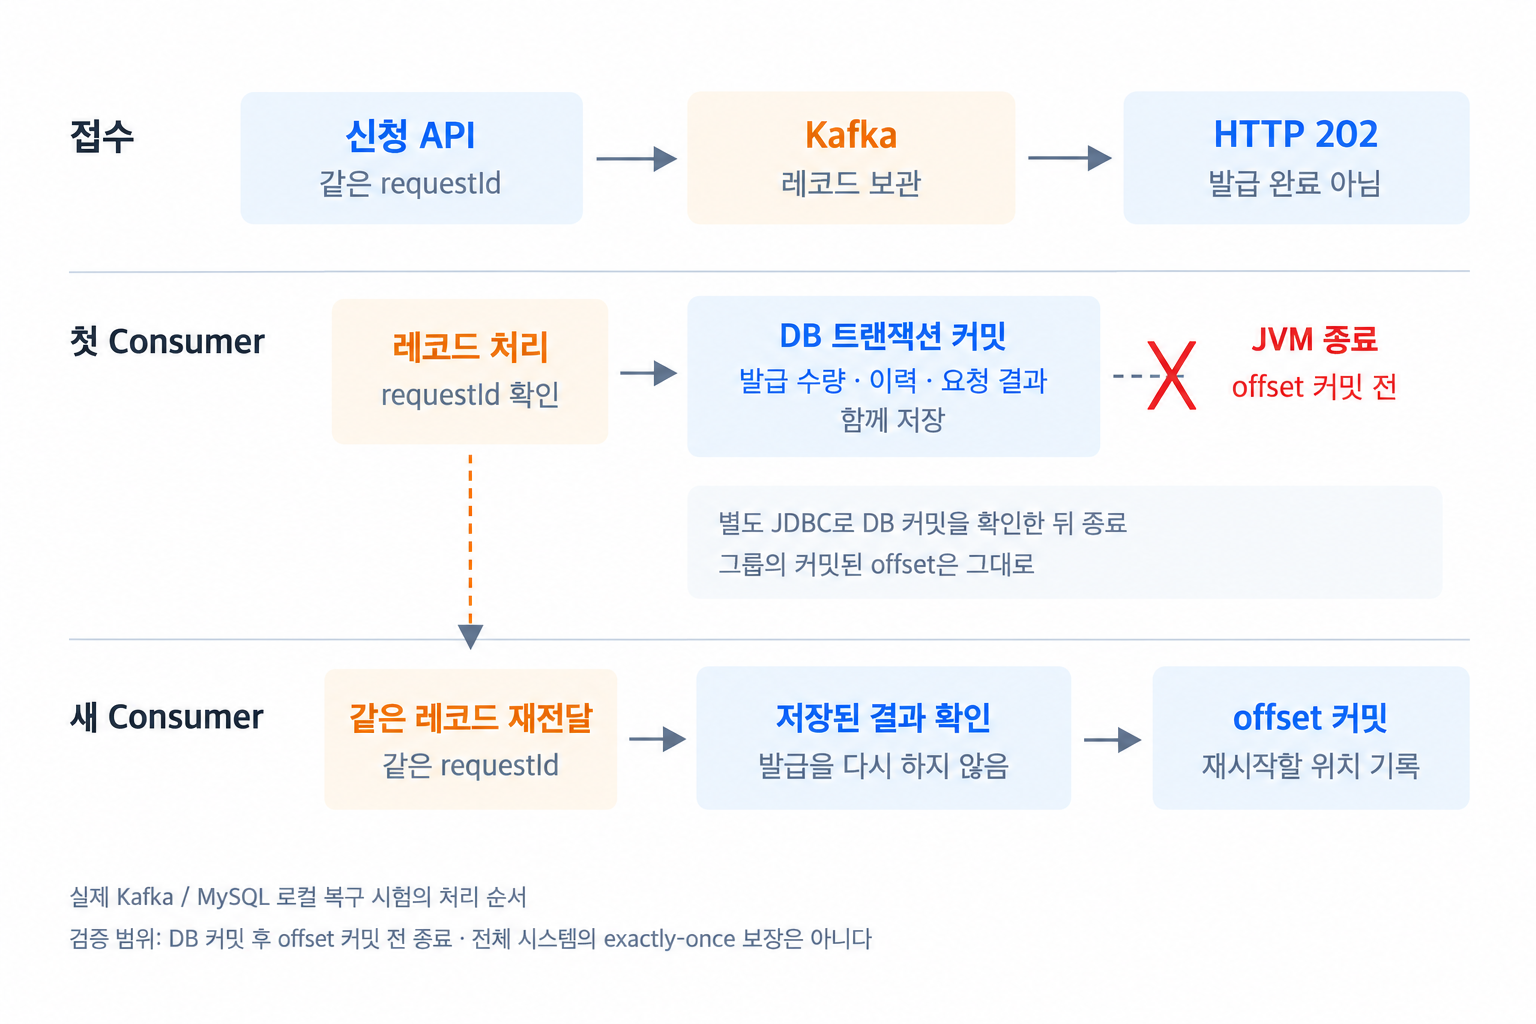 DB 커밋 뒤 재전달된 요청은 저장된 결과를 사용해 중복 발급을 막는다
DB 커밋 뒤 JVM을 종료해 같은 레코드의 재전달을 확인했다
2026년 10월 2일 로컬 복구 시험은 실제 Kafka 3.7.0과 MySQL 8.0 Testcontainers, 별도 애플리케이션 JVM을 사용했다. 기존 개발용 서비스와 분리된 환경에서, DB에는 커밋됐지만 Kafka offset은 그대로인 지점을 확인한 뒤 앱 프로세스를 강제로 종료했다.
테스트 전용 프록시는 DB 트랜잭션 서비스가 반환한 뒤, Consumer가 Kafka 컨테이너에 반환하기 전에 리스너 스레드를 멈춰 세웠다. 활성 트랜잭션이 없다는 표식과 함께, 별도 JDBC 연결에서 발급 수량·이력·처리 결과가 각각 한 건씩 조회되는지 확인해 커밋 완료를 대조했다.
그때 처리한 레코드의 offset은 3이었다. Consumer 그룹의 커밋된 다음 읽기 위치는 여전히 3이고 토픽 끝 위치는 4였다. offset 3의 메시지는 존재하지만, 다음에는 4부터 읽으면 된다는 처리가 아직 기록되지 않은 상태다.
이 지점에서 앱 JVM을 Process.destroyForcibly()로 강제 종료하고, 같은 Consumer 그룹으로 새 JVM을 시작했다. API 재접수나 Producer 재발행 없이 기존 레코드가 다시 전달되는지 확인했다.
재시작 후에는 최초 전달과 동일한 topic·partition·offset·requestId가 관측됐다. DB의 수량·발급 이력·처리 결과는 각각 1을 유지했고, 발급 이력 ID와 처리 결과 ID도 바뀌지 않았다. 토픽 끝 위치는 4인 채 커밋 위치만 3에서 4로 이동했다.
같은 레코드가 재전달됐을 때 DB의 기존 요청 결과를 재사용했고, 추가 발급은 발생하지 않았다.
Consumer가 멈춘 요청은 보관됐고 DB 오류 뒤에는 수동으로 재개했다
Consumer만 멈추고 API는 유지한 시험에서는 재고 2개인 쿠폰에 신청 3건을 보냈다. 세 요청은 모두 202를 받았지만, Consumer가 멈춘 동안 DB의 발급 수량·이력·결과는 모두 0이었다. Kafka lag는 3으로 남아 처리할 신청을 보여줬다.
Consumer를 재개한 뒤에는 두 건이 ISSUED, 재고가 부족한 한 건이 REJECTED가 됐다. 모든 요청 ID에 최종 결과가 남았고 lag도 0이 됐다.
DB 오류 시험에서는 특정 요청의 결과 저장을 거절하는 CHECK 제약을 테스트 DB에 추가했다. 수량 변경과 이력 저장을 거친 뒤 결과 저장이 실제로 실패하도록 만든 것이다. 처리 이후 세 기록이 모두 0임을 확인해 트랜잭션 롤백 범위를 검사했다.
이 오류는 CommonContainerStoppingErrorHandler를 통해 리스너를 중단시켰다. API는 살아 있어 후속 신청도 Kafka에 접수됐지만, 제약을 제거한 것만으로 Consumer가 다시 처리하지는 않았다. 오류 원인을 제거한 뒤 Consumer를 수동으로 재개했다.
수동 재개 후에는 실패했던 offset 4가 다시 전달돼 처리되고, 이어 offset 5의 후속 신청이 처리됐다.
| 중단 조건 | 중단 시 확인한 상태 | 재개 뒤 확인한 결과 |
|---|---|---|
| Consumer 정지 | 접수 3건, DB 결과 0건, lag 3 | 발급 2건·거절 1건, lag 0 |
| DB 커밋 후 JVM 종료 | DB 결과 1건, offset 미커밋 | 같은 레코드 재전달, 추가 발급 없음 |
| 결과 저장 중 DB 오류 | 수량·이력·결과 전체 롤백 | 원인 제거·수동 재개 뒤 두 요청 처리 |
세 복구 시험은 Kafka의 메시지 보관 기간 안에서 수행했다. 여러 파티션·Consumer 사이의 경합, 브로커 디스크 손실, 복제본 장애와 장시간 장애는 검증 범위에 포함하지 않았다.
접수는 빨라졌지만 최종 결과를 확인하는 시간은 늘었다
10월 3일 로컬 폭주 비교에서는 접수 지연과 최종 결과 지연을 따로 측정했다. 접수 지연은 HTTP 호출 직전부터 202를 받기까지이고, 최종 결과 지연은 같은 전송 시각부터 별도 JDBC 조회에서 커밋된 결과를 처음 읽기까지다. 엔티티의 processed_at을 DB 커밋 순간으로 사용하지 않았다.
3초 폭주 시험의 목표 부하는 초당 100건으로 20초, 초당 1,200건으로 3초, 다시 초당 100건으로 30초였다. 실제 전송 시각에는 부하 발생기의 편차가 있어 아래 차트와 표는 공통 시작점의 예정 경계로 요청을 나눴다. Kafka 경로의 실제 전송·접수는 8,617건이었다. 클라이언트 시간 제한은 60초이고 재시도는 하지 않았다.
로컬 MySQL과 Kafka는 각각 CPU 1개·메모리 1GiB, DB 연결 풀은 10개였다. Kafka는 파티션 하나와 Consumer 하나로 순차 처리했다. 같은 호스트의 다른 작업과 캐시 상태까지 통제한 실험은 아니었다.
DB 조회는 약 250ms 간격으로 수행했다. 최종 결과 지연에는 실제 커밋 이후 다음 조회까지 기다리는 시간이 포함되므로, 평상시의 약 254ms를 쿠폰 한 건의 순수 DB 처리시간으로 해석할 수 없다.
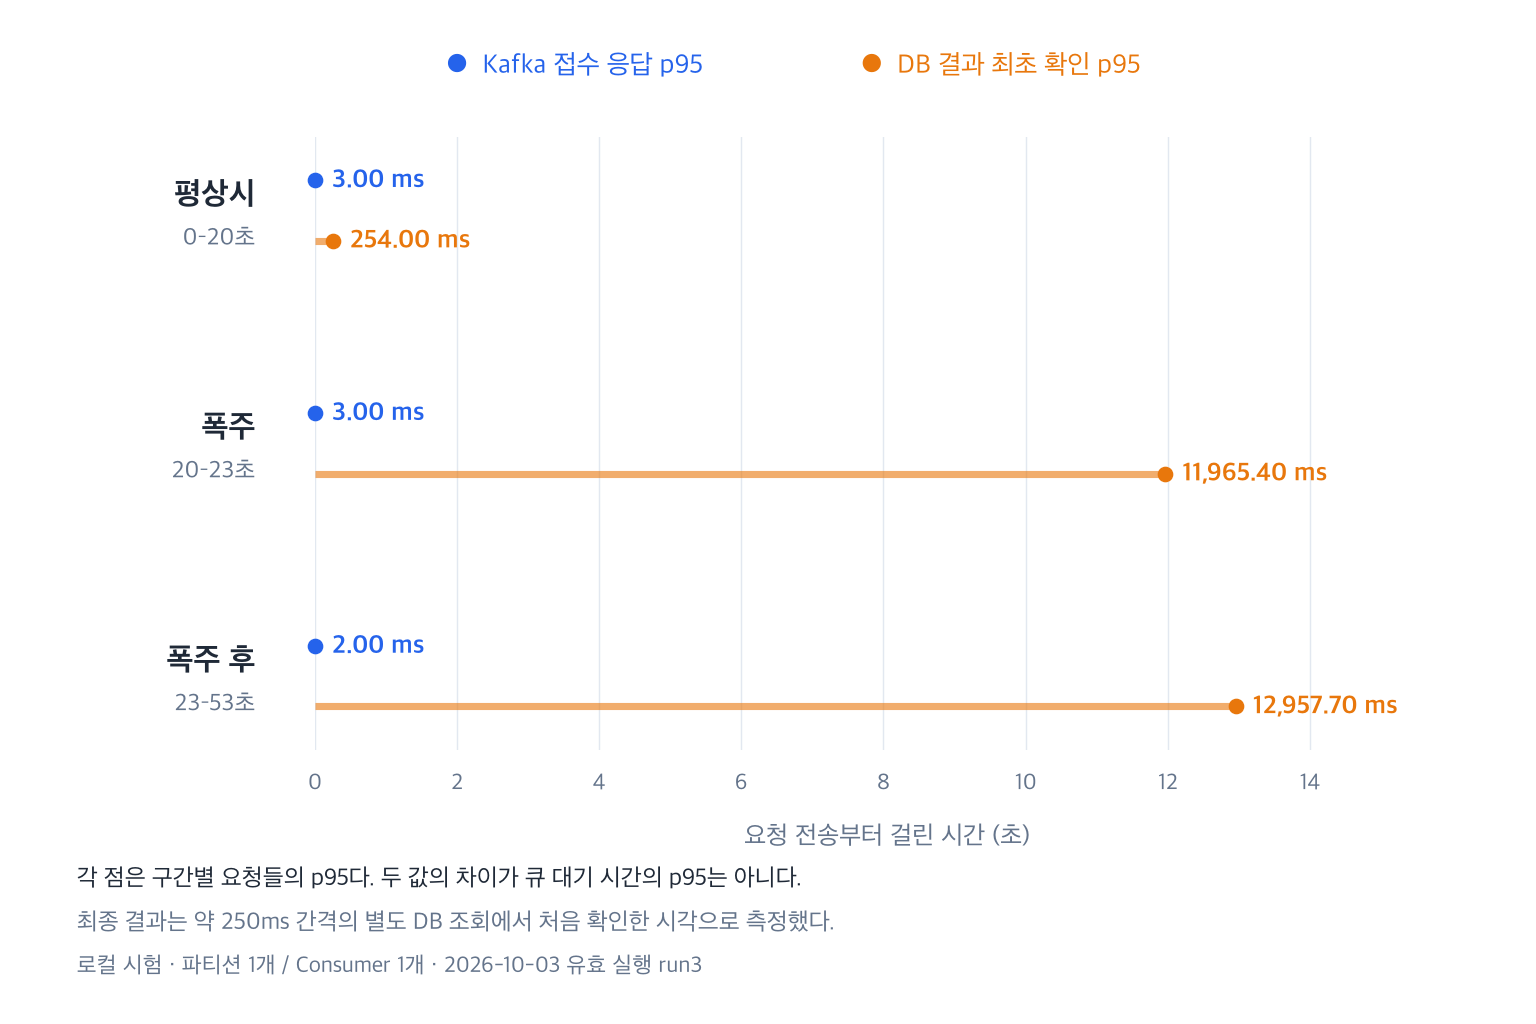 Kafka 접수 p95는 수 ms였지만, 폭주 구간에 전송한 요청의 최종 결과 최초 확인 p95는 약 12초였다
차트의 값은 각 전송 구간에 속한 요청들의 집계다. 한 요청의 처리 순서를 그린 것이 아니며, 두 p95의 차이를 큐 대기 시간의 p95로 계산할 수 없다.
기존 동기 경로에서 폭주 구간의 발급 완료 p95는 2,435.10ms였다. 다만 아래 비교에서는 발급을 판단하고 저장하는 작업 구조도 함께 달랐다.
동기 경로를 포함한 전체 수치 비교
| 요청 전송 구간 | 기존 동기 완료 p95 | Kafka 접수 p95 | Kafka 최종 결과 최초 확인 p95 |
|---|---|---|---|
| 평상시, 0~20초 | 9.00ms | 3.00ms | 254.00ms |
| 폭주, 20~23초 | 2,435.10ms | 3.00ms | 11,965.40ms |
| 폭주 후, 23~53초 | 1,325.60ms | 2.00ms | 12,957.70ms |
빠른 접수 응답 뒤에도 발급을 기다리는 요청은 남아 있었다. 대기하던 장소가 HTTP 처리 스레드와 DB 연결 풀에서 Kafka의 미처리 메시지로 옮겨간 것이다. 관측 최대 lag는 3,214였고, 시험 종료 시점에는 접수 8,617건의 요청·사용자·발급 이력 매핑이 모두 일치했다.
모든 발급은 완료됐지만, 최종 결과 지연이 사전에 정한 회복 기준을 연속된 두 개의 5초 구간에서 충족하는지는 확인하지 못했다.
이 비교는 Kafka 유무만 바꾼 실험도 아니다. 기존 동기 경로는 Redis에서 판정한 뒤 DB에 저장했고, Kafka 경로는 Redis 선차감 없이 DB에서 판정하며 요청별 결과까지 추가로 저장했다. 처리 동시성과 저장 작업이 함께 달라져, 지연 차이 전체를 Kafka 자체의 비용으로 단정하지 않았다.
시간 비교에는 유효한 세 번째 실행만 사용했다. 앞선 실행 중 하나는 관측 도구 문제로 부하 전에 중단됐고, 다른 실행은 호스트 시계가 뒤로 이동해 지연 비교에서 제외됐다.
10초 폭주 — 타임아웃된 신청도 DB에서는 발급돼 있었다
별도 과부하 비교에서는 폭주를 10초로 늘리고 클라이언트 시간 제한을 5초로 맞췄다. 동기 경로의 전송 17,002건 중 8,642건이 타임아웃됐지만, 최종 DB에서는 17,002건 모두 발급돼 있었다. 사용자에게는 결과를 알 수 없는 요청이었지만 서버에서는 발급이 계속 진행됐다.
Kafka 경로는 17,003건을 모두 202로 접수하고 최종 발급까지 마쳤다. 다만 마지막 요청 전송 뒤에도 약 16.7초 동안 추가 처리가 필요했다. 접수 응답 이후 초과 유입을 보관하고 순차 처리하는 시간이 필요했다.
과부하 비교에서는 두 경로 모두 최종 발급을 마쳤고, 접수 응답과 처리 대기의 차이가 드러났다. 중단 후 재전달과 중복 방지는 앞선 강제 종료 시험에서 확인했다.
Consumer 시간의 대부분은 DB 처리 경로에서 쓰였다
Consumer 수와 offset 커밋 설정을 유지한 채, 적체를 처리하는 동안 DB 서비스 호출, offset 커밋, poll()에 쓰인 시간을 나눠 측정했다. 계측을 끈 실행과 켠 실행을 OFF→ON→ON→OFF 순서로 반복한 기록을 비교했다.
이 시험은 초당 1,200건을 10초 동안 보내는 조건을 사용했다. DB 구간은 트랜잭션 프록시에 들어가기 직전부터 실제 커밋과 정리가 끝나 반환할 때까지 측정했다. 커밋 완료는 독립 JDBC 조회와 트랜잭션 상태로 대조했다.
내부 계측을 켠 두 실행에서 DB 처리 경로는 같은 적체 구간 시간의 91.8%와 92.2%를 차지했다. 실제 commitSync() 호출부터 반환까지 측정한 offset 커밋은 각각 7.70%, 7.34%였다. 이 구성에서는 먼저 확인할 비용이 레코드 조회보다 순차 DB 처리 쪽에 있었다.
약 92%는 연결 확보, JPA·JDBC 처리, SQL, 커밋과 정리를 포함한 애플리케이션의 DB 호출 시간 비중이다. DB 서버의 CPU 사용률은 이 값으로 알 수 없다. 한 요청의 평균 DB 구간은 3.668ms와 3.258ms였지만, 앞선 요청이 쌓이면 자신의 처리 차례까지는 수십 초를 기다릴 수 있었다.
커밋 콜백으로 측정한 구간은 전체 적체 시간의 약 37~38%였고 DB 구간 안에 포함된다. 이를 약 92%에 다시 더하지 않았다. 서버의 COMMIT 통계와 파일 I/O 대기도 관측됐지만, 콜백 시간을 순수 디스크 동기화 시간으로 해석할 근거는 부족했다.
계측을 켠 두 실행이 일관되게 느려지지는 않았으나, 네 번의 비교만으로 오버헤드의 정확한 크기를 판단하기는 어려웠다. 다음 검증 후보는 같은 DB 작업을 트랜잭션당 한 건과 여러 건으로 처리할 때 커밋 고정 비용이 어떻게 달라지는지 비교하는 것이었다. 이 계측 작업에서 서비스의 트랜잭션 단위나 offset 설정을 바꾸지는 않았다.
마무리
Kafka를 붙인 뒤 가장 먼저 달라진 것은 발급 속도보다 접수의 의미였다. 신청을 받아 두었다는 응답과 발급이 끝났다는 결과를 나눴고, 접수된 요청 ID와 최종 DB 결과를 대조했다.
DB 커밋과 offset 커밋 사이의 종료는 같은 레코드의 재전달로 이어졌다. 그때 기존 DB 결과를 재사용하는 처리와 수량·이력·결과의 단일 트랜잭션이 추가 발급을 막았다. DB 오류 뒤에는 원인을 제거하고 Consumer를 수동으로 재개해야 했다.
빠른 접수와 빠른 최종 처리는 각각 측정해야 했다. 복구 시험으로 중단된 신청의 처리 결과를 확인하고, 지연과 Consumer 비용 측정으로 최종 발급을 늦추는 구간을 좁혔다.