선착순 쿠폰 발급과 Redis
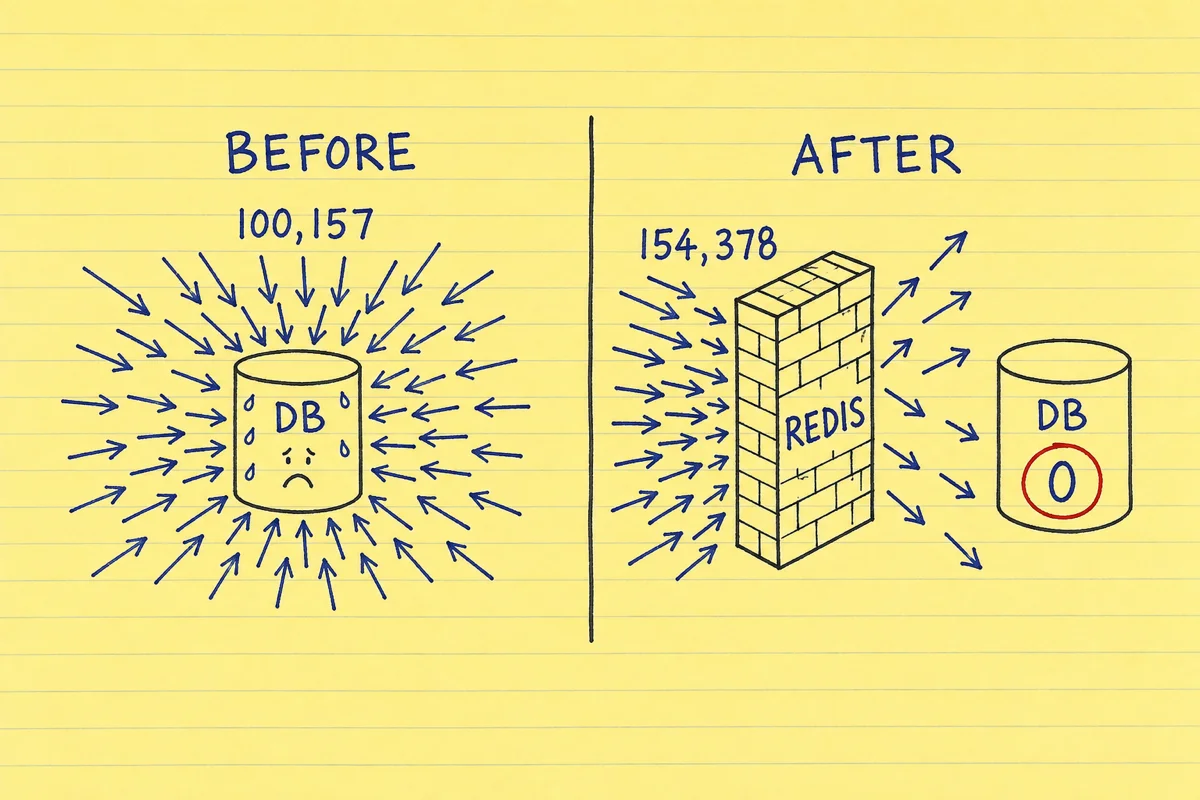
선착순 쿠폰 발급의 정합성은 이미 DB로 닫아둔 상태였다. 조건부 atomic UPDATE와 (coupon_id, user_id) unique constraint를 걸어서, 재고가 100개인 동시성 테스트에서 발급 수와 DB 이력 수가 모두 100개로 맞았다. 전체 코드는 공개 저장소에 있다.
그런데 가상 사용자 300명(300 VUs)으로 부하를 걸어보니 예상 밖의 게 보였다. 정합성은 멀쩡한데, 재고가 소진된 뒤에 들어온 거절 요청 10만여 건이 전부 DB 트랜잭션을 타고 있었다. 정합성만 붙잡고 있느라, 이미 끝난 발급을 두고 거절이 DB를 두드리는 건 보지 못했다.
그래서 발급 성공/실패 판정 자체를 DB 앞의 Redis로 옮겼다. 그게 실제로 뭘 바꿨고 뭘 안 바꿨는지, k6로 Before와 After를 같은 조건에서 재봤다.
정합성은 DB로 지켰지만, 거절까지 DB가 떠안고 있었다
기존 DB 제약은 수량 초과와 중복 발급을 막고 있었다. 바꿔야 할 부분은 재고가 없는 요청까지 DB 쓰기 경로에 들어가는 흐름이었다.
DB 단계 요약 — 조건부 UPDATE와 unique로 정합성은 이미 닫혔다
발급 판정의 1차 방어선은 조건부 atomic UPDATE였다. 발급 수량을 무작정 1 올리는 게 아니라, 이미 발급된 수량이 총 재고보다 작을 때만 1 올리는 단일 UPDATE 문이다.
1
2
3
4
5
update Coupon c
   set c.issuedQuantity = c.issuedQuantity + 1
 where c.id = :couponId
   and c.status = :activeStatus
   and c.issuedQuantity < c.totalQuantity
이 UPDATE 문이 원자적이라는 게 핵심이다. 읽고-판단하고-쓰는 세 동작이 DB 안에서 한 번에 일어나니, 두 요청이 같은 순간에 들어와도 재고를 초과해 발급되는 일이 없다. 재고가 다 찼으면 issuedQuantity < totalQuantity 조건이 거짓이 돼 0행이 갱신된 채 끝난다.
같은 사용자의 중복 발급은 (coupon_id, user_id) unique constraint로 막았다. 한 사람이 같은 쿠폰을 두 번 저장하려 하면 DB가 제약 위반으로 튕겨내고, 그 예외가 트랜잭션 안에서 롤백된다. 이 두 개로 “재고만큼만, 한 사람당 한 번만”이라는 정합성이 완결됐고, 재현·검증 과정은 따로 정리해둔 문서에 있다.
진짜 문제 — 재고가 0이 돼도 거절이 계속 DB를 두드린다
문제는 재고가 소진된 다음이었다. 선착순은 인기 많은 쿠폰일수록 재고보다 훨씬 많은 요청이 몰린다. 재고 100개짜리에 수만 건이 들어오면, 100건이 성공한 뒤의 나머지는 전부 “이미 끝났다”는 거절이다.
그런데 이 거절도 판정을 DB에서 한다. 요청 하나가 들어올 때마다 조건부 UPDATE를 한 번씩 날려보고, 조건이 거짓이라 0행이 갱신되는 걸 확인한 다음에야 거절로 돌아선다. 성공이든 거절이든, 판정을 받으려면 일단 DB 트랜잭션을 한 번 열어야 하는 구조다.
k6 Before 실측에서 이게 그대로 나왔다. 재고 100개짜리 시나리오에서 재고를 초과한 거절 100,157건이 전부 MySQL까지 내려가 요청당 UPDATE를 한 번씩 태웠다.
더 성가신 건 이 헛된 트랜잭션도 DB 커넥션을 하나씩 잡았다 놓는다는 점이다. 거절이 커넥션을 점유하는 만큼, 정작 처리돼야 할 요청이 쓸 커넥션은 줄어든다. 재고가 0이라는 뻔한 사실을 확인하려고 한정된 커넥션을 계속 소모하는 셈이었다.
거절 요청마다 DB에서 잔여 수량을 판정하는 비용이 들었다. 발급이 끝난 뒤에도 이어지는 이 쓰기 시도를 줄일 필요가 있었다.
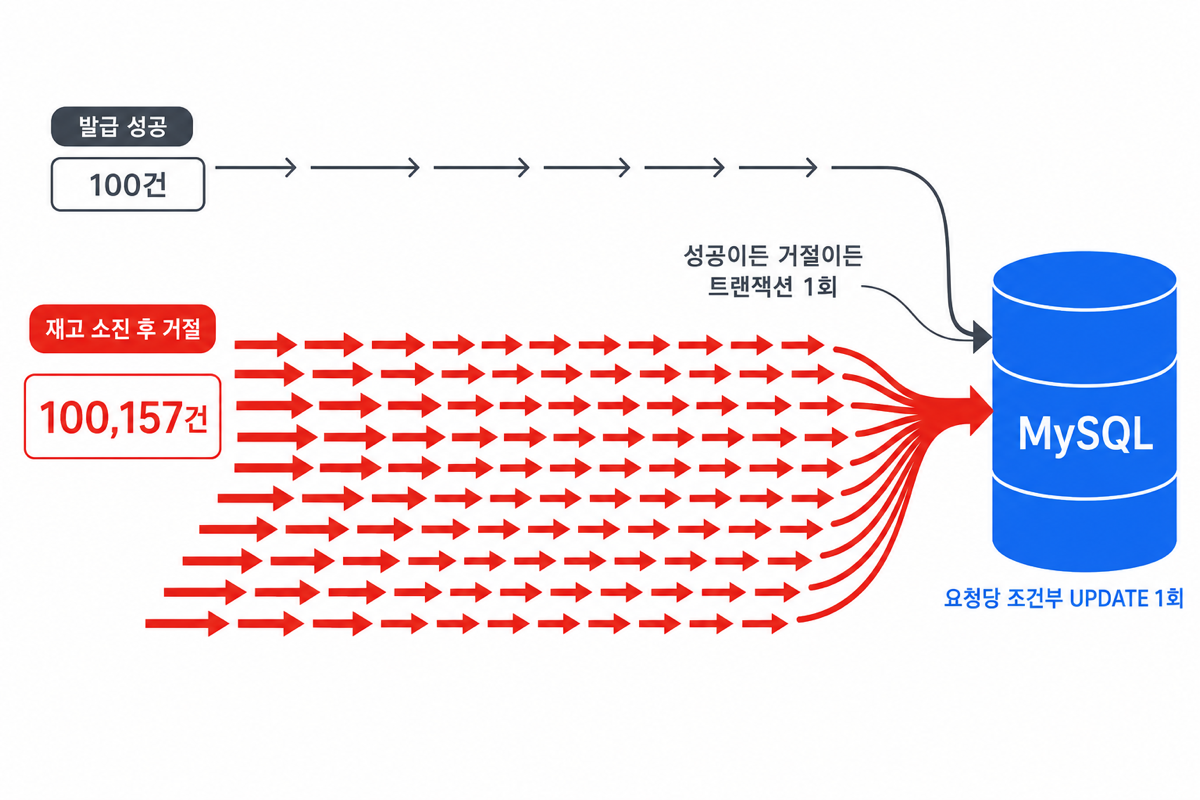 발급은 100건에서 끝났는데, 거절 10만여 건이 전부 같은 DB 트랜잭션을 한 번씩 두드린다
비관적 락은 구현해봤지만 발급 경로엔 올리지 않았다
정합성을 지키는 다른 길로 비관적 락도 만들어봤다. 비관적 락은 충돌이 날 거라고 미리 가정하고, row를 읽는 순간 아예 잠가버리는 방식이다. findByIdForUpdate()에 PESSIMISTIC_WRITE를 걸어 coupon row를 잠그고, 그 잠금 안에서 재고를 확인하고 깎는다.
조건부 UPDATE도 DB 행을 갱신할 때 잠금을 사용한다. 차이는 잠금의 유무가 아니라, 한 UPDATE 안에서 조건과 변경을 처리할지 먼저 행을 잠근 뒤 애플리케이션에서 확인·변경할지에 있다.
비관적 락도 정합성 자체는 문제없이 지킨다. JUnit 동시성 테스트로 재고 100개에 여러 요청을 동시에 던져봐도 정확히 100건만 발급되는 걸 확인했다.
그런데 이걸 발급 HTTP 경로에는 끝내 연결하지 않았다. 실제 발급 엔드포인트는 전부 IssuedCouponService.issueCoupon을 타고, 비관적 락을 쓰는 CouponService.issue()는 어느 컨트롤러에도 물려 있지 않다. 지금도 이 메서드는 동시성 테스트 안에서만 살아 있다.
이유는 락의 구조 자체였다. 선착순 쿠폰은 재고 카운터가 coupon row 하나에 몰려 있어서, 비관적 락을 걸면 모든 발급 요청이 그 한 줄을 두고 직렬로 줄을 선다. 한 요청이 락을 쥐고 재고를 깎아 커밋할 때까지 뒤 요청들은 전부 대기다.
문제는 대기하는 동안 각 요청이 DB 커넥션을 쥔 채로 기다린다는 것이다. 커넥션 풀은 한정돼 있는데, 요청이 몰릴수록 락을 기다리며 커넥션만 붙잡고 있는 요청이 쌓인다.
선착순은 특히 이 구조에 취약하다. 트래픽이 하루 종일 고르게 오는 게 아니라 발급 시작 직후 몇 초에 확 몰리기 때문이다. 하필 요청이 가장 많은 그 순간에 전부가 coupon row 하나의 락을 기다리며 커넥션을 붙잡고 늘어지는 그림이 눈에 보였다.
이 검토에서 관심은 거절 요청까지 같은 DB 쓰기 경로로 보내야 하는가로 옮겨갔다. 비관적 락 경로와의 처리량 비교는 하지 않았고, 이후 k6 비교 대상도 기존 조건부 UPDATE 경로와 Redis를 추가한 경로였다.
발급 판정을 Redis Lua 한 스크립트로 옮겼다
발급 판정을 Redis로 옮긴다는 건, “이미 받은 사람인가, 재고가 남았는가, 재고를 깎고 사용자를 등록한다”까지를 DB에 닿기 전에 끝낸다는 뜻이다. 문제는 이 네 동작이 따로 놀면 안 된다는 것이었다. 재고를 확인하는 순간과 실제로 깎는 순간 사이에 다른 요청이 끼어들면, 재고가 음수로 내려가거나 마지막 한 자리를 두 명이 동시에 가져간다.
예를 들어 재고가 1 남았을 때 두 요청이 거의 동시에 재고를 읽으면, 둘 다 “재고 있음”으로 판단하고 각자 차감을 때린다. 그러면 재고는 -1이 되고 쿠폰은 하나 더 나간다. 명령을 따로따로 부르면 이 틈이 항상 열려 있다.
그래서 네 동작을 Lua 스크립트 하나로 묶었다. Redis는 Lua 스크립트를 통째로 하나의 원자 단위로 실행해서, 스크립트가 도는 동안 다른 명령이 중간에 끼어들지 못한다.
Lua 스크립트 — 네 명령을 한 원자 단위로 묶었다
1
2
3
4
5
6
7
8
9
10
11
12
13
14
local stock = tonumber(redis.call('GET', KEYS[1]))

if redis.call('SISMEMBER', KEYS[2], ARGV[1]) == 1 then
    return -1
end

if stock == nil or stock <= 0 then
    return -2
end

redis.call('DECR', KEYS[1])
redis.call('SADD', KEYS[2], ARGV[1])

return 1
KEYS[1]은 재고 카운터인 coupon:{id}:stock 문자열, KEYS[2]는 이미 발급받은 사용자를 담는 coupon:{id}:users 집합이다. SISMEMBER는 집합에 특정 사용자가 들어 있는지 확인하는 명령이라, 이걸로 중복 발급을 먼저 걸러낸다. 재고가 남아 있으면 DECR로 카운터를 1 줄이고 SADD로 사용자를 집합에 넣는다.
자료구조를 이렇게 나눈 데도 이유가 있다. 재고는 숫자 하나면 되니 문자열 카운터로 두고 DECR로 깎고, 발급받은 사람은 중복 여부만 빠르게 확인하면 되니 집합에 담았다. 집합에서 사용자 포함 여부를 확인하면 발급 이력을 하나씩 순회할 필요가 없다.
스크립트가 실행되는 동안 다른 클라이언트의 명령이 그 중간에 실행되지 않는다. 그래서 재고 확인과 차감 사이에 다른 요청이 끼어들지 못한다.
판정은 Redis의 원자적 실행에 맡기고, 거절 요청은 이후 DB 쓰기 단계로 보내지 않았다. Redis에서도 스크립트 실행은 직렬화되므로 대기 자체가 없어진다는 뜻은 아니다.
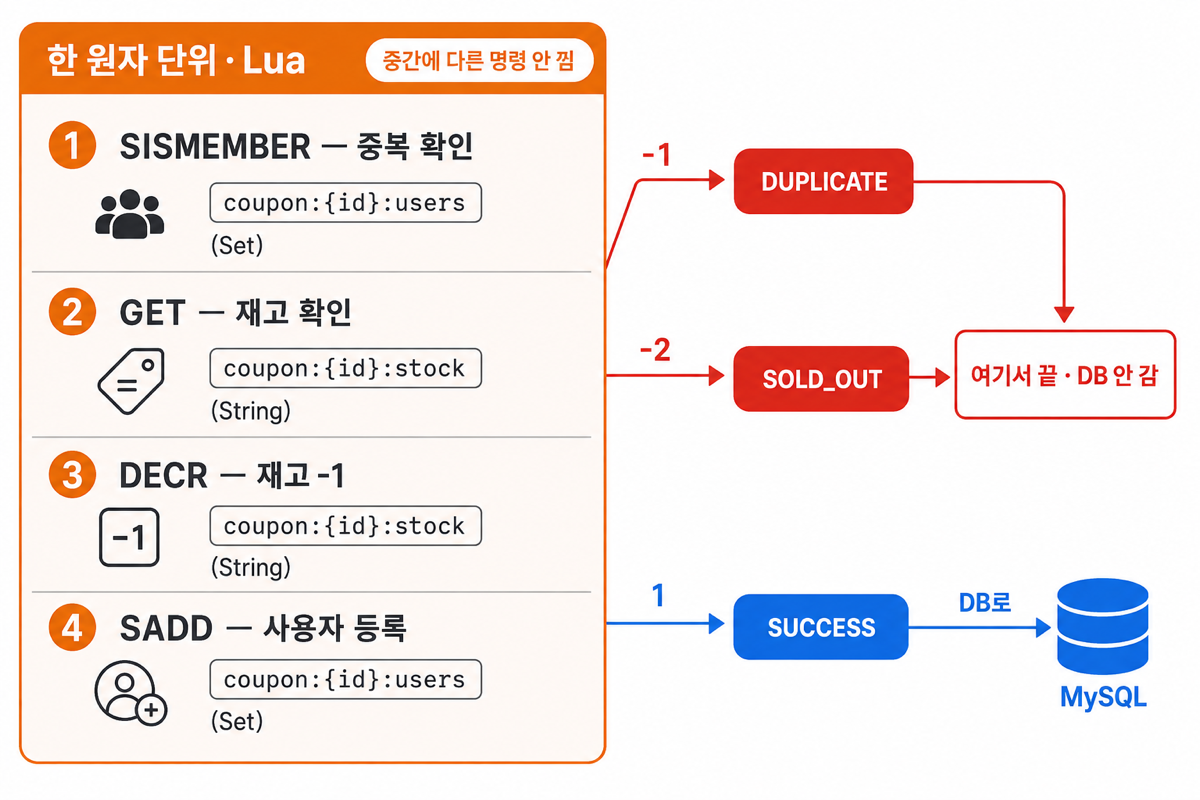 네 명령이 한 원자 블록 안에서 돌고, 세 갈래 중 성공만 DB로 내려간다
반환값 세 갈래 — 성공만 DB로 내려보낸다
CouponIssueResult enum이 스크립트의 반환값을 받아 SUCCESS·DUPLICATE·SOLD_OUT 판정으로 바꾼다.
발급 요청 한 건은 쿠폰을 조회해 발급 기간 안인지 확인한 다음, 이 Redis 판정을 부른다. 결과가 성공이 아니면 예외를 던져 이후 발급 수량 UPDATE와 이력 저장을 건너뛴다.
재고가 소진된 뒤의 요청은 SOLD_OUT으로 이 지점에서 끝난다. 단, Redis 판정 전에 쿠폰을 조회하는 DB 읽기는 남아 있다. 아래 측정과 그림의 ‘DB 도달 0건’은 발급 수량 UPDATE·이력 저장 단계에 들어간 거절이 없다는 범위로 읽어야 한다.
DB 저장이 실패하면 Redis를 되돌려야 했다
판정을 Redis로 옮기니 새 문제가 생겼다. Redis에서 먼저 재고를 깎고 사용자를 등록한 다음 DB에 발급 레코드를 저장하는데, 이 DB 저장이 실패하면 어긋난다. Redis는 이미 “이 사람에게 발급됨”으로 바뀌었는데 실제 발급 레코드는 없는 상태가 되는 것이다.
DB 저장이 실패하는 경우는 드물지만 분명히 있다. 커넥션을 제때 못 잡아 타임아웃이 나거나, 저장 직전에 조건부 UPDATE가 재고 조건을 통과하지 못할 수도 있다. 확률이 낮아도 재고와 실제 발급이 어긋나는 순간이 한 번이라도 나오면 선착순에선 그대로 사고다.
재고를 한 곳(Redis)에서 깎고 실제 발급을 다른 곳(DB)에 쓰는 이중 쓰기가 만든 구조적 위험이었다. 그래서 실패하면 Redis를 원래대로 되돌리는 보상 rollback을 붙였다.
1
2
3
4
Long removed = redisTemplate.opsForSet().remove(usersKey, userId.toString());
if (removed != null && removed > 0) {
    redisTemplate.opsForValue().increment(stockKey);
}
SREM으로 사용자를 집합에서 빼고, 그 제거가 실제로 성공했을 때만(removed > 0) INCR로 재고를 되돌린다. 제거 여부를 안 보고 무조건 재고를 늘리면, 이미 빠진 사용자에 대해 재고만 한 번 더 올라 실제보다 부풀 수 있다.
rollback을 발급 흐름 어디에서 부르는지가 나머지 절반이다. issueCoupon()은 Redis 판정을 통과한 뒤에도 DB 단계를 그대로 밟는다. 먼저 조건부 atomic UPDATE를 한 번 더 태우고, 그게 통과하면 발급 레코드를 saveAndFlush()로 즉시 밀어 넣어 unique 위반을 트랜잭션 안에서 잡는다.
즉 성공 요청은 Redis 판정과 DB 쓰기를 둘 다 거친다. Redis는 거절을 앞에서 걷어내는 1차 관문이고, DB atomic UPDATE와 unique constraint는 성공 요청의 최종 정합성을 확정하는 2차 방어선으로 그대로 남겨뒀다.
그래서 rollback을 부르는 지점도 이 DB 단계다. 조건부 UPDATE가 0행을 갱신해 updated == 0으로 떨어지면 rollback 후 CouponExhaustedException을 던지고, 저장 중 예외가 잡히면 catch에서 rollback한 뒤 예외를 다시 올린다. Redis에서 성공으로 판정했어도 DB 단계가 실패하면 이 보상 처리를 시도한다. 다만 SREM과 INCR은 별도 호출이므로 두 호출 사이의 종료나 보상 자체의 실패까지 원자적으로 복구하는 코드는 아니다.
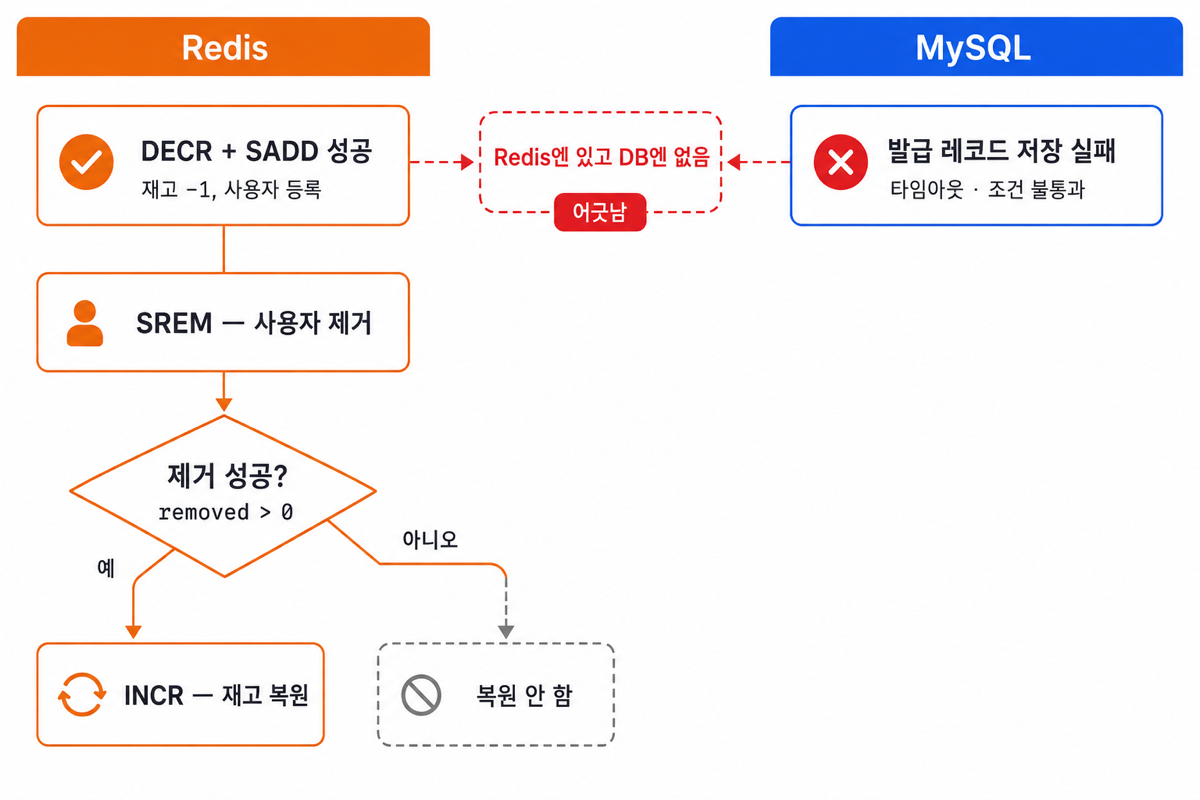 Redis가 먼저 깎은 재고를, DB 저장이 실패하면 제거에 성공했을 때만 되돌린다
정합성은 재설계 후에도 그대로였다
판정 위치를 DB에서 Redis로 옮겼어도, “재고만큼만, 한 사람당 한 번만”이라는 등식은 그대로 지켜야 했다. 판정하는 자리가 바뀌면 정합성이 깨질 여지도 새로 생기니, 동시성 테스트로 다시 확인했다.
동시 1,000 요청(스레드풀 50)으로 재고 100개짜리 쿠폰을 두드렸더니 정확히 100건만 성공하고, DB 저장도 정확히 100건이었다. 재고보다 열 배 많은 요청이 한꺼번에 몰려도 초과 발급은 한 건도 없었다.
같은 사용자가 100번 동시에 요청하는 경우도 따로 확인했다. 한 사용자의 반복 요청이 중복 발급으로 이어지지 않는지 확인하려는 시나리오다. 이 테스트에서는 발급이 1건만 나갔고, Redis 집합과 DB unique constraint가 양쪽에서 겹쳐 걸러낸 결과다.
k6 부하 테스트에서도 마찬가지였다. Before든 After든 재고 100 시나리오에서 발급 수는 정확히 100, DB 저장 수도 100으로 떨어졌다. 판정을 어디서 하느냐를 바꿔도 발급 수 = DB 저장 수 = 재고라는 등식은 흔들리지 않았다.
k6로 Before와 After를 같은 조건에서 재봤다
Before와 After를 나란히 놓고 재려면 두 버전이 완전히 같은 부하를 받아야 했다. 그래서 커밋을 오가며 같은 시나리오를 그대로 돌렸다. Before는 Redis를 붙이기 전 atomic UPDATE HTTP 경로(14f95c6), After는 Redis Lua 판정이 들어간 현재 main(1071dac)이다.
측정 환경 — 로컬 단일 호스트, 300 VUs 30초
앱과 MySQL, Redis, k6를 전부 한 macOS 머신에서 돌렸다. MySQL과 Redis는 docker compose로 띄우고(MySQL은 13306 포트), Spring Boot는 8080에서, --spring.jpa.show-sql=false로 쿼리 로그 출력 부하를 뺀 상태였다.
부하는 k6의 constant-vus 방식으로 걸었다. VU는 가상 사용자(virtual user)를 뜻하고, constant-vus는 정해진 수의 가상 사용자를 시험 내내 일정하게 유지하는 패턴이다. 여기서는 300명이 30초 동안 쉬지 않고 발급 요청을 던지는 상황을 만들었다.
한 가지 신경 쓴 건 userId였다. 요청마다 RUN_SEED·VU·ITER를 조합해 전 실행에서 겹치지 않는 고유 userId를 만들었다. 같은 사용자로 계속 때리면 중복 방어(DUPLICATE)에 먼저 걸려 재고 경쟁이 제대로 측정되지 않으니, 매 요청을 다른 사람으로 위장한 셈이다.
시나리오를 바꿀 때마다는 새 쿠폰을 만든 뒤 stock/init으로 재고를 초기화해, 앞 시나리오의 상태가 다음 측정에 새지 않게 했다.
결과 표 — 처리량과 발급 DB 쓰기 진입을 함께 본다
| 300 VUs · 30초 | Before (atomic UPDATE) | After (Redis Lua) |
|---|---|---|
| 선착순 재고 100 — 처리량 | 3,325 RPS | 5,112 RPS (+54%) |
| 선착순 재고 100 — p50 / p95 | 88.4ms / 102.1ms | 55.8ms / 94.3ms |
| 선착순 재고 100 — 발급 수 | 정확히 100 (DB 100) | 정확히 100 (DB 100) |
| 거절의 발급 UPDATE·이력 저장 진입 | 100,157건 MySQL UPDATE 시도 | 154,378건 Redis 거절, 이후 DB 쓰기 0건 |
| 재고 충분 100,000 — 처리량 | 674 RPS · p50 444ms | 663 RPS · p50 450ms |
| 5xx | 0건 | 0건 |
p50과 p95는 응답 시간의 분포를 보는 값이다. p50은 요청의 절반이 이 시간 안에 끝났다는 중앙값이고, p95는 95%가 이 시간 안에 끝났다는 뜻이라 느린 꼬리를 본다. 총 45만여 요청에서 양쪽 모두 5xx는 0건이었고, 발급 수와 DB 이력 수가 일치했다. 이 결과는 해당 부하 조건에서 관측한 범위다.
발급 구간 — 성공 요청의 DB 쓰기는 그대로 남았다
표에서 먼저 눈길이 가야 하는 건 재고 충분 시나리오다. 재고를 100,000개로 넉넉히 잡아 거의 모든 요청이 실제 발급으로 이어지게 하면, Before 674 RPS와 After 663 RPS로 사실상 같다. 판정을 Redis로 옮겼는데도 이 구간은 빨라지지 않았다.
성공 요청은 Redis 판정을 통과해도 DB atomic UPDATE와 이력 저장을 그대로 거친다. 측정 환경의 HikariCP 커넥션 풀은 10개였고, 두 경로의 처리량은 약 660~670 RPS 수준이었다.
커넥션 풀은 앱이 재사용하는 DB 연결 묶음이다. 연결 10개 제한과 같은 coupon 행의 갱신 대기가 함께 영향을 줄 수 있으므로, 이 결과만으로 풀 크기 하나를 유일한 병목이라고 확정할 수는 없다.
이 비교에서 확인한 것은 성공 요청의 쓰기 경로를 유지한 채 Redis 판정을 추가해도 발급 구간 처리량이 개선되지 않았다는 점이다.
재고 100 시나리오의 처리량이 3,325에서 5,112 RPS로 오른 것도 같은 렌즈로 봐야 한다. 발급 자체가 빨라진 게 아니라, 재고 소진 후의 거절이 발급 UPDATE를 거치지 않고 Redis에서 끝나면서 전체 요청의 평균 처리 시간이 짧아진 결과다.
Redis의 이득은 발급이 아니라 거절 구간에 있었다
거절 요청의 발급 쓰기 진입은 분명히 달라졌다. Before는 100,157건이 MySQL UPDATE를 시도했고, After는 154,378건을 Redis가 거절해 이후 DB 쓰기 진입이 0건이었다.
30초 동안 벌어진 일이라, Before는 초당 3,300건 남짓의 아무것도 발급하지 못하는 UPDATE를 DB에 계속 흘려보낸 셈이다.
재고 충분 구간의 674 vs 663이라는 결과는 이번 변경의 이득이 성공한 발급보다 재고 소진 뒤 거절 처리에 집중됐음을 보여준다.
그러니 이번 재설계가 한 일은 병목을 없앤 게 아니라, 병목에 닿을 필요 없는 거절을 병목 앞에서 걷어낸 것이다.
처리량 숫자만 보면 재고 충분 구간은 “효과 없음”으로 읽힌다. 하지만 재고보다 요청이 훨씬 많은 선착순에서 실제로 위험한 건, 재고가 소진된 뒤에도 몰려드는 거절이 DB를 얼마나 두드리느냐다.
불필요한 UPDATE 시도를 줄이면 다른 DB 작업과 경쟁하는 부담도 줄일 수 있다. 이번 실험에서 직접 확인한 범위는 거절 요청의 발급 UPDATE·이력 저장 진입이 0건이 됐다는 점이다.
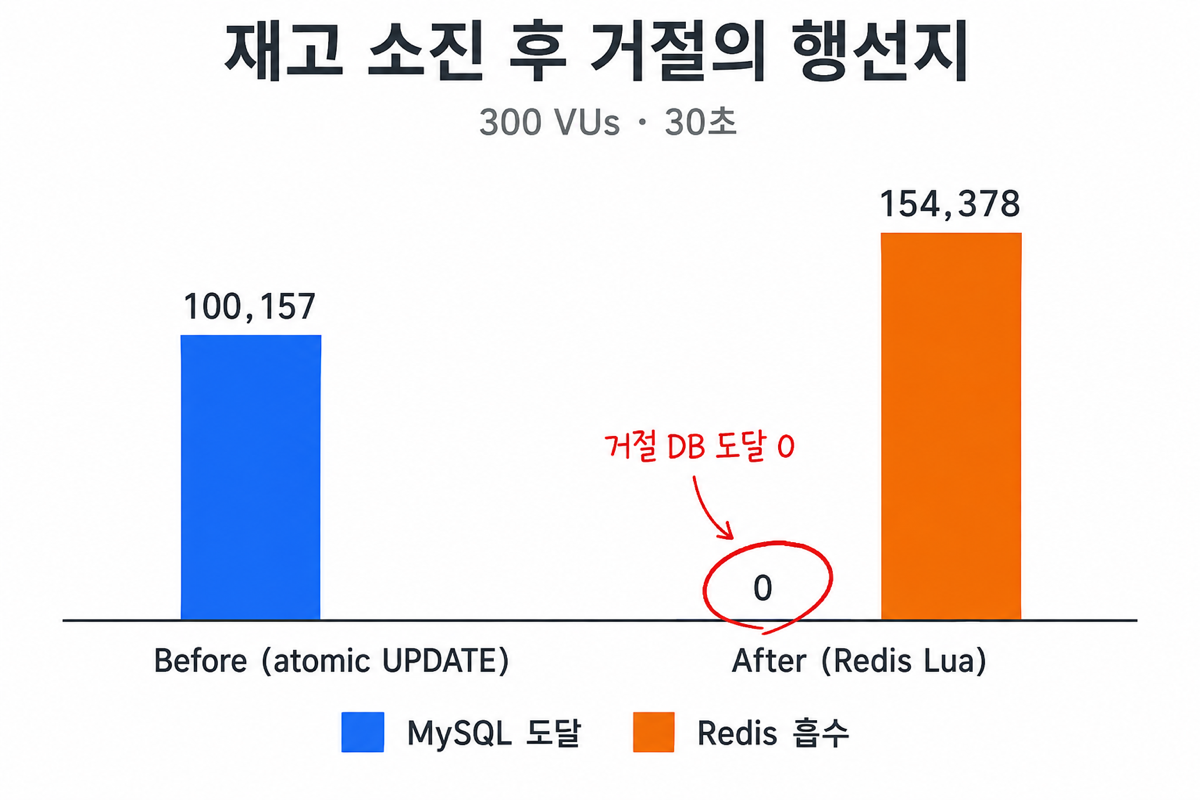 Before의 거절은 발급 UPDATE를 시도하고, After의 거절은 Redis에서 끝나 이후 DB 쓰기 진입이 0이 된다
이 숫자는 로컬 단일 호스트에서 나왔다
이 숫자들이 어디까지 유효한지는 분명히 해둬야 한다. 앱과 MySQL, Redis, k6가 전부 한 머신에서 돌았으니 네트워크 지연이 거의 없고, 처리량은 HikariCP 풀 크기에 크게 의존한다. 풀 크기나 DB 배치를 바꾸었을 때 660~670 RPS 수준이 어떻게 달라지는지는 별도 측정이 필요하다.
그래서 5,112 RPS나 674 RPS 같은 절대값을 그대로 다른 환경에 옮겨 읽으면 안 된다. 실제 서비스라면 앱과 DB 사이에 네트워크가 끼고 커넥션 풀도 다르게 잡히니, 같은 코드라도 수치는 얼마든지 달라진다. 이 숫자들은 같은 머신에서 Before와 After를 같은 조건으로 비교하기 위한 상대 지표에 가깝다.
마무리
정합성은 애초에 DB로 풀려 있던 문제였다. 이번 재설계가 실제로 바꾼 건 정합성이 아니라, 재고가 소진된 뒤 거절이 DB에 얹던 부하였다. 정합성과 부하 내성은 같은 문제가 아니라는 걸, 정합성이 다 맞는데도 거절이 DB를 태우는 걸 보고서야 갈라 봤다.
가장 인상 깊었던 건 같은 표를 두 가지로 읽을 수 있다는 점이었다. 처리량 행(674 vs 663)만 보면 “효과 없음”인데, 거절 행선지 행을 보면 이야기가 완전히 뒤집힌다. 어느 지표를 보느냐가 결론을 바꿨다.
이번 변경은 재고가 없는 요청의 발급 쓰기를 Redis 앞단에서 줄였다. 쿠폰 조회와 성공 요청의 DB 저장은 남아 있으므로, DB 부하 전체가 사라진 것으로 해석하지 않는다.
발급 기록을 비동기로 저장하는 확장은 별도 과제다. 이번에 검증한 범위는 Redis의 사전 판정과 동기 DB 저장까지다.