LLM 대기 중 DB 연결을 닫고 결과 발행 권한을 확인하기
EDGE의 ETF 분석은 원천 자료를 읽고 LLM을 호출한 뒤, 분석 결과와 그 근거를 PostgreSQL에 저장한다. 전망 결과를 오전 8시까지 준비하려고 병렬 실행을 검토하던 중, 분석 한 건이 LLM 응답을 기다리는 동안에도 쓰기용 DB 연결 세 개를 유지한다는 제약이 드러났다.
SQL을 실행하지 않는 동안 연결을 반환하면 더 많은 분석을 실행할 여지가 생긴다. 하지만 당시 연결은 데이터 저장뿐 아니라 같은 분석이 겹치지 않도록 잡아 둔 세션 락도 유지했다. 연결을 닫으려면 그 락이 맡던 역할을 다른 곳으로 옮겨야 했다.
내가 제기한 문제는 LLM 대기와 DB 연결의 수명을 분리할 수 있느냐는 것이었다. 처음에는 만료 시간이 있는 DB lease를 제안했지만, 대안을 검토한 뒤 기존 Step Functions 실행 ARN과 실행 슬롯을 재사용하기로 했다. 조사·구현·실험은 AI 에이전트가 수행했고, 나는 적용 방향과 단계별 유료 실험, 실험 뒤 설정 복원을 결정했다.
분석 한 건이 LLM 대기 중에도 쓰기 연결 세 개를 유지했다
기존 클라우드 워커의 연결 세 개는 각각 역할이 있었다. 하나는 ETF 단위 중복 실행과 동시 실행 수를 제한하는 락을 유지했고, 다른 하나는 분석 ID 단위 락과 결과 저장을 맡았다. 나머지 하나는 LLM이 호출한 툴의 실행 기록을 저장했다.
툴 기록은 최종 분석이 어떤 입력과 계산을 근거로 만들어졌는지 확인하는 자료다. 분석이 끝날 때 한 번만 쓰는 결과와 달리, 모델이 툴을 호출할 때마다 남는다. DB 연결은 툴 기록을 저장할 때 필요했고, 다음 모델 응답을 기다리는 동안에는 사용하지 않았다.
세션 단위 advisory lock은 락을 얻은 DB 세션과 수명을 같이한다. 연결을 닫으면 락도 풀리므로, 나중에 다시 연결하더라도 그사이에 다른 실행이 시작될 수 있었다.
기존 구조를 유지하면 동시 분석 3건에 쓰기 연결 9개가 필요했다. 동시 수를 늘릴수록 DB에서 실제로 일하는 시간보다 외부 응답을 기다리며 연결을 잡고 있는 시간이 부담이 됐다. 연결 수 한도를 높이는 것만으로는 이 구조가 바뀌지 않는다.
기존 코드와 로컬 장애 시험에서는 모델 응답 뒤 DB 연결이 끊어져 있으면 분석이 실패하는 경로도 확인했다. 모델 호출을 마쳤어도 결과 저장에 실패하면 해당 분석을 완료할 수 없었다.
별도 만료 시간을 만들지 않고 기존 실행 슬롯을 재사용했다
기존 구조로도 동시 분석 3건은 가능했다. 다만 병렬 실행을 늘리려는 상황에서는 LLM 대기 내내 연결을 유지하는 부담이 그대로 남았다. 큐와 고정 워커로 바꾸는 안은 접수·배치·상태 조회 API·배포 구조까지 변경 범위가 커졌다.
DB 단계마다 연결하는 방식은 기존 클라우드 실행 구조를 유지하면서 대기 중 연결을 닫을 수 있었다. 이 방식을 택하려면 세션 락이 맡던 실행 제어를 대신할 수 있어야 했다.
클라우드에는 analysis_execution_slots라는 테이블이 있었다. 단건 분석을 실행하는 Step Functions의 실행 ARN을 기록하고, 같은 종류·ETF의 분석이 겹치지 않게 하며 전체 동시 실행 수를 제한하는 테이블이다. ARN은 여기서 어느 실행이 슬롯을 차지하고 있는지 구분하는 식별자다.
이 슬롯은 시간이 지났다는 이유만으로 회수하지 않는다. 실행 이력이나 ECS 조회에서 태스크가 STOPPED라는 증거를 얻거나, 해당 실행이 태스크 제출 단계에 도달하지 않았음을 확인해야 회수한다. ECS가 MISSING을 반환하거나 조회 결과가 비어 있다는 사실만으로는 종료했다고 판단하지 않는다.
DB lease를 추가하면 새 테이블뿐 아니라 만료 시간, heartbeat를 통한 갱신, 갱신하지 못한 실행을 처리하는 정책도 필요했다. 기존 슬롯은 실행 종료를 확인해 회수하므로 별도의 시간 만료 정책을 추가하지 않고 재사용하기로 했다. 대신 결과를 발행하는 순간에도 자신의 슬롯이 남아 있는지 확인하는 조건을 붙였다.
변경 대상은 실행 ARN을 전달하는 클라우드 워커였다. 실행 ARN을 받지 않는 구버전 클라우드 경로와 로컬 대시보드는 기존 락 방식을 유지했다.
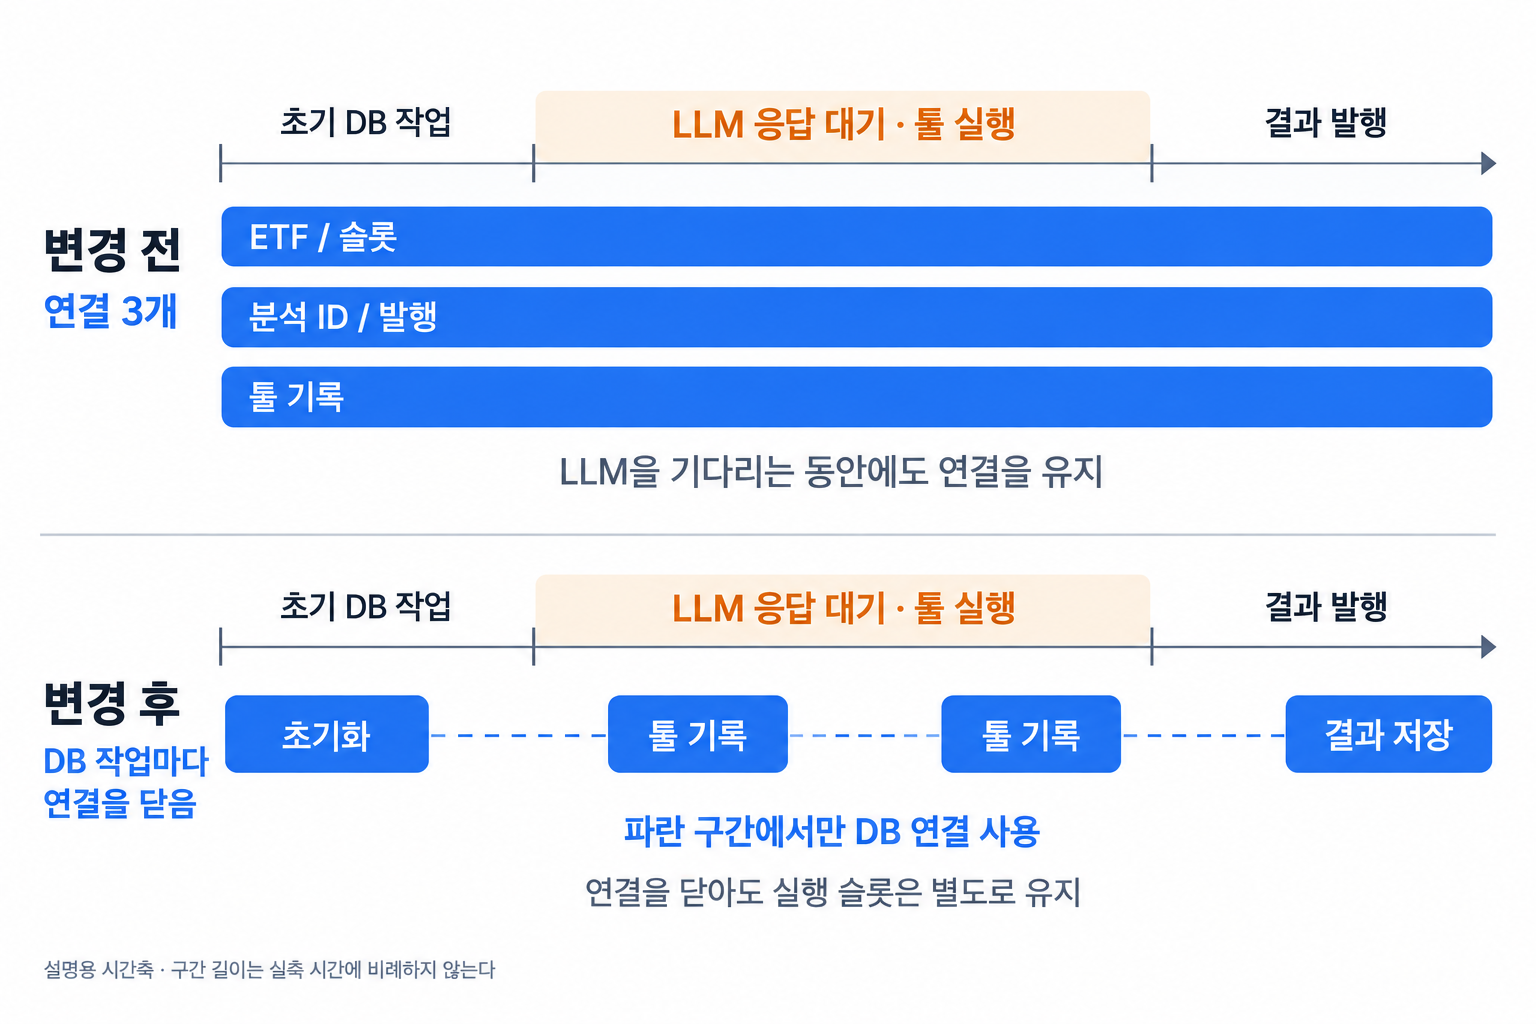 LLM을 기다리는 동안 DB 연결은 닫고, 실행 슬롯은 별도로 유지한다
결과 발행 트랜잭션에서 슬롯이 남아 있는지 확인했다
분석 결과를 저장하는 PublicationStore는 이미 완료된 분석이면 저장된 결과를 반환한다. 새로 발행해야 한다면 같은 트랜잭션 안에서 자신의 실행 ARN으로 슬롯 행을 조회한다.
1
2
3
4
SELECT 1
FROM analysis_execution_slots
WHERE execution_arn = %s
FOR SHARE;
행이 없으면 OwnershipLost 예외를 내고 새 결과를 발행하지 않는다. 행이 있으면 FOR SHARE로 잠근 상태에서 결과 저장을 이어간다. 슬롯 확인과 결과 저장은 같은 트랜잭션에서 수행한다.
슬롯 회수는 해당 행을 DELETE한다. 이 삭제와 발행의 FOR SHARE가 같은 행의 잠금을 두고 경합하므로, 권한 확인과 결과 저장 사이에 회수가 끼어들지 못한다. 먼저 잠금을 잡은 트랜잭션에 따라 두 경우로 나뉜다.
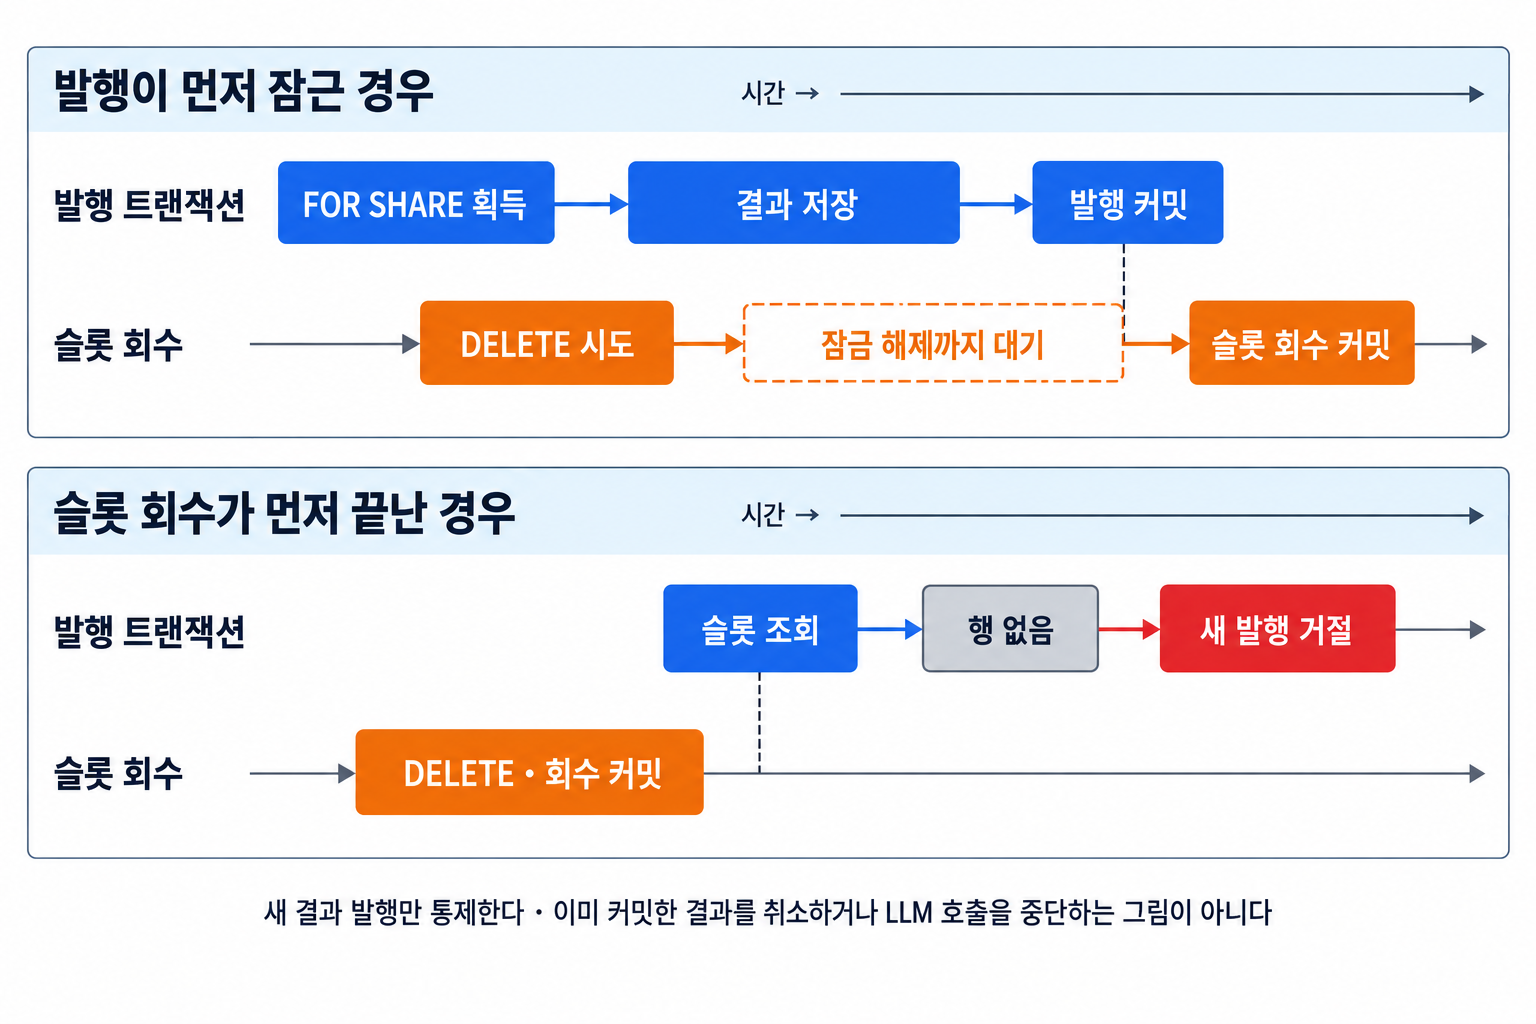 슬롯 확인과 결과 저장을 같은 트랜잭션에 넣어 발행과 회수의 순서를 정한다
이미 커밋한 분석 결과는 슬롯을 다시 확인하지 않고 후속 전달 원장에 등록한다. 발행 후 전달 등록 전에 중단됐더라도, 확정된 결과의 전달을 복구할 수 있어야 하기 때문이다.
연결 재시도 — 모델을 다시 호출하지 않고 DB 단계만 반복한다
짧은 연결에서는 연결 생성 자체가 더 자주 일어난다. 일시적인 연결 거절이나 세션 종료는 해당 DB 단계 전체를 제한된 시간 안에서 재시도하도록 바꿨다. 제약 위반이나 입력 오류, SQL 문장 시간 초과까지 같은 방식으로 재시도하지는 않는다.
단계를 반복하려면 같은 요청을 다시 수행해도 결과가 달라지지 않아야 한다. 시작 기록은 같은 ID의 입력을 비교하고, 완료된 발행은 기존 결과를 반환한다. 툴 기록도 같은 ID가 있다는 이유만으로 성공으로 넘기지 않고, 저장된 내용까지 같을 때만 재사용한다.
이 조건 덕분에 DB 커밋은 끝났지만 응답을 받지 못한 경우에도 저장 상태를 다시 확인할 수 있다. 재시도 과정에서 LLM을 다시 호출하지 않으므로, DB 연결 문제 때문에 모델 작업 전체를 반복하는 범위를 줄였다. 다만 DB 장애가 재시도 제한을 넘기면 해당 분석은 실패할 수 있다.
발행 권한 검사는 권한을 잃은 실행의 새 결과 발행을 막는다. 이전 워커의 LLM 호출이나 자기 분석 ID에 묶인 툴 기록은 계속될 수 있어, 모델 호출 비용과 전체 처리의 중복 실행까지 막지는 못한다.
로컬에서는 연결을 점유한 시간의 합을 따로 측정했다
2026년 10월 3일 로컬 시험은 PostgreSQL 16과 실제 클라우드 워커·저장 코드를 사용했다. LLM은 실제로 호출하지 않고 30초 대기와 툴 호출 40회를 재현하는 테스트 코드로 대체했다. 원천 자료와 S3, Step Functions·ECS 응답도 시험용 대체 구현을 사용했다.
비교 지표는 연결·초다. DB 연결 하나를 10초 유지하면 10 연결·초이고, 세 개를 같은 10초 동안 유지하면 30 연결·초다. 실행 시간이 같아도 연결을 더 오래, 더 많이 유지하면 이 값이 커진다.
아래는 동시 37건에서 기존 구조(604e5e9f)와 최종 구현(e5c0f1e1)을 비교한 결과다. writer·reader 역할의 연결 한도를 해제한 조건이며, PostgreSQL 전체의 연결 제한을 없앤 것은 아니다.
연결 수명의 차이를 확인하려고 당시 배포보다 동시 수를 높였다. 실제 RDS의 연결 수 감소율과 실제 모델 37건의 동시 처리 능력은 이 시험에서 측정하지 않았다.
연결 점유와 최대 연결 수는 클라이언트에서 연결을 열고 닫는 구간을 계측한 값이다. 서버 상태를 주기적으로 조회한 연결 수 표본과는 구분하며, 기존 구조의 3,392 연결·초는 원시 측정 3,391.8을 반올림했다.
| 측정 항목 | 기존 구조 | 최종 구현 |
|---|---|---|
| 쓰기 연결 점유 시간의 합 | 3,392 연결·초 | 20.6 연결·초 |
| 동시에 열린 쓰기 연결 최댓값 | 111개 | 21개 |
| 저장 완료 | 37/37건 | 37/37건 |
기존 구조에서는 37건이 각각 연결 세 개를 유지해 최대 111개가 열렸다. 변경 후에는 LLM 대기 시간이 연결 점유에서 빠졌다.
쓰기 연결 20개·읽기 연결 6개로 역할 한도를 둔 별도 시험에서도 최종 구현은 37건을 모두 저장했다. 이때 쓰기 연결 점유는 11.1 연결·초였고, 읽기 연결 거절 이후 재시도는 67회였다. 역할별 연결 한도를 해제한 위 비교와는 별도 조건이다.
재시도 간격 — 동시에 다시 접속하면 연결 거절이 반복됐다
한도를 둔 초기 구현에서는 37건 중 36건만 저장됐다. 함께 연결을 거절당한 워커들이 같은 간격으로 다시 접속하면서, 한 실행이 재시도 제한을 소진했다. 재시도 대기 시간에 무작위 차이를 주는 지터를 넣은 뒤에는 반복 시험 세 번에서 모두 37건이 저장됐다.
성공 여부와 별도로 장애 위치도 확인했다. 모델 응답 뒤 5초간 DB 로그인을 거절하는 시험에서는 세 건이 모두 재시도로 완료됐고, 모델을 추가 호출하지 않았다. 발행 도중 세션을 강제로 끊는 경우와 커밋 응답을 잃는 경우에도 재시도 후 행 수가 기준과 일치했다.
통합 테스트는 발행과 슬롯 회수의 순서도 다뤘다. 발행 트랜잭션이 슬롯을 잠근 동안 회수가 기다리는 경우, 회수가 먼저 끝나 이전 워커의 발행이 거절되는 경우를 나눠 확인했다. 연결 수치가 좋아졌어도 이 보호가 깨졌다면 채택할 수 없는 변경이었다.
개발 환경의 병렬 실행에서는 분석 시작 대기가 줄었다
AWS 개발 환경에서는 실제 모델을 호출하는 별도 시험을 진행했다. 2026년 10월 4일 정기 실행의 동시 수 3과, 같은 날 수동 실행의 동시 수 37을 비교했다. 두 실행 모두 DB 연결 방식을 바꾼 뒤의 결과로, 동시 수에 따른 실행 시간을 비교한 시험이다.
측정 기록상 두 실행은 같은 원천 스냅샷을 사용했다. 완료된 결과를 재사용하지 않도록 수동 실행의 분석 기준시각은 정기 실행보다 2분 뒤로 지정했다.
전체 배치 시간은 부모 Step Functions 실행의 시작부터 종료까지다. 첫 시도 대기는 같은 시작점을 기준으로 각 37종의 첫 단건 실행이 시작될 때까지 측정했다. 단건 시간은 실패 시도 7건을 제외한 성공 실행 34건의 시작부터 종료까지이므로, LLM 호출만의 시간은 아니다.
| 측정 항목 | 동시 수 3, 정기 실행 | 동시 수 37, 수동 실행 |
|---|---|---|
| 전체 배치 시간 | 76분 46초 | 13분 5초 |
| 첫 시도 시작까지 대기 중앙값 | 2,039초 | 17초 |
| 성공한 단건 실행 시간 중앙값 | 360초 | 354초 |
| 입력 / 저장 | 37종 / 34종 | 37종 / 34종 |
| 배치 최종 상태 | FAILED | FAILED |
성공한 단건 실행의 중앙값은 거의 같았고, 가장 크게 줄어든 것은 첫 시도 시작까지의 대기였다. 동시 수가 낮을 때 앞선 분석이 끝나기를 기다리던 시간이 줄면서 전체 배치도 일찍 끝났다.
입력 오류 — 34종을 저장했지만 배치는 FAILED로 끝났다
두 실행 모두 입력 검증에서 거부된 세 종은 두 차례 시도 후에도 저장되지 않았다. 별도로 발생한 ToolInputError 한 건은 각 실행에서 재시도로 회복해, 실패 시도는 각각 총 7건이었다.
유효 입력 34종의 저장과 전체 목표 37종의 저장은 다른 결과이므로, 배치 상태도 FAILED로 남았다. 팀원이 담당한 분석 로직과 입력 오류 원인 조사는 이번 연결 변경의 성과에 포함하지 않았다.
실험은 일요일 개발 환경의 단회 비교이며, 수동 실행은 12종으로 먼저 확인한 뒤 37종으로 확대했다. 10월 4일 실험 뒤에는 동시 수를 당시 값인 3으로 복원했고, 10월 6일에는 평시 설정이 12로 변경됐다.
개발 환경 로그에 남긴 연결 생성 시간과 DB 단계 시간도 연결·초와는 다르다. 연결 생성 시간은 성공한 연결을 만드는 비용이고, 단계 시간은 연결 준비와 처리 시간을 함께 포함한다. 다른 서비스가 사용하는 연결까지 섞인 RDS 전체 연결 수로 로컬의 감소율을 다시 계산하지 않았다.
마무리
LLM 대기 중 연결을 반환하는 일은 close() 위치를 옮기는 것으로 끝나지 않았다. 연결이 유지하던 락의 역할을 확인하고, 기존 실행 슬롯을 재사용하며, 새 결과를 저장하는 트랜잭션에서 그 권한을 검사해야 했다.
로컬 시험은 연결을 점유한 시간의 합과 장애 이후 저장 동작을 확인했다. 개발 환경 시험은 실제 모델을 실행하며 동시 수를 늘렸을 때 시작 대기가 어떻게 달라지는지 보여줬다. 지표와 환경을 분리해야 어느 변경이 무엇을 개선했는지 설명할 수 있다.
DB 연결은 필요한 구간에서 사용하고, 발행 권한은 실행 기록과 트랜잭션으로 확인한다. 두 역할을 분리해 LLM 대기 중의 연결 점유를 줄이면서도 결과 저장을 통제할 수 있었다.