Python 워커와 ECS Task로 구성한 일 배치 파이프라인
하루치 데이터를 raw에서 canonical까지 처리하는 초기 배치 파이프라인을 만들며 언어·실행 모델·오케스트레이션을 고른 과정.
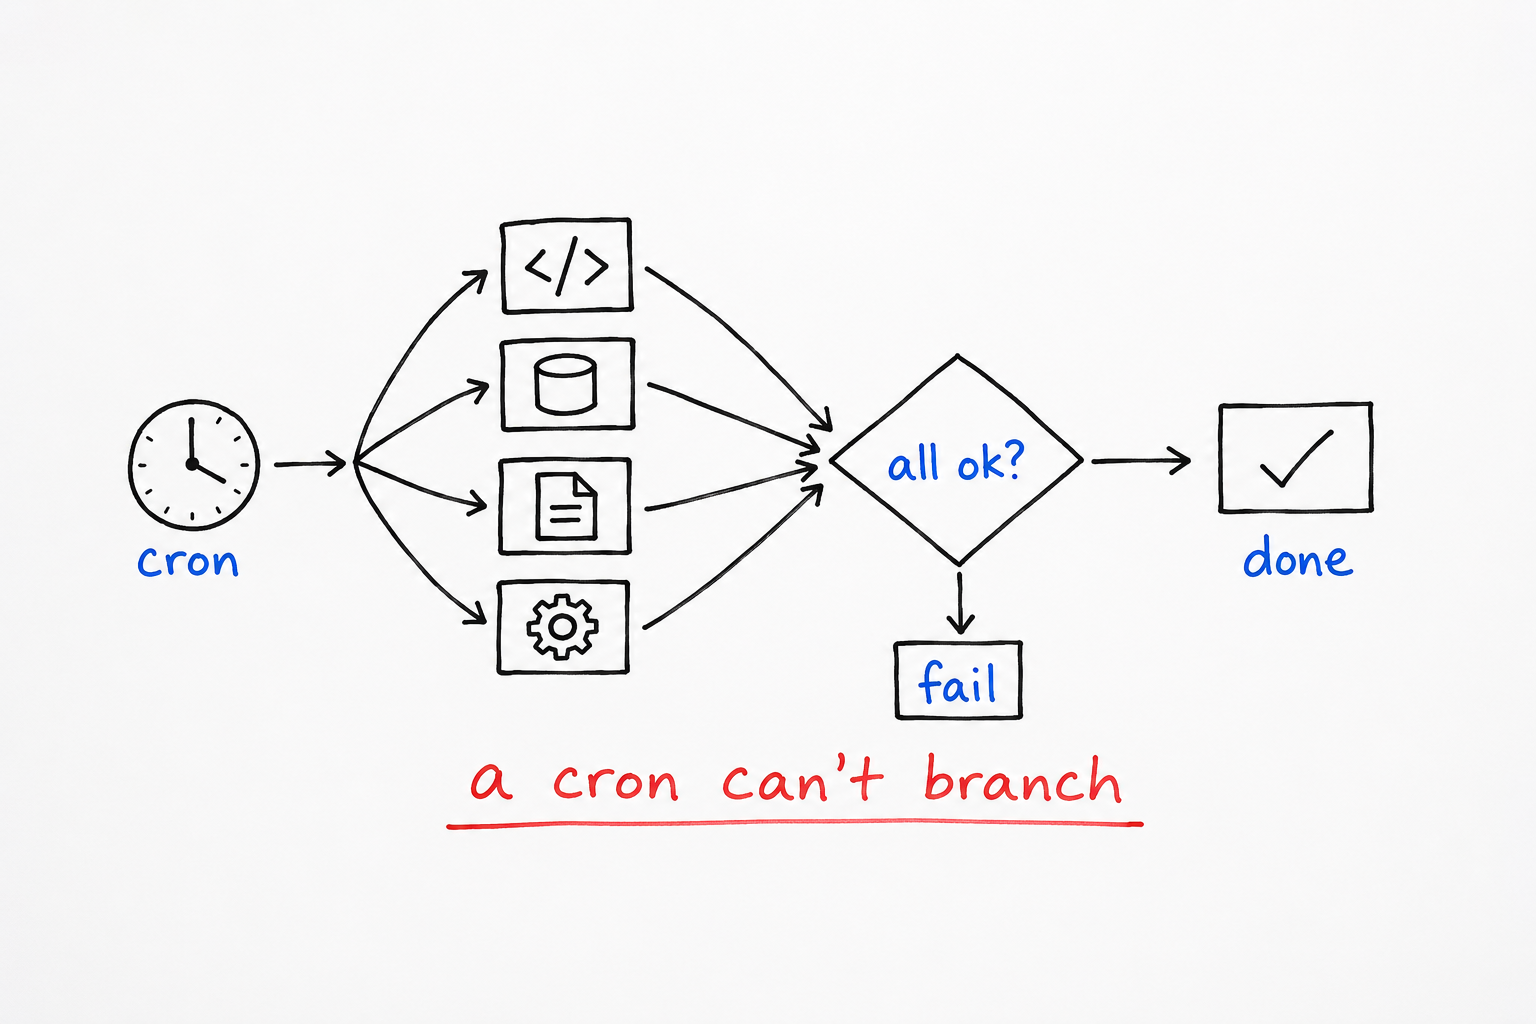
edge의 초기 데이터 파이프라인은 외부 데이터를 하루 한 번 받아 S3에 저장하는 배치로 시작했다. 원본은 raw, 정규화한 데이터는 canonical에 두기로 했고, 이를 채울 실행 구조가 필요했다.
뉴스·가격·공시·ETF 구성종목은 소스마다 API와 데이터 형식이 달랐다. 수집 작업을 실행하는 것에 더해, 실패한 소스를 확인하고 수집 결과를 다음 정제 단계로 넘길 방법도 정해야 했다.
데이터를 읽고 가공하는 코드는 Python 워커에 두고, 한 번의 실행 환경은 ECS Task로 구성했다. 여러 작업의 순서와 성공 조건은 Step Functions에서 관리하도록 역할을 나눴다.
edge는 실시간 수집이 아니라 일 배치부터 만들었다
edge는 외부에서 뉴스·가격·공시·ETF 구성종목을 수집해 분석이 쓸 수 있는 형태로 정규화해야 한다. 첫 목표는 실시간 수집이 아니었다. 하루에 한 번 실행되고, 정해진 데이터를 처리한 뒤 종료되는 배치를 먼저 완성하는 것이었다.
실행 주기와 복구 요구를 먼저 정했다
언어와 실행 환경을 고르기 전에 배치가 충족해야 할 조건을 정했다.
| 요구사항 | 왜 |
|---|---|
| 하루 한 번 실행 | 데이터가 실시간으로 들어오는 구조가 아니다. 장 마감 후 그날치를 받는다 |
| 실행 후 종료 | 항상 떠 있을 이유가 없다 |
| 소스별 처리 | 뉴스·가격·공시·ETF가 벤더마다 API도 스키마도 다르다 |
| 실패 지점 확인 | 어느 소스에서 깨졌는지 알아야 한다 |
| 기간 재실행 | 장애나 누락 시 과거 날짜를 다시 처리해야 한다 |
| 파싱 생산성 | HTML·JSON·XML을 계속 다뤄야 한다 |
파싱과 정규화에 필요한 도구를 고려해 Python을 골랐다
워커가 하는 일은 외부 API 호출, HTML·JSON·XML 파싱, 표 추출, 정규화, parquet 적재다. 웹 요청을 받아 오래 떠 있는 서버가 아니라 입력 범위를 다 처리하면 끝나는 프로세스다.
DART 공시가 대표적이다. euc-kr로 인코딩된 HTML 테이블에서 공급계약 본문을 파싱하고, 사업보고서의 사업부문 표를 뽑아내야 한다. 여기에 붙은 의존성이 이렇다.
1
2
3
4
5
beautifulsoup4   공시 본문 HTML 테이블 파싱
pandas + lxml    사업부문 표 추출 (read_html)
html5lib         lxml이 XML-ish 공시표를 못 읽을 때 폴백
pyarrow          canonical parquet 적재
boto3            레이크 S3 백엔드
이미 필요한 파싱 도구를 Python에서 사용할 수 있었고, 워커의 역할도 데이터 처리에 집중돼 있었다. 같은 기능을 Java로 다시 구현하기보다 기존 도구와 코드를 유지하는 편이 이 작업에 맞았다.
ECS Service가 아니라 ECS Task가 작업 모델과 맞았다
계속 요청이나 메시지를 기다려야 하는 Consumer·API라면 Service가 맞고, 시작해 처리한 뒤 종료되는 일회성 작업이면 standalone Task가 보통의 갈림이다.
이 작업은 하루에 한 번 시작해서 정해진 데이터를 처리하고 끝난다. 메시지를 기다리는 Consumer도 아니고 요청을 받는 API 서버도 아니다. 항상 떠 있는 ECS Service보다, 필요할 때 생기고 끝나면 사라지는 standalone Task가 작업 모델과 맞았다.
다만 이건 모든 데이터 처리를 Task로 하겠다는 뜻은 아니다. 나중에 이벤트를 계속 소비해야 한다면 그 Consumer는 Service로 두는 게 자연스럽다. 배치 주기로 감당이 안 되는 실시간 소스가 생기면 그때 상시 프로세스로 갈아탄다. 지금 미리 짓지는 않는다. 지금 Task가 맡는 건 일 배치와, 앞으로 생길 백필·재처리 경로다.
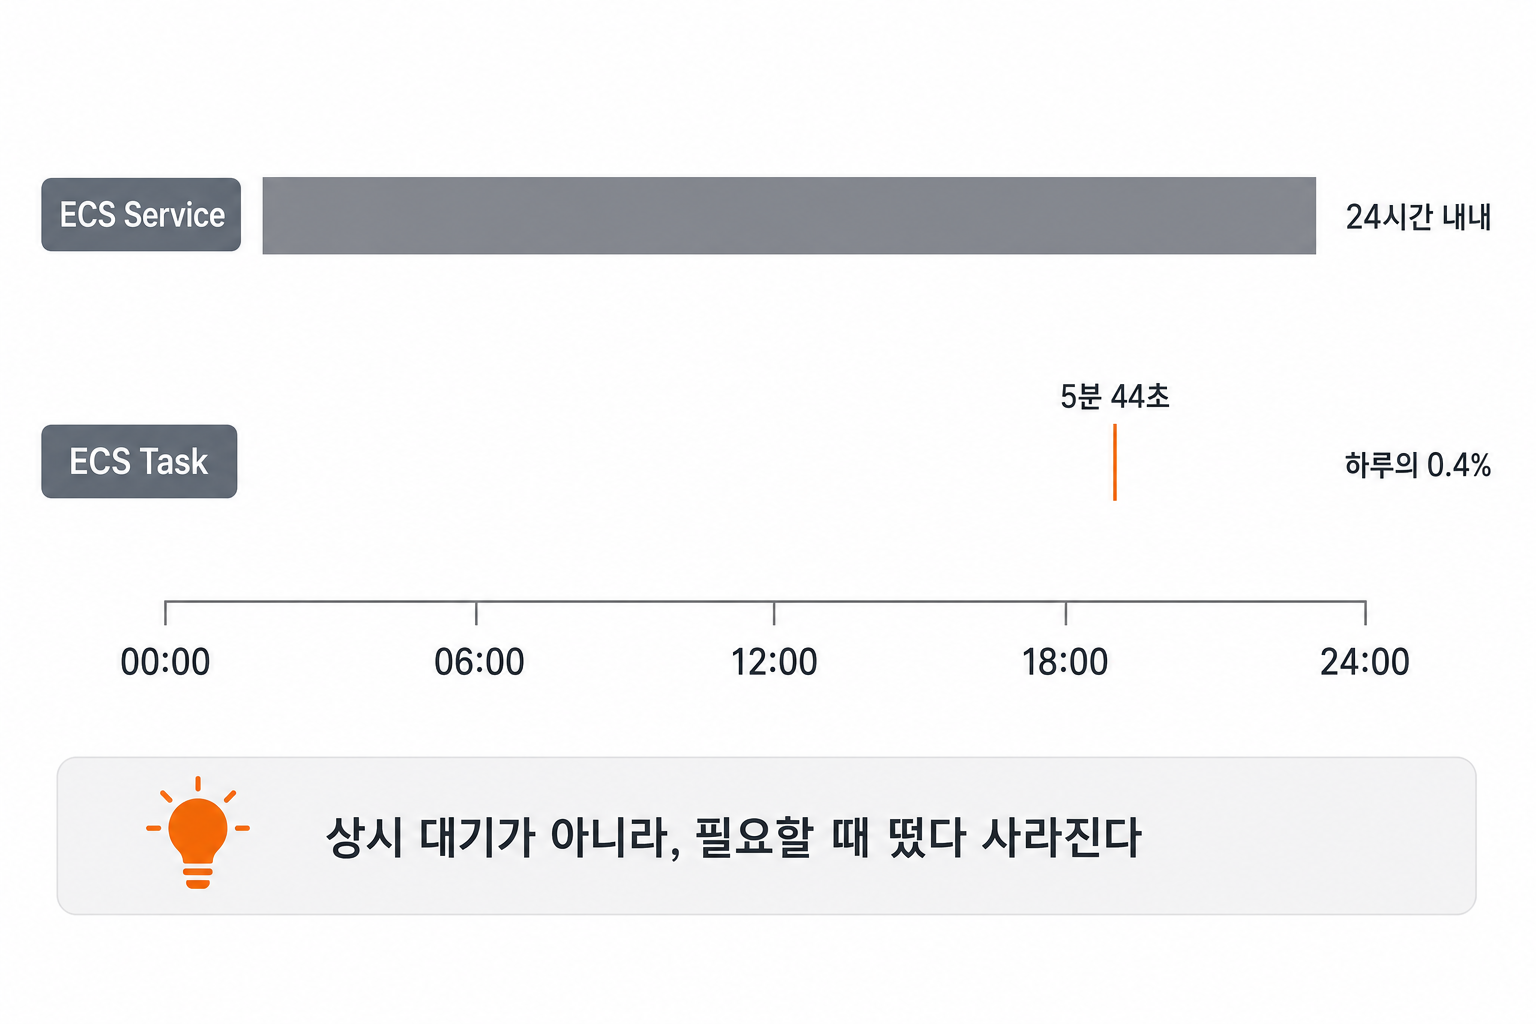 하루 24시간 중 실제로 도는 건 5분 44초, 나머지 23시간 54분은 켜둘 이유가 없다
작업 사이의 순서와 실패 판단은 Step Functions에 뒀다
실행할 Task가 하나이고 앞뒤 조건이 없다면 EventBridge Scheduler에서 ECS Task를 직접 부르는 구성을 검토할 수 있다. 여러 작업의 순서·분기·상태까지 관리해야 한다면 별도의 실행 흐름 관리가 필요하다. 처음에는 직접 실행하는 방식으로 충분하다고 생각했다.
그런데 수집 대상을 세어보니 4개였다.
1
2
3
4
BigKinds   뉴스
KIS        가격
KRX        ETF 구성종목(KR)
DART       공시
작업 개수보다 중요한 것은 수집을 병렬로 실행하고, 결과에 따라 정제 단계로 넘어갈지 판단해야 한다는 점이었다.
이걸 순차로 돌리면 느린 벤더 하나가 전체를 잡아먹는다. 그리고 하나가 실패했을 때 나머지를 진행할지 판단해야 한다. Scheduler의 실행 예약과 별개로 작업 사이의 조건을 관리할 곳이 필요했다.
그래서 실행 흐름을 Step Functions에 뒀다. 워커는 데이터를 처리하고, Step Functions는 무엇을 어떤 순서로 실행할지 관리한다.
Standard와 Express의 경계도 분명했다. Express는 실행 시간이 최대 5분이고 .sync 통합을 지원하지 않는다. ECS Task가 끝날 때까지 기다려야 하는 구조라 Express는 배제하고 Standard를 골랐다.
Step Functions는 이 배치에서 수집 작업의 병렬 실행과 정제 단계로 넘어가는 조건을 한곳에서 관리한다. 처리할 데이터 자체는 워커가 담당하므로, 흐름 관리와 데이터 처리 코드를 나눠 볼 수 있다.
소비자가 늘고 처리 주기가 달라지면 수집 완료 이벤트를 각 작업이 구독하는 구조를 검토할 수 있다. 초기 배치에서는 정해진 단계의 완료를 기다리는 중앙 실행 흐름으로 시작했다.
그래서 초기 파이프라인은 이렇게 되었다
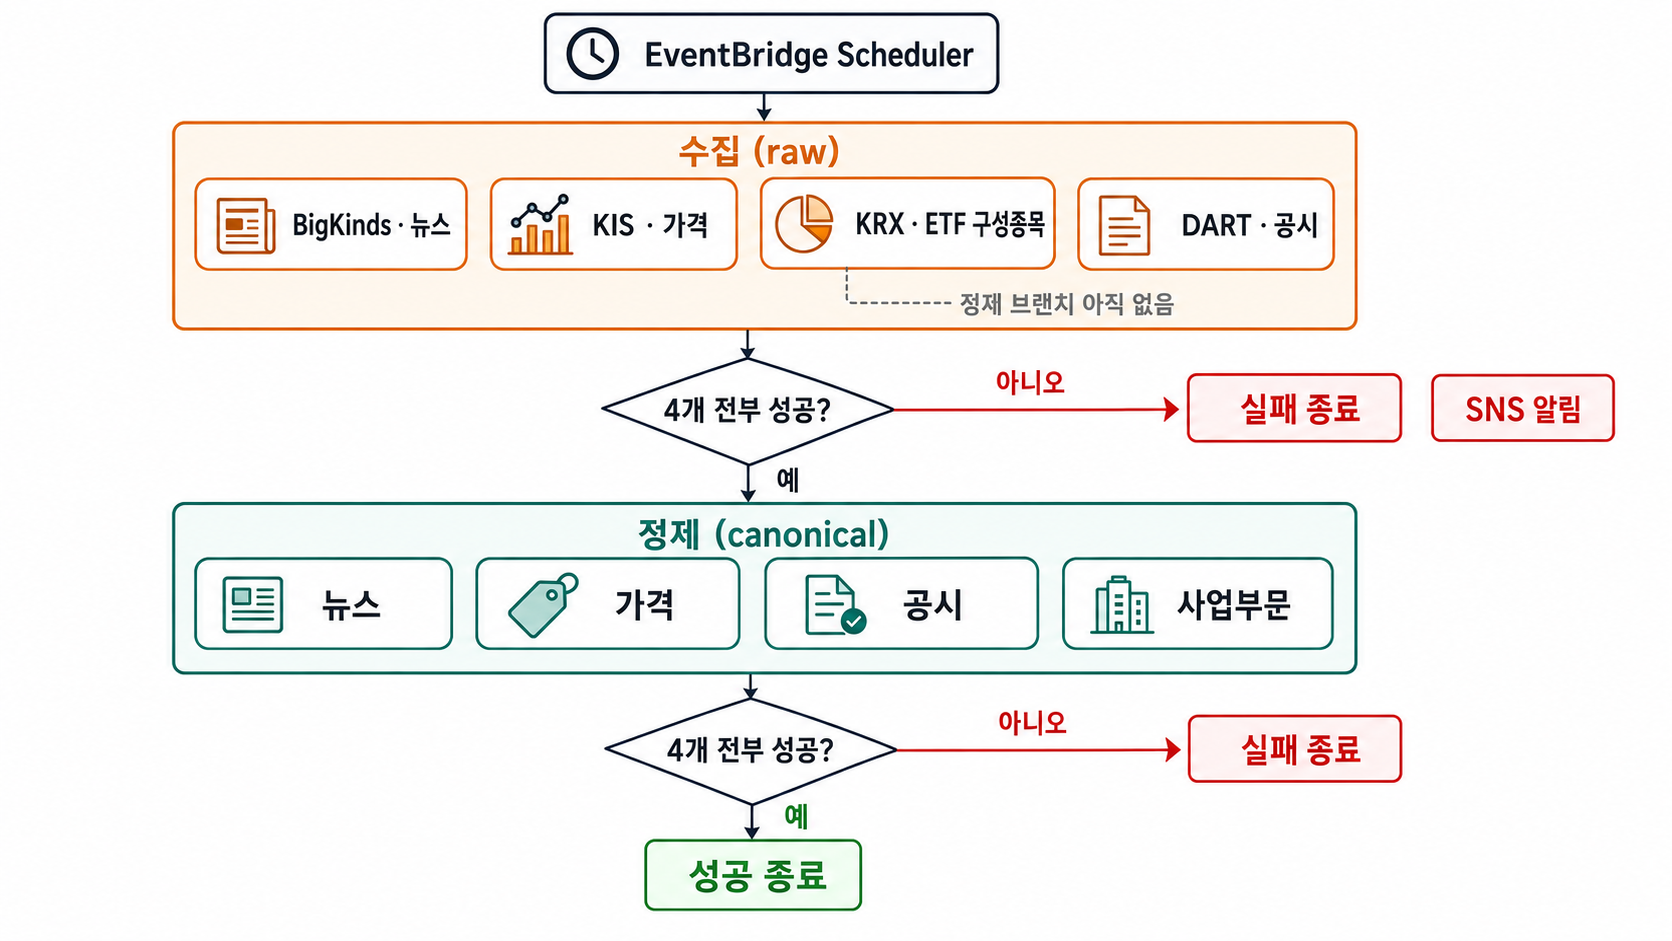 수집 4개가 동시에 돌고, 전부 성공해야 정제 4개로 넘어간다.
수집한 ETF 구성종목이 정제로 넘어가지 않는 게 보일 것이다. 정제 스텝은 이미 있는데 State Machine에 안 걸려 있다. KRX의 구성종목 스키마를 공통 구성종목 fact로 정규화하는 코드가 워커에 들어 있고 CLI로는 돌아가는데, 스케줄에는 없다. 그래서 지금 ETF는 raw까지만 쌓이고 canonical로 승격되지 않는다.
워커에 스텝을 추가하는 것과 그게 실제로 돌게 하는 건 별개였다. 실행 흐름을 Step Functions에 둔 대가이기도 하다 — 스텝은 파이썬으로 늘리는데 배선은 테라폼에서 해야 하니, 한쪽만 하고 넘어가기 쉽다. 다음에 붙일 예정이다.
각 브랜치는 ECS Fargate Task 하나를 띄우고, Task는 Python 워커를 CLI로 실행한다.
1
2
data-pipeline ingest-raw --source bigkinds --run-id 20260715T...
data-pipeline normalize-news --run-id 20260715T...
역할은 이렇게 나뉜다.
1
2
3
4
5
Scheduler         언제 실행할지
Step Functions    무엇을 어떤 순서로, 실패를 어떻게 판정할지
ECS Task          워커의 일회성 실행 환경
Python 워커        수집 · 파싱 · 정규화
S3 레이크          raw와 canonical
파이프라인은 S3 레이크까지만 한다. 분석 엔진이 읽는 건 RDB인데 그 경계는 이 글 밖이다.
Step Functions에 데이터를 넘기지는 않는다. run_id만 넘기고 워커가 레이크에서 직접 읽는다. 뉴스 본문을 상태 사이로 나르면 payload 제한에 걸리고, 무엇보다 전달할 필요도 없다.
정제 Task는 시크릿이 없는 task definition을 빌려 쓴다. 정제는 벤더 API를 안 부르고 레이크만 읽고 쓰기 때문에 API 키가 필요 없고, 모든 task definition이 같은 role을 공유한다. 새로 만들 이유가 없어서 안 만들었다.
아직 해결하지 않은 것
처리 단위가 run 전체다. 워커는 run(storage, run_id) 형태로 한 번에 한 실행분을 처리한다. 실행 방식과 처리 로직이 분리돼 있긴 하다 — CLI는 인자만 파싱하고, 스텝은 storage를 주입받아서 ECS도 Step Functions도 모른다. 백엔드가 local이면 로컬 디렉터리에 그대로 돌아간다.
하지만 문서 하나를 처리하는 함수는 없다. 나중에 이벤트를 메시지 단위로 소비해야 한다면 지금 코드로는 부를 게 없다. “향후 재사용 가능하게 분리했다”고 말하기엔 절반만 맞다.
같은 날짜를 두 번 돌리면 어떻게 되는가. raw는 run_id별로 계속 쌓이도록 일부러 그렇게 만들었다. 중복 제거는 정제가 맡는다. 그런데 정제가 정말 멱등한지, 두 번 돌린 결과가 한 번 돌린 것과 같은지는 아직 제대로 확인하지 않았다.
ETF 구성종목 정제를 State Machine에 연결해야 한다. 정제 코드가 있어도 실행 흐름에 연결되지 않으면 raw 이후로 진행되지 않는다.
마무리
Python 워커는 파싱과 정규화를, ECS Task는 한 번의 실행을, Step Functions는 작업 사이의 순서와 실패 판단을 맡는다. 일 배치의 요구를 이 세 역할로 나눠 초기 흐름을 구성했다.
실행 환경을 정한 것과 재처리의 정합성을 확인한 것은 별개다. 남아 있는 과제는 반복 실행의 결과와 정제 단계의 연결을 확인하는 일이다.