EDGE 데이터 파이프라인 아키텍처
이 파이프라인은 장이 열려 있는 동안 1분마다 데이터를 처리한다. 장전에 그날의 세션을 계획하는 task가 있고, 장중 내내 살아 있는 worker가 있고, 무엇을 계획했고 무엇이 실제로 끝났는지를 적는 원장이 있다.
이 구조를 처음부터 그려놓고 시작한 게 아니다. 시작은 한 종목을 하루 한 번 분석하는 일 배치였고, 단계 네 개짜리 워크플로 하나면 충분했다.
구조는 네 단계에 걸쳐 바뀌었다. 처리 대상과 실행 주기가 달라질 때마다 작업의 경계와 상태를 관리하는 방식도 달라졌다.
처리 대상과 실행 주기에 맞춰 구조를 바꿨다
| 버전 | 팀이 요구한 것 | 기존 구조가 못 버틴 지점 | 재설계 기준 |
|---|---|---|---|
| v1 | 한 종목을 하루 한 번 | 없음 — 순서만 맞으면 됐다 | 단일 워크플로에 4단계 |
| v2 | 여러 ETF, 이어서 장중 1분 단위 설명 | 벤더 순차 호출, 수집 성공과 분석 완료가 한 실행 단위 | 최장 branch 병렬화 + 큐 경계 |
| v3 | 60초 window 안에서 처리 | 배치 원장에 분 단위 상태를 못 적음 | 상주 worker + 1분 원장 |
| v4 | 실시간·배치·운영의 공존 | 두 레인이 같은 소스를 동시에 소유 | 작업마다 단일 소유자 |
v1은 하루 한 번의 처리를 한 워크플로로 연결했다
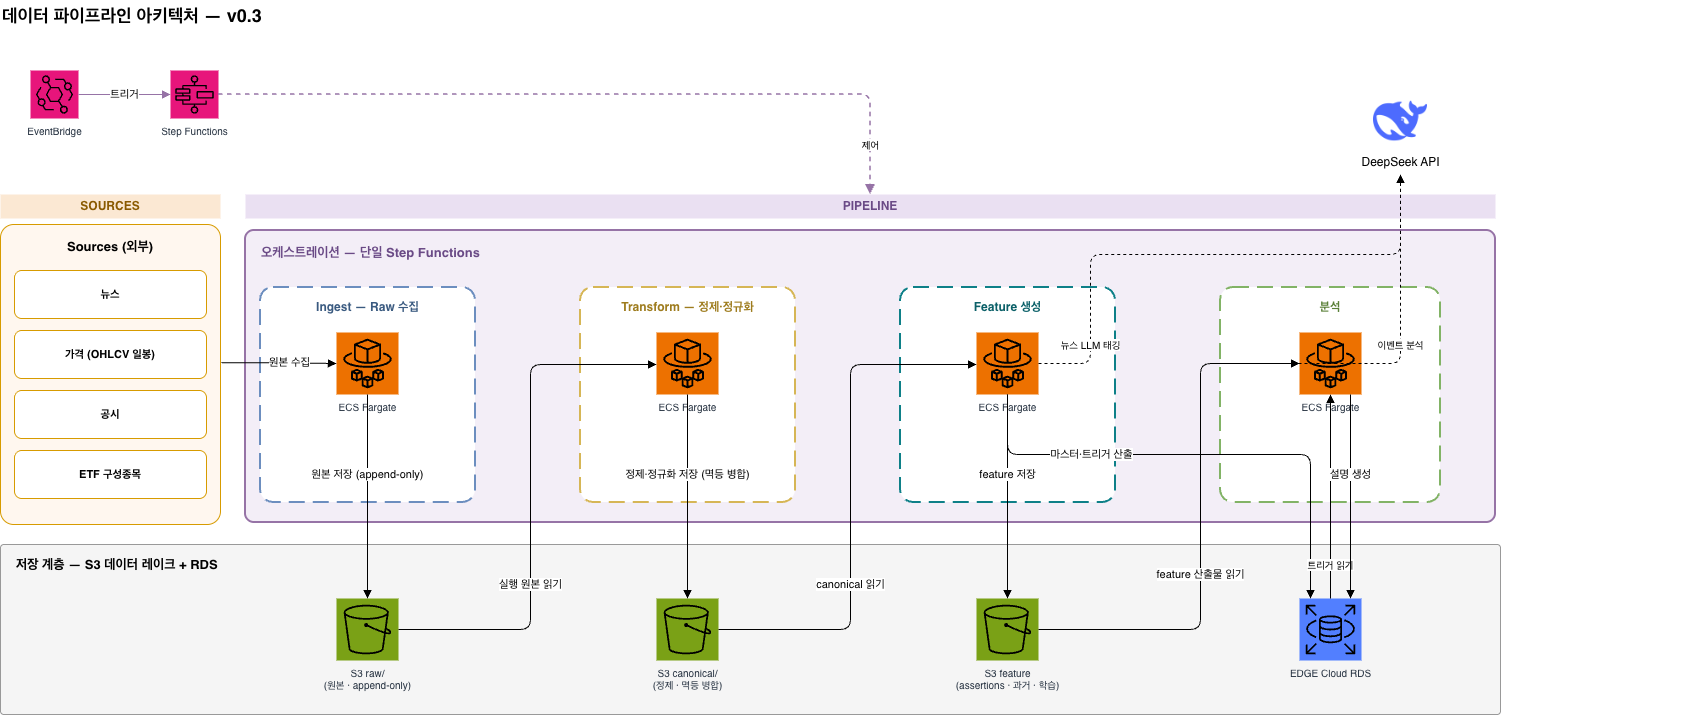 하루 한 번 한 종목이면 단계 넷을 한 줄로 거는 워크플로 하나가 부족할 데가 없다
v1은 순서를 지키는 데 중점을 뒀다. EventBridge가 단일 Step Functions를 깨우면 Ingest → Transform → Feature → 분석이 차례로 돌았고, 각 단계는 ECS Fargate task 하나였다.
저장소는 raw/에 벤더 응답을 그대로 덧붙이고 canonical/은 같은 키가 다시 들어오면 멱등하게 병합하도록 갈랐다. 이 경계는 S3와 RDB의 역할을 가르는 기준에서 출발해 raw·canonical·feature 계층으로 굳었다.
v2는 벤더별 수집과 후속 분석의 실행을 분리했다
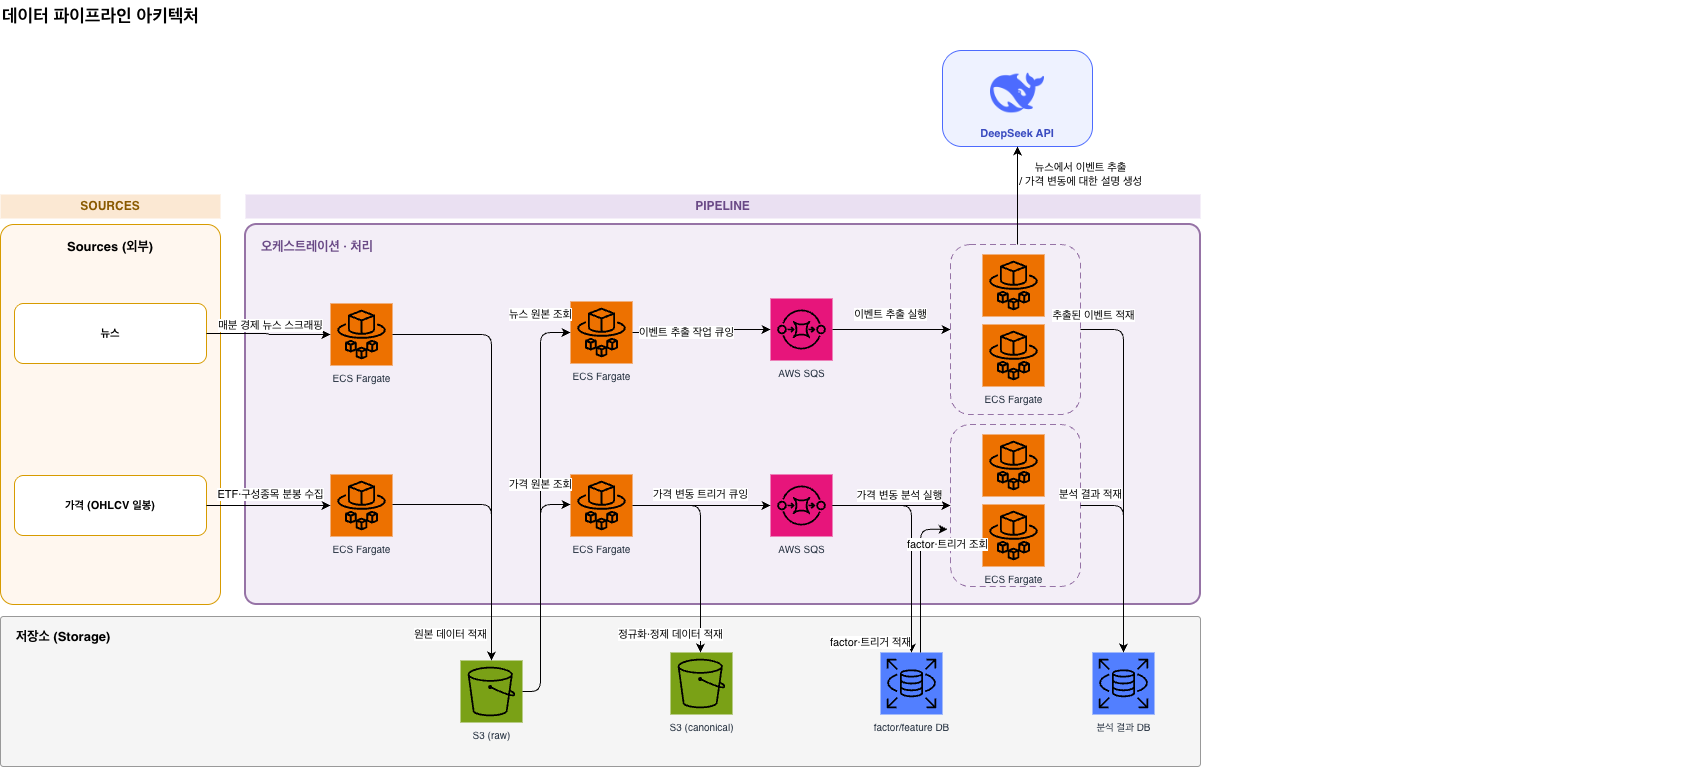 SQS 두 개가 들어간 자리가 수집 성공과 분석 완료를 서로 다른 실행 단위로 갈라놓은 경계다
v2는 결합을 끊는 데 중점을 뒀다. 대상이 늘자 한 단계가 벤더를 순서대로 부르는 구조가 먼저 무너졌는데, 병렬 실행의 전체 시간은 갈래(branch)의 합이 아니라 최댓값에 좌우됐다. KRX 쪽만 병렬화하면 약 580초, KIS 쪽만 병렬화하면 약 579초로 사실상 제자리였다.
수집 성공과 분석 완료가 같은 실행 단위에 묶여 있으면 분석 한 건이 느려질 때 다음 분 수집이 통째로 밀린다. 그래서 벤더별로 task를 쪼개고, 그 사이에 SQS 두 개를 넣어 뉴스는 LLM 추출 consumer에게, 가격 변동 트리거는 분석 실행 consumer에게 넘겼다.
갈라놓고 나니 커밋하는 일과 발행하는 일이 같은 트랜잭션 안에 있지 않다는 문제가 남았고, 이 틈을 outbox로 닫는 과정이 다음 결정이었다.
v3은 장전에 계획하고 상주 워커가 1분 작업을 처리했다
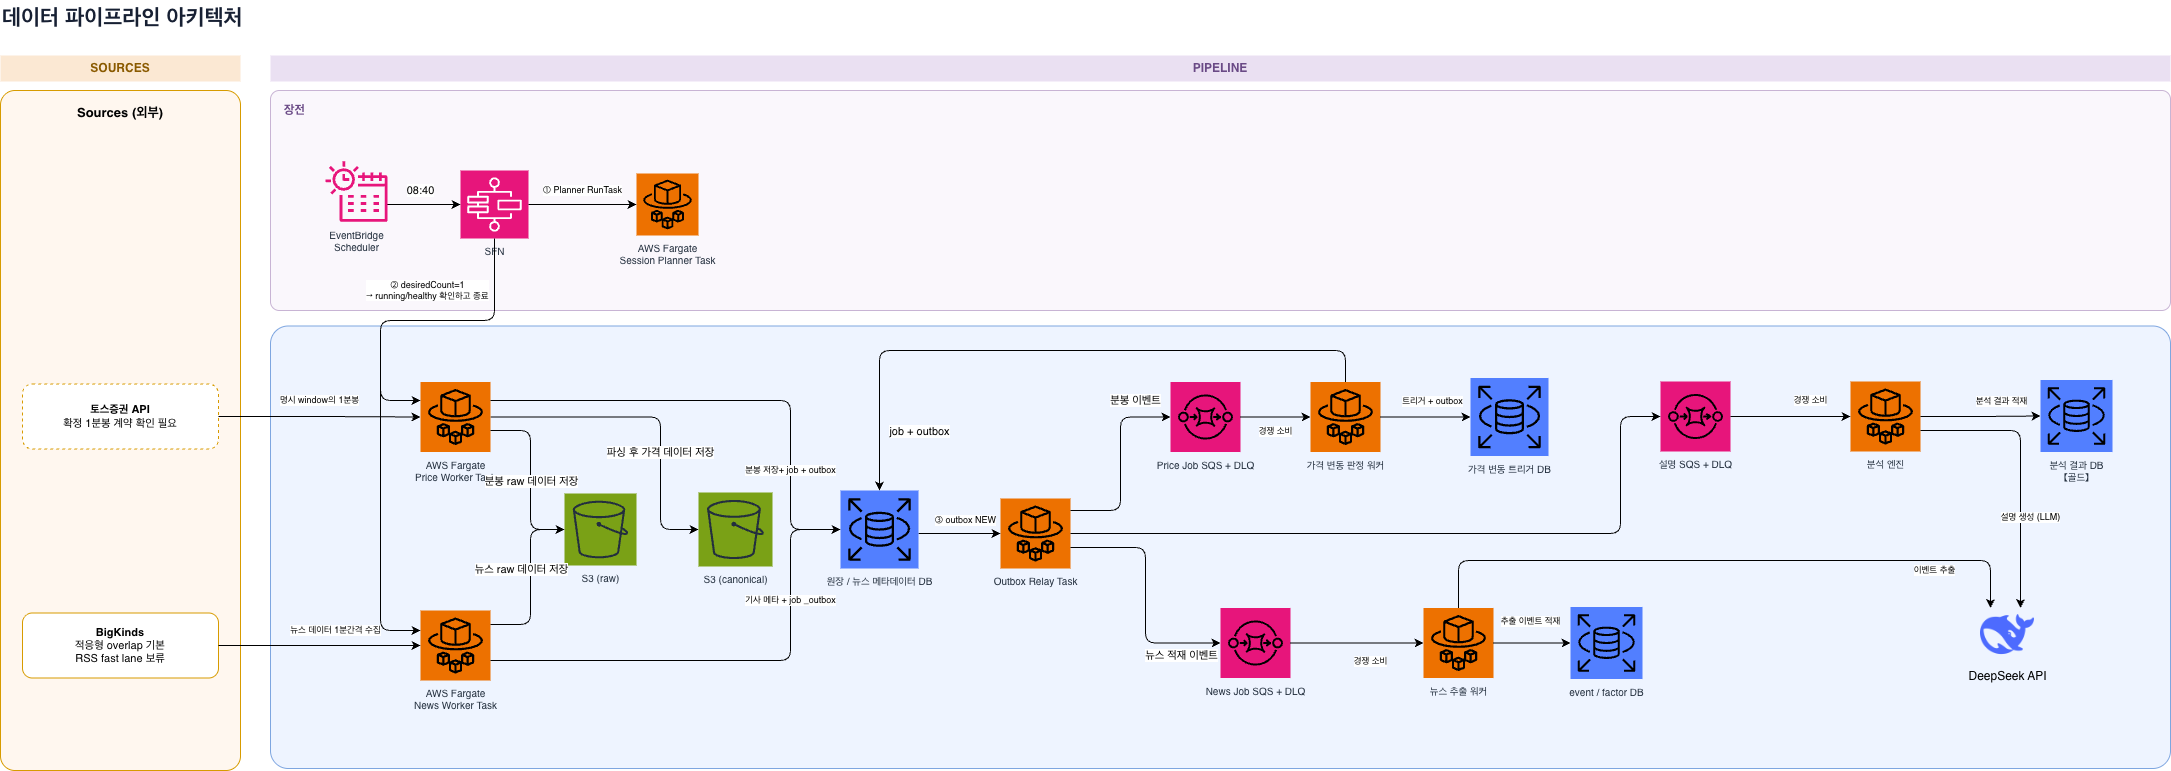 매 분 새로 띄우는 대신 장전에 한 번 계획하고 상주 worker가 window를 받아간다 — 도면의 가격 소스 토스증권 표기는 2026-08-01 실측 당시의 사실이다
v3은 60초를 지키는 데 중점을 뒀다. 매 주기 컨테이너를 새로 띄우면 기동과 초기화에 쓰는 시간이 60초 window 안에서 그대로 차감된다.
그래서 계획과 실행을 시간축에서 갈랐다. 장전 08:40에 세션 플래너가 그날의 window를 한 번 계획하고, 장중에는 상주 Price·News Worker가 명시된 window를 받아서 처리한다.
worker가 상주하자 각 분의 작업을 누가 맡았고, 몇 번 재시도했으며, 발행까지 끝났는지 기록해야 했다. 일 배치 원장에는 그 상태를 적을 곳이 없어 session·window·job·outbox를 포함한 6테이블로 1분 원장을 새로 만들었다.
60초 안에 끝낼 수 있는지는 벤더의 호출 처리량에 달려 있었다. 1분 경로의 첫 벤더는 토스증권이었는데 로컬에서 348건을 replay하니 70.631초로 window를 10.631초 넘겼고, 초당 14.8건이 나오는 KIS로 기본 분봉 소스를 바꿨다. 토스가 느렸던 게 아니라 60초 window라는 내 요구가 그 시점의 유량 상한 위에 있었다.
v4는 실행 경로마다 작업의 소유자를 정했다
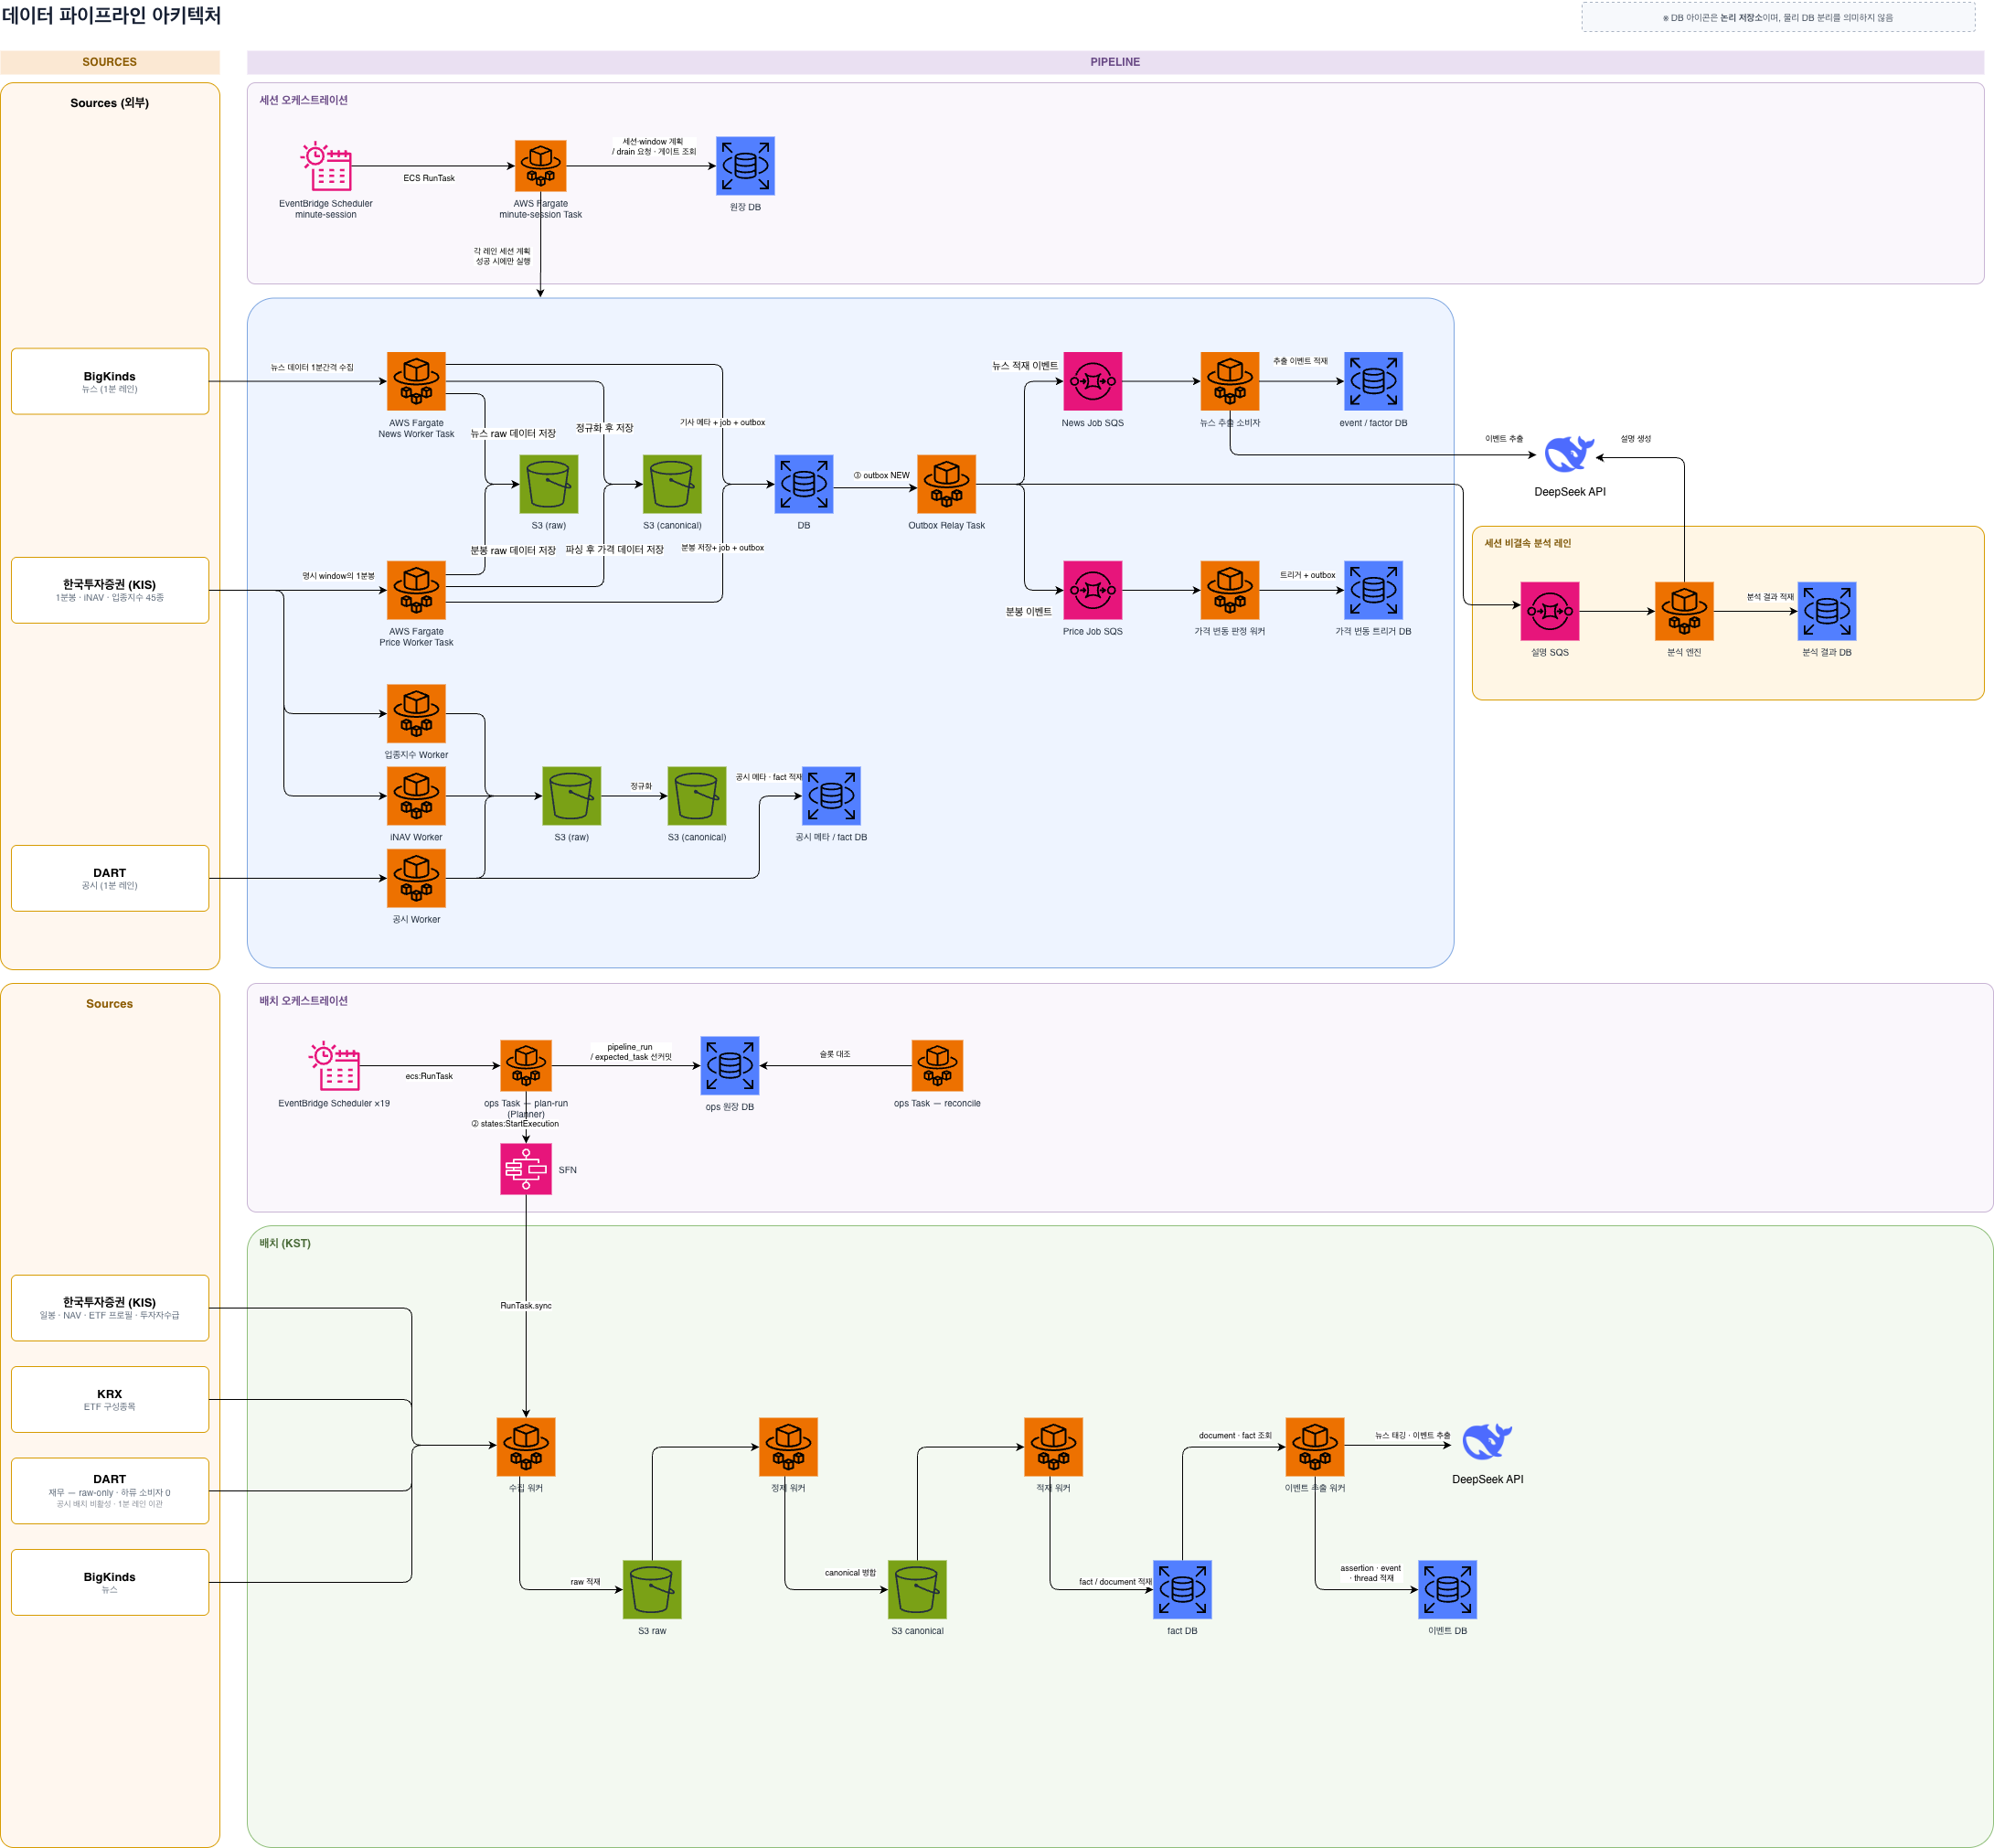 네 레인이 같은 소스와 같은 S3, 같은 원장을 나눠 쥐고 있어서 남은 문제가 속도가 아니라 소유권이 된다
v4는 소유권을 정하는 데 중점을 뒀다. 레인을 늘리는 일 자체는 쉬웠고, 어려운 건 공시 수집처럼 같은 소스와 같은 CLI를 두 레인이 동시에 쥐는 상황이었다. 그러면 원장은 한쪽이 끝낸 일을 못 보고 영구 MISSED로 남기거나 양쪽이 각자 호출해 DART 한도를 중복으로 태우기 때문에, 작업마다 단일 소유자를 원장에 못박았다.
오케스트레이터가 성공으로 끝났다는 건 상태 머신이 끝까지 갔다는 뜻이지 데이터가 다 들어왔다는 뜻이 아니라, 계획을 먼저 적어두고 끝난 뒤에 실적과 대조하는 원장을 따로 뒀다. 2026년 8월 14일 거래일에 가격 분석 큐로 나간 job은 390건으로, 09:01부터 15:30까지의 장중 1분 window 수와 정확히 일치한다.
이 도면은 구현한 경로와 확장 목표를 함께 정리한 것이다. 네 영역이 전부 같은 완성도로 돌고 있다는 뜻은 아니다.
마무리
가장 오래 남은 건 두 번의 오답이다. 병렬 실행의 전체 시간이 합이 아니라 최댓값이라는 것, 그리고 60초 안에 처리 가능한 범위가 벤더 호출 처리량에 달려 있다는 것. 두 번 다 “줄이면 되겠지”라는 직관이 산술과 실측 앞에서 틀렸다.
그래서 구조를 바꿀 때 내가 먼저 확인하는 건 무슨 기술을 더 쓸 수 있느냐가 아니라 요구가 어떤 시간 단위로 바뀌었느냐다. 네 번 다 그 순서였다.