장중 파이프라인의 Transactional Outbox와 멱등 처리
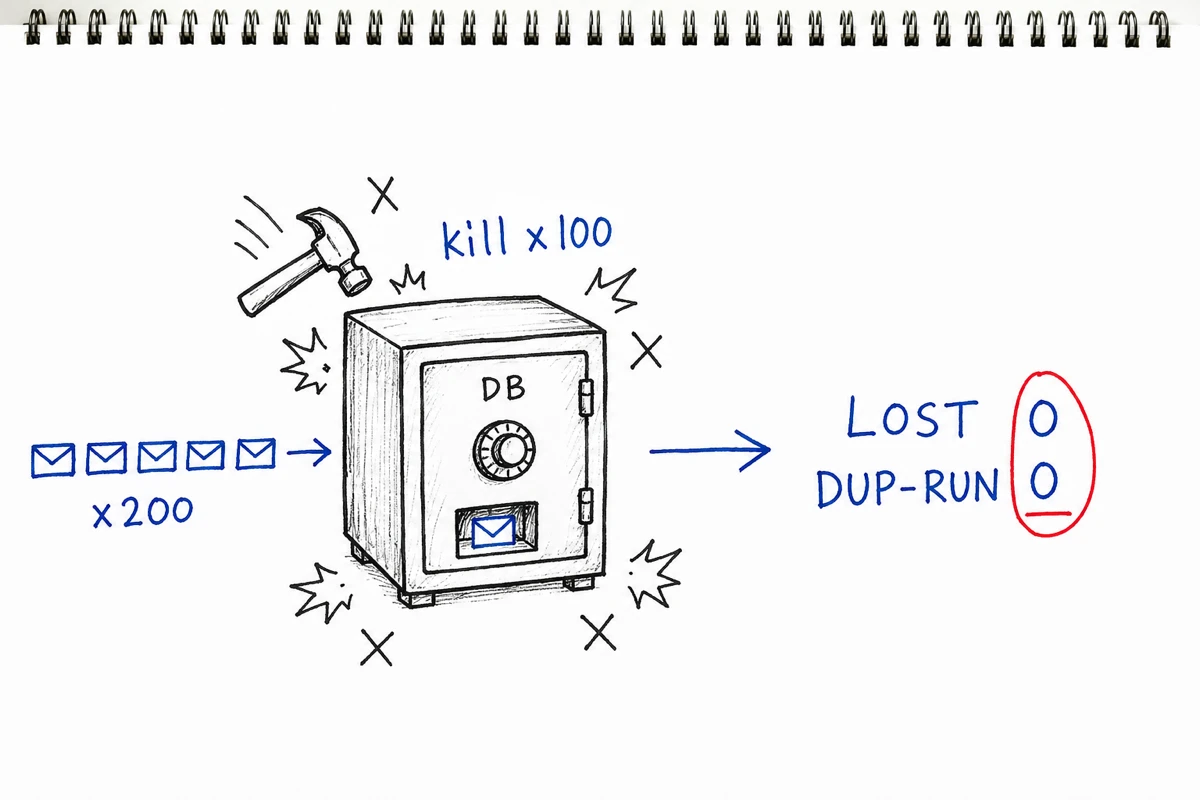
장중 파이프라인의 수집은 60초 window 안에 끝나야 했다. 느리고 실패할 수 있는 후속 처리까지 그 한 줄에 묶어둘 수는 없었다.
뉴스 LLM 추출, 가격 트리거, 설명 분석은 전부 뒤로 밀어야 했다. 수집이 기차 첫 칸이라면 후속 처리는 뒤 객차였고, 한 칸이 탈선했다고 앞칸까지 멈추게 두고 싶지 않았다.
그래서 후속 처리를 큐로 떼어냈다. 그런데 그 순간부터 DB에 “이 작업을 해야 한다”를 남기는 일과 SQS로 “이 작업을 깨워라”를 보내는 일이 별도로 성공하거나 실패하게 됐다.
처음에는 순서만 잘 잡으면 되는 줄 알았다. 확인해보니 문제는 순서가 아니라, 두 저장소 사이에 반쪽 상태가 생긴다는 사실 자체였다.
큐로 분리하자마자 DB와 SQS 사이에 유실 구간이 생겼다
가격 트리거를 비동기로 만든 이유부터가 계산량이 아니라 실패·재시도 경계를 끊는 것이었다. 그런데 경계를 큐로 끊는 대가로, DB 기록과 SQS 발행은 더 이상 한 transaction 안에 묶이지 않았다.
큐를 왜 넣었나 — 후속 처리 실패가 수집을 막지 않게 실패 경계를 끊는다
뉴스 LLM 추출, 가격 트리거, 설명 분석은 전부 느리고 실패할 수 있는 후속 처리였다. 이걸 수집에 동기로 붙이면 후속 하나가 늦거나 죽는 순간 다음 60초 수집까지 같이 밀렸다.
그래서 후속 처리를 큐 뒤로 밀었다. 뒤에서 몇 번을 실패하든 앞단 수집은 제 시간에 창을 닫게 만들고 싶었다.
dual-write — DB commit과 SQS 발행은 하나의 트랜잭션으로 묶이지 않는다
큐를 넣는 순간 워커의 일은 둘로 갈라졌다. DB에 작업 행을 commit하고, SQS로 그 작업을 깨울 메시지를 보내야 했다.
문제는 이 둘이 서로 다른 시스템이라는 점이었다. PostgreSQL commit과 SQS send는 각자 따로 성공하고 따로 실패했다.
한쪽이 됐다고 다른 쪽이 따라온다는 보장이 없었다. 하나의 논리적 작업이 원자적으로 묶이지 않는 두 개의 write로 갈라지는 것, 이게 dual-write다. 그 두 write 사이가 그대로 유실 구간이 됐다.
이 유실 구간을 닫고 나서의 최종 구조는 이렇게 정리됐다. Price Worker는 수정하지 않는 S3 산출물(immutable artifact)을 썼다. 이어서 처리권을 확인하는 PostgreSQL 트랜잭션에 window 확정·job·발행 의도인 outbox event를 함께 남겼다.
그다음부터는 워커 손을 떠났다. 별도 Relay가 NEW event를 SQS로 보내고, 각 큐의 consumer가 멱등으로 받아 실행하게 했다.
DB에는 작업이 남았는데 이를 깨울 메시지가 사라졌다
DB commit 후 SQS 발행 전 종료 — 작업은 존재하지만 깨울 메시지가 영구 유실된다
가장 자연스러운 순서는 DB 먼저였다. 작업을 DB에 commit하고, 그다음 SQS로 메시지를 보내는 흐름이 제일 얌전해 보였다.
그런데 commit은 끝났는데 send 직전에 프로세스가 죽으면 얘기가 달라졌다. DB에는 작업이 남는데, 그 작업을 깨울 메시지는 끝내 나가지 못했다.
consumer는 큐만 본다. DB를 주기적으로 훑어 잠든 작업을 찾는 우회 경로는 없었다.
그래서 큐에 메시지가 없으면 그 작업이 존재하는지조차 모른 채 지나간다. 작업은 DB 안에 남아 있는데도 아무도 집어가지 않는 상태로 조용히 잠들었다.
유실 1건은 단순히 숫자 1이 아니었다. 한 번 잠든 작업이 누가 눈치채기 전까지 영영 안 깨어난다는 뜻에 더 가까웠다.
순서를 뒤집어도 — SQS 먼저 보내면 rollback·commit 지연 시 consumer가 없는 작업을 먼저 읽는다
그래서 한 번은 순서를 뒤집어보고 싶었다. DB가 문제라면 SQS를 먼저 보내면 되지 않나 싶었다.
하지만 이번에는 반대편이 깨졌다. SQS를 먼저 보내고 DB commit이 rollback되거나 지연되면, consumer가 존재하지 않거나 아직 안 보이는 작업을 먼저 읽게 됐다.
핵심은 “안 보이는 작업”이었다. 메시지가 도착한 시점에 job 행의 commit이 아직 끝나지 않았으면 consumer가 DB를 조회해도 그 행은 보이지 않았다.
rollback이면 아예 없고, 지연이면 나중엔 생기지만 지금은 없다. consumer 입장에서는 둘을 구분할 방법이 없었다.
| 단순 처리 순서 | 실패 시나리오 | 결과 |
|---|---|---|
| DB commit → SQS send | commit 직후 프로세스 종료·SQS 장애 | 작업은 존재하지만 consumer를 깨울 메시지가 영구 유실 |
| SQS send → DB commit | 발행 후 DB rollback·commit 지연 | consumer가 존재하지 않거나 아직 안 보이는 작업을 먼저 읽음 |
두 순서는 거울처럼 대칭으로 깨졌다. 순서만 바꾸면 불일치가 사라지는 게 아니라, 왼쪽에서 오른쪽으로 옮겨 앉을 뿐이었다.
그때 받아들였다. 이건 처리 순서의 문제가 아니라, 애초에 두 write가 하나로 묶이지 않는다는 구조 문제였다.
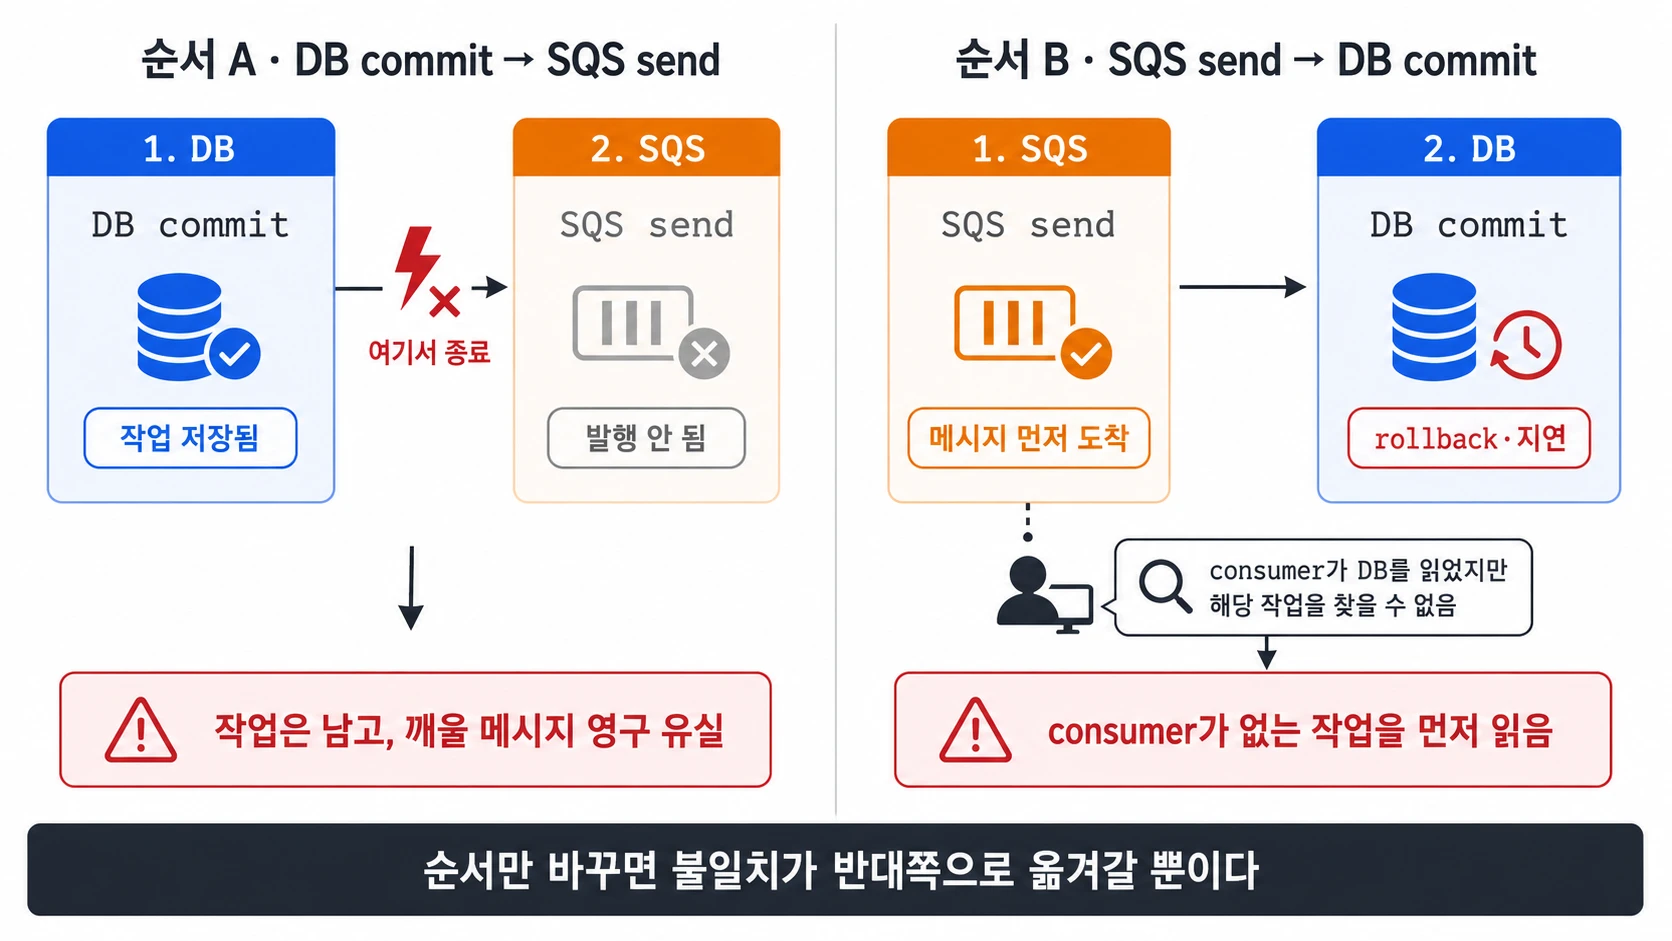 DB를 먼저 해도 SQS를 먼저 해도, 불일치는 반대쪽으로 옮겨갈 뿐 사라지지 않는다.
작업과 발행 의도를 한 트랜잭션에 함께 저장하고, 발행은 Relay에만 맡겼다
방향을 틀었다. 두 write를 원자적으로 만들 수 없다면, 프로세스가 죽는 지점에 걸치는 write 자체를 하나로 줄이면 됐다.
함께 저장 — job과 발행 의도를 하나의 트랜잭션에 넣는다
job과 그 작업을 깨울 발행 의도, 즉 outbox event를 같은 PostgreSQL transaction에 함께 INSERT했다. jobs.py의 enqueue_news_job이 그 일을 한다.
둘은 같이 commit되거나 같이 rollback됐다. 중간에서 죽어도 반쪽만 남는 경우가 없었다.
이렇게 묶어두면 남는 경우의 수는 둘뿐이었다. 둘 다 안 들어가거나, 둘 다 들어가거나였다.
안 들어갔으면 다시 호출해 넣으면 됐다. 이미 들어간 상태에서 또 호출돼도 안전해야 했기 때문에, job insert는 ON CONFLICT (job_id) DO NOTHING, outbox insert는 ON CONFLICT (event_id) DO NOTHING으로 잡았다.
그래서 재호출 전체가 조용히 no-op이 됐다. 같은 서랍을 한 번 더 닫는다고 안의 물건이 두 개로 늘지 않는 식이었다.
이게 성립하려면 event ID가 결정적이어야 했다. 같은 작업이면 언제 다시 계산해도 같은 ID가 나와야 중복 재삽입이 쌓이지 않았다.
1
2
build_event_id() = {event_type}:{job_id}:{redrive_generation}
job_id           = sha256(고정 필드 순서의 canonical JSON)
event ID가 내용에서 결정적으로 나오기 때문에 같은 작업을 두 번 enqueue해도 outbox에는 한 줄만 남았다. 일반 재전달은 같은 ID를 쓰고, 수동 redrive만 세대(redrive_generation)를 올려 새 ID를 만들었다.
가격 쪽도 같은 모양으로 맞췄다. enqueue_price_job은 canonical·window 갱신과 같은 트랜잭션 조각을 재사용해, window 확정과 job과 outbox event를 한 commit에 묶었다.
뉴스든 가격이든 규약은 같았다. 논리적 작업 하나를 한 트랜잭션 안의 job + outbox로 고정했다.
Relay — DB에 남은 발행 의도를 읽어 SQS로 보낸다
그럼 SQS 발행은 누가 하느냐가 남았다. 답은 워커가 아니었다.
워커는 DB에 job과 outbox event를 남기고 끝났다. commit 밖에서 SQS로 발행하는 유일한 경로는 별도 Relay 프로세스였다(relay.py).
Relay는 NEW 상태 outbox event를 집어 SQS로 보내고 PUBLISHED로 바꿨다. 그래서 ‘DB commit 후 Relay 발행 전 종료’가 더는 유실이 아니었다.
event가 NEW로 DB에 남아 있으니 다음 Relay tick이 다시 집어 발행했다. 작업 상태와 재시도 판단의 기준은 PostgreSQL에 두고, SQS는 작업이 있음을 알리는 통로로 사용했다.
이렇게 쪼개고 나니 Relay가 판단할 일은 셋만 남았다. 어느 큐로 보낼지, 실패가 일시적인지 영구적인지, 그리고 언제 다시 시도할지였다.
그 밖의 업무 로직은 Relay에 두지 않았다. 무엇을 실행할지는 consumer와 DB가 맡고, Relay는 NEW event를 올바른 큐로 밀어 넣는 얇은 층으로 남겼다.
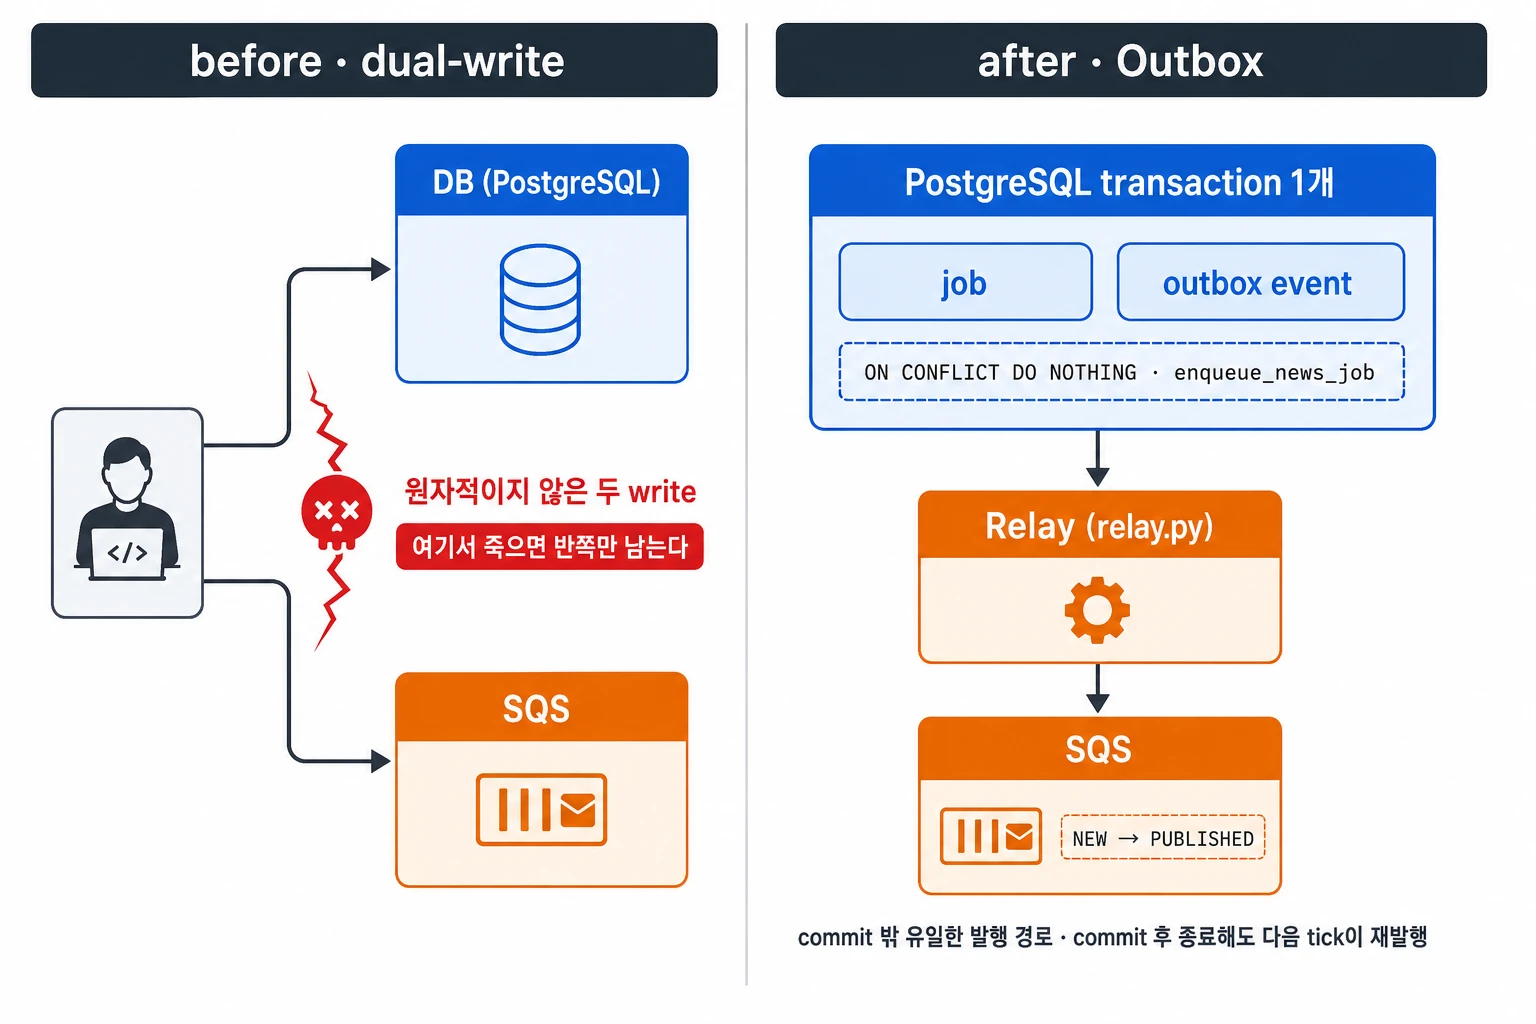 두 개의 독립 write를 한 트랜잭션 안 job+outbox로 묶고, 발행은 commit 밖 Relay 하나에만 맡긴다.
중복 수신 — DB 상태를 확인해 실행 자격을 얻는다
발행을 Relay로 빼내자 이번에는 다른 틈이 보였다. Relay가 SQS로 보내고 PUBLISHED로 바꾸기 전에 죽으면, 같은 event가 NEW로 남아 다음 tick에 또 발행될 수 있었다.
같은 메시지가 두 번 갈 수 있으므로 consumer가 중복을 처리하도록 설계했다.
at-least-once는 적어도 한 번 전달하되 중복을 허용하는 방식이다. consumer는 같은 메시지가 다시 와도 업무 결과를 중복 반영하지 않도록 멱등하게 만들었다. 이미 완료된 작업의 메시지를 다시 받으면 업무를 다시 실행하지 않게 했다.
실행 자격은 메시지가 아니라 DB가 판정했다. consumer는 event ID로 DB의 job 상태를 확인하고, 이미 끝난 작업이면 handler를 부르지 않고 바로 ack했다.
재시도 권위도 PostgreSQL에만 뒀다. SQS의 receive count는 논리적 시도 횟수가 아니라, 그저 바깥에서 관측된 횟수일 뿐이었다.
메시지 하나가 들어오면 consumer는 먼저 event ID로 DB의 job 상태와 next_attempt_at을 봤다. 이미 끝난 작업이면 실행 없이 지우고, 아직 이른 재시도면 visibility만 뒤로 미뤘다.
작업이 PENDING이거나 재시도 시각이 지났으면 실행 자격을 요청한다. DB 상태가 예상한 값과 일치할 때만 갱신하는 CAS로 CLAIMED를 잡고 attempt_count를 올렸다. 이 CAS를 통과한 수신만 handler를 실행했다.
같은 순간에 도착한 중복 수신은 CAS에서 튕겼다. 문 손잡이를 여러 명이 동시에 잡아도 자물쇠를 연 한 사람만 방에 들어가는 셈이었다.
handler가 끝나면 결과에 따라 상태를 하나로 확정했다. 일시 실패일 때만 next_attempt_at을 새로 적고, 그 시각에 맞춰 메시지 visibility도 같이 조정했다.
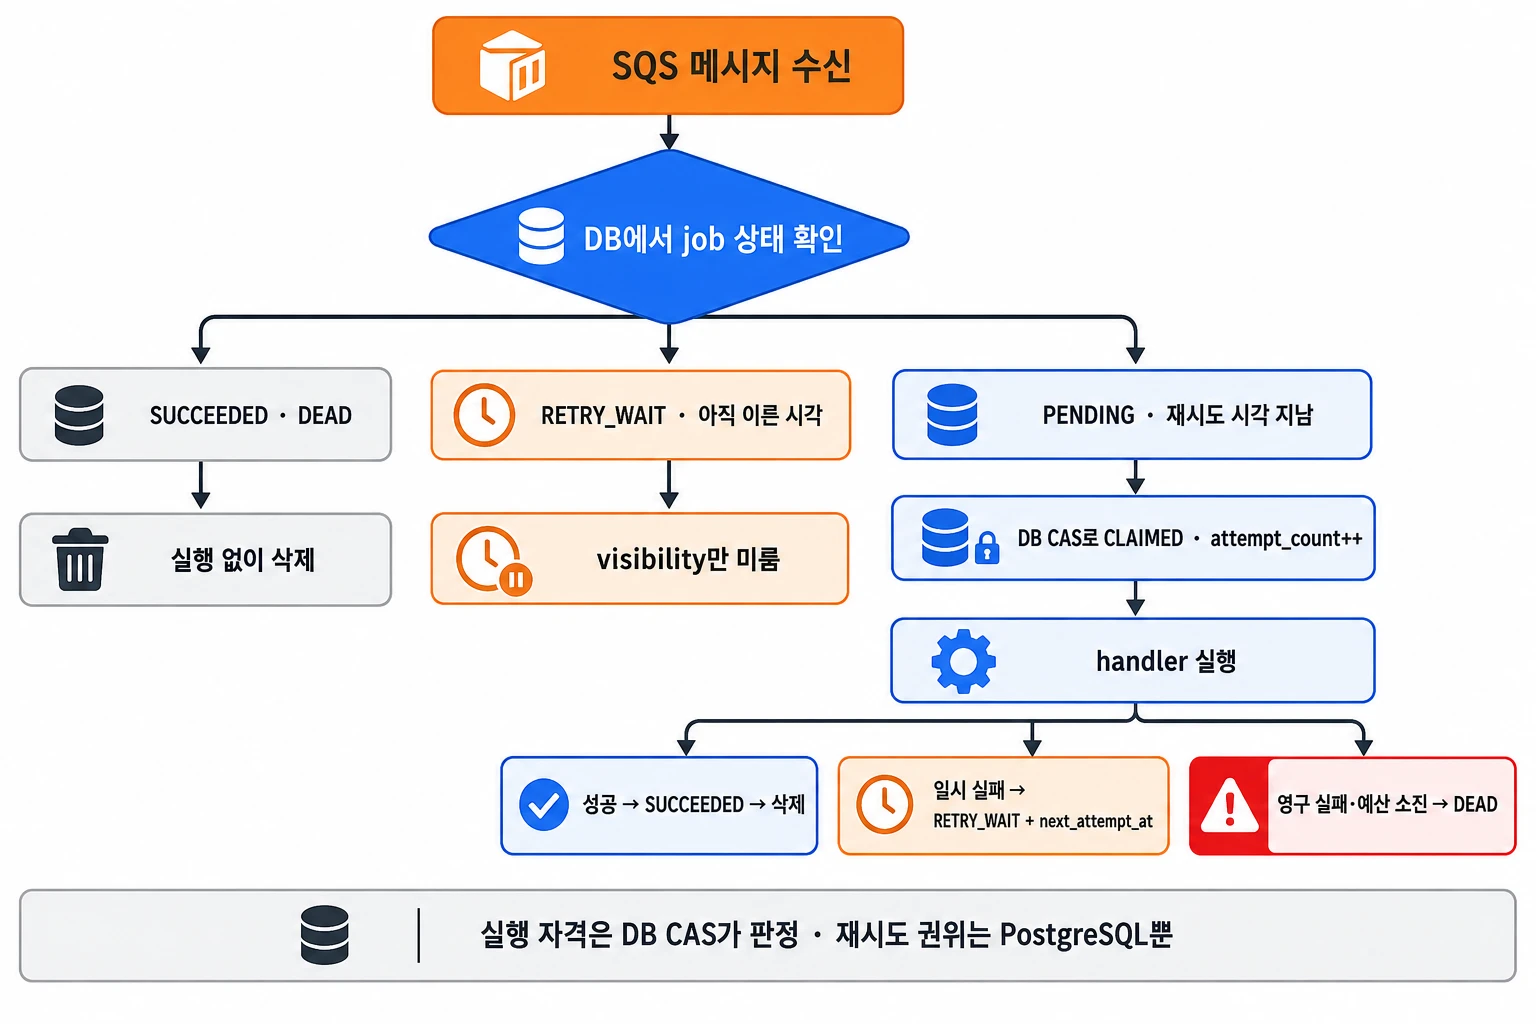 실행 자격은 메시지가 아니라 DB CAS가 정하고, 이미 끝난 작업은 실행 없이 지운다.
장애 주입으로 발행 복구와 중복 처리 동작을 확인했다
프로세스가 종료된 뒤 발행을 복구할 수 있는지 실제 코드로 확인했다. 그래서 종료 지점을 의도적으로 고정한 fault injection으로 네 시나리오를 각 100회 반복 측정했다.
측정 방법 — 로컬 DB와 고정 응답 publisher로 실패 지점을 재현했다
별도 Python child process를 특정 지점에서 os._exit(137)로 강제 종료했다. commit 직후, transaction 도중처럼 죽는 지점을 시나리오마다 고정하고 100회씩 반복했다.
환경은 로컬이었다. PostgreSQL 16.14를 일회성 Docker container로 띄워 loopback(127.0.0.1:55433)에 붙였고, migrations-cloud 전체를 Flyway로 적용·validate했다.
코드는 우회하지 않았다. 실제 JobLedger·OutboxRelay·MinuteConsumer 코드를 그대로 돌렸다.
SQS publisher와 queue 표면만 같은 입력에 같은 응답을 내는 대역(deterministic fake)으로 뒀다. 네트워크 흔들림이나 실제 큐 지연 같은 변수를 빼고, 100회를 돌려도 매번 같은 조건에서 유실·중복만 순수하게 세고 싶었기 때문이다.
그래서 이 측정은 “실제 SQS에 보냈다”가 아니다. 정확히는 Relay가 publisher 경계까지 event를 전달하고 PUBLISHED로 확정했다는 데까지의 검증이다.
1
uv run --project src/apps/cloud/data-pipeline python measure_edge_outbox.py --repetitions 100
이 명령이 네 시나리오를 각 100회씩 돌리고, 유실·중복 수치를 JSON으로 뱉었다.
결과 — 직접 방식 baseline은 100건 누락, Outbox는 유실 0·중복 업무 실행 0·재개 발행 100건
| 시나리오 | 시도 | DB job | outbox event | Relay 발행 | 업무 실행 | 결과 |
|---|---|---|---|---|---|---|
| DB job commit 후, 메시지 발행 전 종료 (직접 방식 baseline) | 100 | 100 | 0 | 0 | 0 | 발행 의도 100건 누락 |
| job insert와 outbox insert 사이 transaction 도중 종료 | 100 | 0 | 0 | 0 | 0 | 부분 commit 0건 |
| job+outbox commit 직후 종료 후 Relay 재개 | 100 | 100 | 100 | 100 | - | 메시지 누락 0건 |
| 같은 event를 두 번씩 전달 | 200 deliveries | 100 | 100 | 100 | 100 | 중복 업무 실행 0건 |
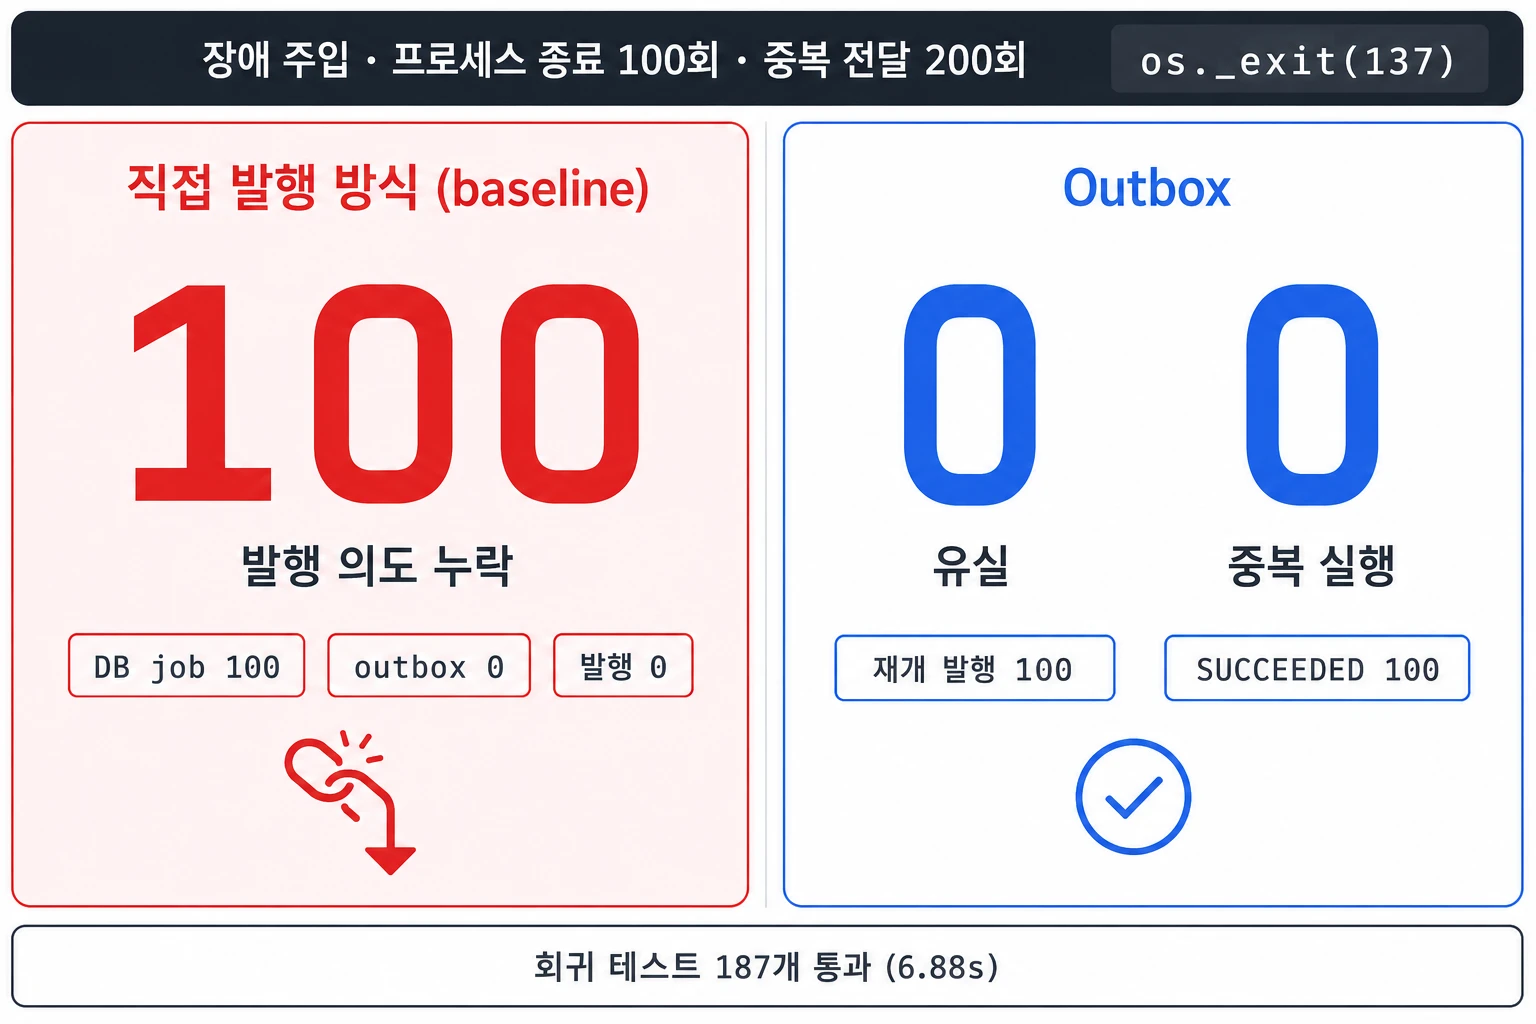 직접 발행은 100번 죽여 100건을 잃지만, Outbox는 같은 100번에 유실도 중복 실행도 0이다.
첫 줄이 직접 발행 방식의 baseline이다. commit 후 send 전에서 100번 죽였더니 DB에는 job 100건이 남았는데, 이를 깨울 메시지는 0건이었다.
발행 의도 100건이 통째로 누락됐다. 이건 과거 운영 장애를 끌어다 붙인 사례가 아니라, 종료 지점을 고정해 dual-write가 어디서 깨지는지 재현한 비교 baseline이다.
두 번째 줄은 한 트랜잭션의 원자성을 확인한 결과였다. job insert와 outbox insert 사이에서 100번 죽였는데 부분 commit은 0건이었다.
세 번째 줄은 복구를 봤다. job과 outbox를 commit한 직후 100번 죽인 뒤 별도 Relay를 재개했더니, 남은 100건 NEW event를 10건 batch로 10회 발행하고 11번째 idle tick에서 배출 완료를 확인했다.
즉 100건 모두 PUBLISHED, 누락은 0건이었다. 잠깐 멈춘 수도꼭지를 다시 틀었더니 막혀 있던 물이 그대로 빠져나간 셈이었다.
네 번째 줄은 멱등 확인이었다. 동일 event body 100개를 완료까지 보낸 뒤, 같은 body 100개를 다시 전달했다.
총 200회 수신 중 handler 실행은 100회였고, SUCCEEDED row도 100건이었다. 뒤늦게 들어온 두 번째 100건은 terminal 상태만 확인하고 업무 실행 없이 ack됐다.
원시 출력은 아래처럼 나왔다.
1
2
3
4
5
6
7
8
{
  "missing_publish_intents": 100,
  "partial_commits": 0,
  "missing_messages": 0,
  "duplicate_business_effects": 0,
  "duplicate_terminal_skips": 100,
  "message_deletes": 200
}
missing_publish_intents: 100이 직접 방식 baseline의 유실이었다. 반대로 Outbox 경로의 missing_messages와 duplicate_business_effects는 둘 다 0이었다.
duplicate_terminal_skips: 100은 재전달된 100건이 terminal 상태 확인만으로 걸러졌다는 뜻이었다. message_deletes: 200은 200회 수신을 전부 ack해 큐에 찌꺼기를 남기지 않았다는 의미였다.
이 네 실패 조건은 전부 회귀 테스트에 넣었다. test_commit.py·test_jobs.py·test_relay.py·test_consumer.py가 187개 통과했고, 끝나는 데는 6.88초 걸렸다.
다시 이 조건이 깨지면 운영보다 테스트가 먼저 울게 만들고 싶었다.
발행 대상을 destination별로 나눠 장애 영향을 제한했다
Relay가 NEW event를 batch로 집어 발행할 때, 처음에는 오래된 것부터 전역으로 집으면 된다고 생각했다. 그런데 destination이 셋, 즉 뉴스·가격·설명으로 갈라지자 그 단순함이 바로 함정으로 보였다.
destination별 claim — 장애 큐의 재시도가 다른 큐를 밀어내지 않게 한다
세 큐 중 하나가 장애로 막히면 그 큐로 갈 event가 재시도 대상으로 계속 쌓였다. 먼저 실패한 행일수록 먼저 늙었기 때문에, 재시도 대상은 자연스럽게 나이가 많아졌다.
전역 FIFO로 오래된 것부터 집으면 이 오래된 재시도 행이 매 batch를 채웠다. 그러면 멀쩡한 레인의 새 event는 계속 자리를 못 얻고 뒤로 밀렸다.
큐 하나가 죽었을 뿐인데 나머지 둘까지 같이 굶는 꼴이었다. 한 차선 사고가 세 차선을 다 막는 고속도로와 비슷했다.
그래서 claim_outbox_batch는 전역이 아니라 destination별로 claim하게 바꿨다. 장애 레인의 적체가 정상 레인의 batch 자리를 먹지 못하게 레인을 아예 격리했다.
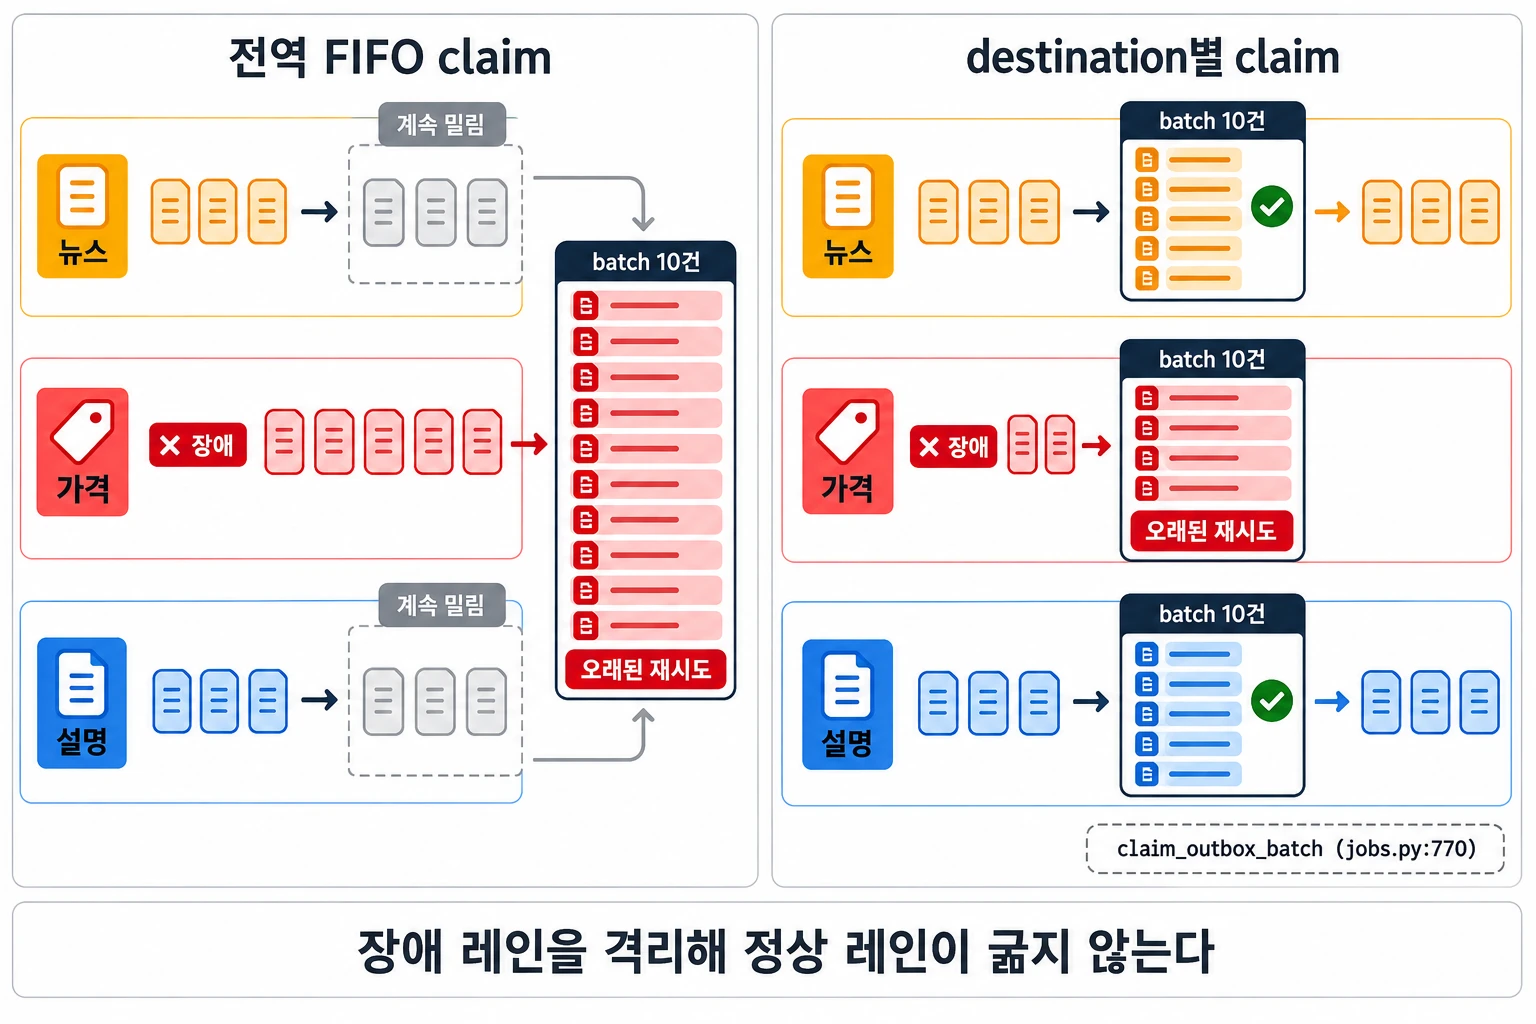 전역으로 오래된 것부터 집으면 장애 레인이 매 batch를 먹지만, destination별로 집으면 정상 레인이 굶지 않는다.
일시 실패 — next_attempt_at에 다음 발행 시각을 기록한다
재시도를 몇 번 실패하면 포기하는 max attempts를 둘 수도 있었다. 흔하고 구현도 쉬운 방법이었다.
하지만 그 방식은 큐가 잠깐 막힌 몇 분 동안 멀쩡한 event까지 같이 죽였다. 큐 장애가 5분 났다고 아무 문제 없는 event를 DEAD로 보내는 건 너무 거칠었다.
그래서 일시 실패는 횟수로 포기하지 않았다. 다시 시도할 시각을 DB의 next_attempt_at에 적고, 그 시간이 오면 다시 집게 했다.
간격은 retry_base_seconds(2) * 2**attempt로 지수 backoff를 주되, retry_max_seconds(300)에서 멈추게 했다. 즉 2초 → 4초 → 8초로 벌어지다가 300초, 다시 말해 5분에서 붙박이가 됐다.
초반에는 촘촘하게 다시 두드려 잠깐 끊긴 큐를 빨리 따라잡았다. 장애가 길어지면 5분 간격으로 느긋하게 두드리면서 event를 죽이지 않고 살려뒀다.
재시도 정책이 DB에 살아 있으니, 큐 장애가 지나가면 event도 그대로 다시 나갔다. 포기 대신 보류를 택한 셈이었다.
발행할 수 없는 event는 예외로 죽이지 않고 DEAD로 격리했다
Relay가 발행하다 보면 아무리 다시 시도해도 절대 못 보내는 event가 나왔다. 이런 건 일시 실패와 섞으면 안 됐다.
예외로 죽으면 세 큐가 전부 멈춘다 — 그래서 발행 불가 event를 DEAD로 격리한다
destination이 미정의이거나 메시지 하나가 1 MiB를 넘으면, 같은 상태로 다시 시도해도 발행할 수 없다. 이런 개별 event의 문제와 배치 요청의 한도는 구분해야 한다. 여러 메시지가 배치 10건 또는 합계 1 MiB를 넘는 경우에는 요청을 나눠 보내는 대상이지, 각 event를 영구 실패로 볼 이유가 아니다.
여기서 Relay가 예외를 던지고 죽으면 다음 tick도 같은 event를 집고, 같은 자리에서 또 죽었다. 그 event가 batch 앞에 걸리면 뒤의 정상 event까지 못 나갔다.
발행 불가 하나가 세 큐 전체를 세워버리는 구조였다. 썩은 과일 하나를 빼지 않으면 상자 전체가 멈추는 셈이었다.
그래서 발행 불가 event는 예외로 올리지 않고 DEAD로 격리했다. 못 보내는 하나를 옆으로 치워, 뒤의 정상 event가 계속 흐르게 했다.
발행 설정 — queue URL 매핑이 누락되면 기동을 거부한다
destination↔queue URL 매핑에 오타가 나면 그 destination으로 갈 event가 전부 발행 불가가 됐다. 조용해서 더 위험한 종류의 파괴였다.
이건 런타임에 DEAD로 하나씩 흘려보낼 문제가 아니라고 봤다. 애초에 프로세스가 떠서는 안 되는 상태였다.
그래서 RelayConfig.__post_init__이 기동 시 destination↔queue URL을 검증하게 했다. 매핑이 누락되면 기동 자체를 거부했다.
설정 오타는 며칠 뒤 “왜 이 큐만 조용하지”로 발견하면 이미 늦었다. 배포 시점에 크게 터뜨리는 편이 훨씬 낫다고 판단했다.
상태 전이를 전부 CAS로 잠가 옛 세대 메시지가 새 작업을 마감하지 못하게 했다
at-least-once를 전제로 깔면 같은 메시지가 여러 번 오고, 가끔은 한참 뒤늦게 도착하기도 했다. 중복 수신 자체는 멱등으로 받으면 됐지만, 오래된 메시지가 새 상태를 오염시키는 건 다른 문제였다.
redrive_generation — 재처리 세대가 다른 메시지를 차단한다
실패한 job을 수동으로 다시 처리하는 redrive에서는 세대를 올려 새 실행을 구분한다. 그러면 옛 세대의 메시지가 뒤늦게 도착해, 이미 새 세대로 넘어간 job을 집어 엉뚱하게 마감할 수 있었다.
그래서 상태 전이를 전부 조건부 갱신, 즉 CAS로 잠갔다. _transition은 WHERE에 다섯 개 조건을 걸어 하나라도 어긋나면 갱신이 0행으로 튕기게 했다.
1
2
WHERE job_id = ? AND claimed_by = ? AND status = 'CLAIMED'
      AND attempt_count = ? AND redrive_generation = ?
claim_job도 redrive_generation을 WHERE에 바인딩해, 옛 세대 메시지가 새 세대 job을 집지 못하게 막았다. 가격 job은 여기에 window 세대까지 더 대조했다.
_reject_if_stale은 FOR UPDATE OF w로 correction commit과의 TOCTOU를 막고, 세대가 낮으면 그 job을 DEAD(‘STALE’)로 보냈다. 늦게 온 옛 편지가 새 주소의 우편함을 열지 못하게 한 셈이었다.
판정 불가 메시지 — DLQ에 남겨 원인을 확인한다
파싱이 안 되거나, job 행이 없거나, 배선이 잘못된 메시지도 들어왔다. 이런 걸 그냥 지워버리면 왜 잘못됐는지 보여줄 근거까지 같이 사라졌다.
그래서 판정 불가 메시지는 실행도 하지 않고 delete도 하지 않았다. 그냥 남겨두고, maxReceiveCount가 차면 SQS가 알아서 DLQ로 보내게 했다.
근거는 DLQ에 남아야 했다. 원인을 보존하지 않는 삭제는 청소가 아니라 은폐에 가까웠다.
DLQ 도착 처리도 CAS로 잠갔다. dead_on_dlq는 DB가 non-terminal일 때만 DEAD로 바꾸고, 살아 있는 lease의 CLAIMED는 건드리지 않았다.
실제 SQS 검증과 S3 산출물 회수는 남아 있다
여기까지 밀어붙이고도, 아직 선을 못 그은 경계가 남아 있었다. 그건 덮지 않고 그대로 적어두는 편이 맞았다.
첫째, Relay publisher는 deterministic fake로 검증했다. 실제 AWS SQS를 포함한 end-to-end 검증은 아직 하지 않았다.
측정에서 확인한 유실 0은 지정한 장애 주입 조건에서 Relay가 publisher 경계까지 event를 전달하고 PUBLISHED로 확정한 결과다. 그 너머 실제 큐 왕복까지 확인한 건 아니다.
둘째, S3와 PostgreSQL은 하나의 transaction이 아니다. Price Worker는 immutable S3 artifact를 먼저 쓰고, 그다음 PG transaction을 commit한다.
artifact가 먼저 durable하게 박혀야 DB가 그걸 가리킬 수 있어서 순서가 이렇게 정해졌다. 하지만 바로 그 사이에서 죽으면 artifact만 남고 job은 안 남는 orphan artifact가 생겼다.
이건 dual-write가 S3–PG 경계에서 한 번 더 나타난 경우였다. job–outbox는 같은 PG 트랜잭션으로 닫았지만, S3는 트랜잭션 밖이라 같은 방법이 통하지 않았다.
DB가 참조하지 않는 S3 산출물(orphan artifact)을 찾아 대조·회수하는 작업은 아직 미해결이다. 문 하나를 닫았더니 복도 끝에 다른 문이 보인 셈이었다.
이번 작업 중 관련된 부수 사례도 하나 있었다. 과거일 재수집(backfill)이 실시간 판정용 outbox event를 발행하는 바람에, 며칠 전 가격 기준으로 당일 분석·LLM 설명이 실행되는 걸 390건 관측했다.
backfill은 window와 산출물은 그대로 보존하되, 실시간 outbox event만 만들지 않도록 경계를 고쳐 막았다. 숫자 390건이 알려준 건 로직의 사소한 새는 틈도 실시간 경로에 붙으면 금방 커진다는 점이었다.
마무리
이번 구현에서는 PostgreSQL 기록과 SQS 발행을 하나의 트랜잭션에 묶을 수 없었다. 그래서 순서 조정으로 유실을 없애려던 시도를 접고, 작업과 발행 의도를 한 PostgreSQL 트랜잭션에 묶은 뒤 발행은 commit 밖 Relay로 빼냈다.
중복은 없애려 들지 않았다. 대신 멱등으로 되받았다.
가장 인상 깊었던 지점은 두 실패 순서가 대칭으로 깨지는 걸 직접 본 순간이었다. DB를 먼저 해도, SQS를 먼저 해도 어느 한쪽에는 반드시 불일치가 남는다는 걸 보고 나서야, 이 문제가 순서로 풀릴 성질이 아니라는 걸 인정했다.
끝까지 관통한 판단은 하나였다. 유실과 중복 중 하나를 반드시 감수해야 한다면, 유실을 버리고 중복을 멱등으로 받는 쪽이 훨씬 안전했다.
참고 자료
- Amazon SQS SendMessageBatch — 개별 메시지와 배치 요청의 크기·건수 제한