Kafka의 토픽·파티션·컨슈머 그룹
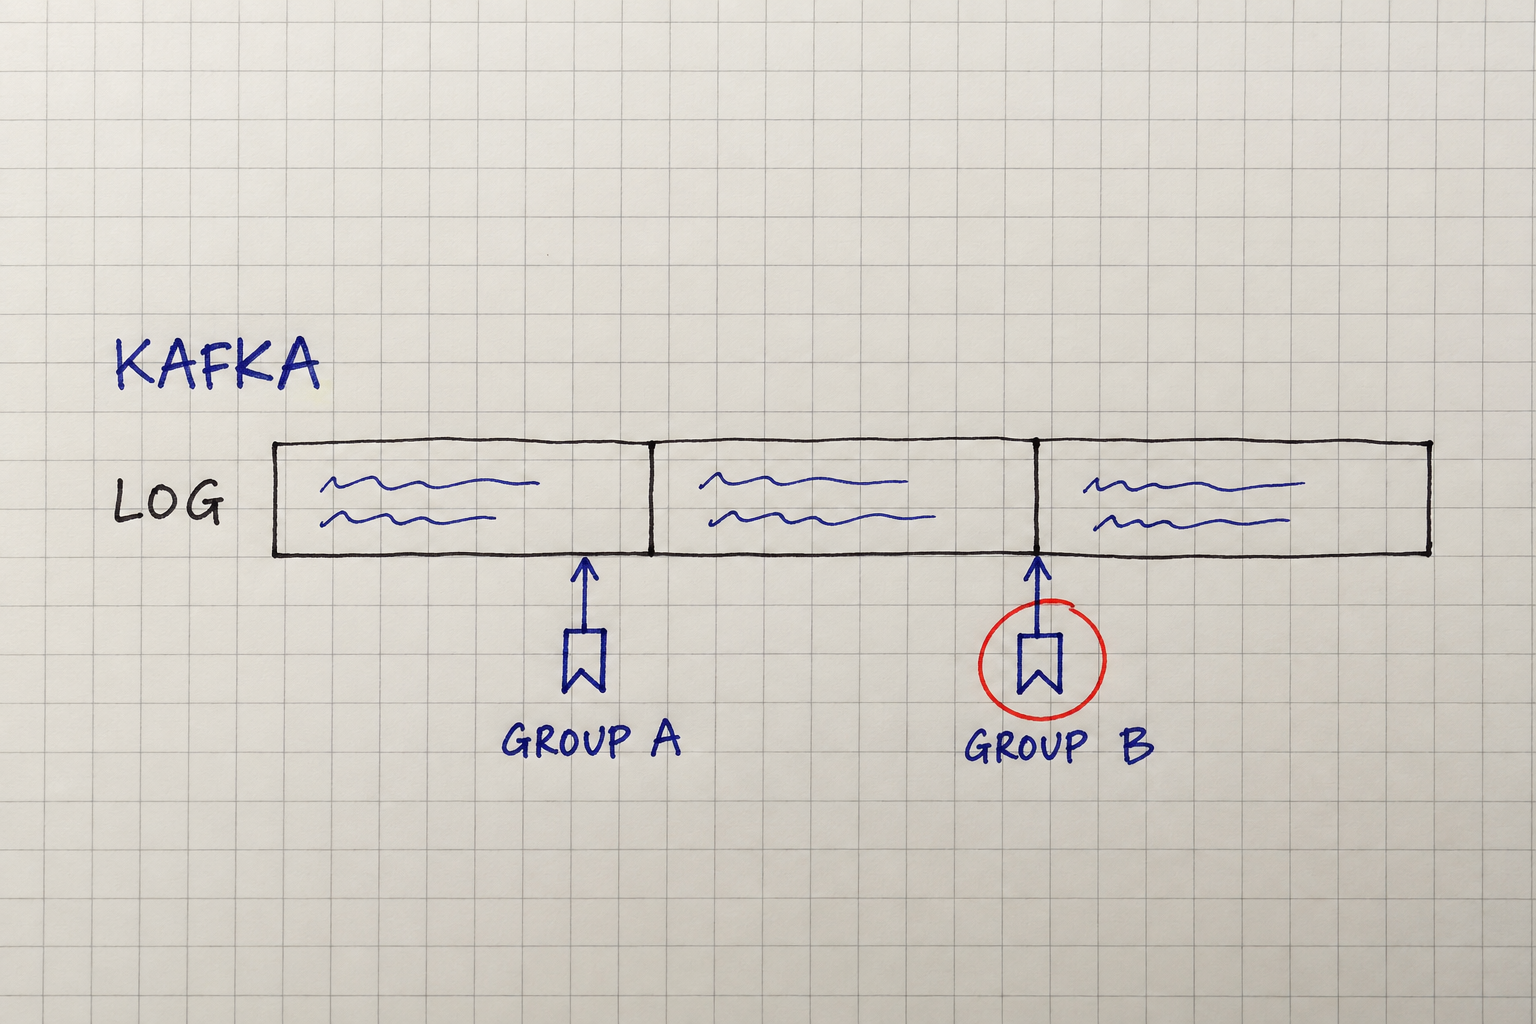
Kafka는 한 시스템에서 발생한 일을 기록하고, 다른 시스템들이 그 기록을 읽어 처리하도록 연결하는 플랫폼이다. 데이터를 만드는 쪽과 사용하는 쪽을 분리하므로, 여러 서비스가 같은 기록을 각자의 속도로 사용할 수 있다.
이때 필요한 것은 메시지를 전달하는 기능만이 아니다. 받는 서비스가 잠시 멈췄다가 이어서 처리하거나, 계산 방법이 바뀌어 과거 기록을 다시 읽어야 할 수도 있다. Kafka는 이벤트를 보관하고 소비자별 읽기 위치를 관리하는 방식으로 이런 요구를 지원한다.
핵심은 저장된 기록과 각 소비자의 진행 상태가 분리돼 있다는 점이다. 기록을 어디에 나눠 저장하는지와 누가 어느 부분을 읽는지를 함께 이해하면, Kafka의 병렬 처리와 재처리 방식도 연결해서 볼 수 있다.
이벤트를 만드는 쪽과 처리하는 쪽은 토픽으로 연결된다
주문이 결제되면 창고 서비스가 재고를 반영하고, 분석 서비스가 매출을 집계한다고 가정해보자. 주문 서비스가 두 서비스를 직접 호출하는 대신 Kafka에 결제 사실을 남기면, 두 서비스가 이를 읽어 각자의 업무를 수행하도록 구성할 수 있다. 아래 주문 이름과 숫자는 모두 이 구조를 설명하기 위한 예시다.
여기서 주문 서비스처럼 기록을 쓰는 애플리케이션을 프로듀서, 창고·분석 서비스처럼 기록을 읽는 애플리케이션을 컨슈머라고 부른다. 기록을 저장하고 읽기·쓰기 요청을 받는 Kafka 서버는 브로커다.
Kafka가 재고를 바꾸거나 매출을 계산하는 것은 아니다. Kafka는 처리할 사건을 보관하고 전달하며, 실제 업무는 기록을 읽은 애플리케이션이 담당한다. 주문 서비스는 후속 업무 각각의 완료를 기다리는 대신 Kafka에 기록을 남기는 흐름을 갖게 된다.
이벤트와 토픽 — 발생한 사실을 주제별로 모은다
“주문이 결제됐다”처럼 일어난 사실을 나타내는 데이터가 이벤트다. Kafka 문서에서는 레코드나 메시지라고도 부른다.
주문 관련 이벤트를 orders라는 이름으로 모은다면 이 이름이 토픽이다. 토픽은 이벤트를 저장하고 구독하는 논리적인 묶음으로, 컨슈머는 어떤 토픽을 읽을지 선택한다.
예를 들어 order-42 주문의 결제 이벤트는 다음처럼 표현할 수 있다. Kafka가 요구하는 JSON 규격이 아니라 키와 값의 구분을 보여주는 예시이며, 금액은 32,000원을 가정한다.
1
2
3
4
5
6
7
8
9
{
  "key": "order-42",
  "value": {
    "event_id": "evt-order-42-paid",
    "event_type": "OrderPaid",
    "order_id": "order-42",
    "amount": 32000
  }
}
value에는 어떤 사건이 발생했는지 담는다. key는 여기서 주문 번호를 사용하며, 뒤에서 같은 주문의 이벤트를 같은 저장 구간으로 모으는 기준이 된다. event_id는 이 예시에서 사건 하나를 구분하기 위해 정한 식별자다.
보관과 소비 — 읽은 뒤에도 기록을 다시 사용할 수 있다
컨슈머가 이벤트를 읽었다고 그 이벤트가 바로 삭제되지는 않는다. 창고 서비스가 먼저 읽었더라도 분석 서비스가 나중에 읽을 수 있고, 이미 읽은 기록을 다시 처리하는 것도 가능하다. 여러 사람이 각자의 책갈피를 두고 같은 책을 읽는 것과 비슷하다.
다만 읽은 뒤에도 남아 있다는 것이 영구 보관을 뜻하지는 않는다. 기록은 설정한 보관 기간이나 저장 크기 등에 따라 정리될 수 있다. 같은 키의 최신 상태를 남기도록 정리하는 방식도 있으므로, 보관 정책에 따라 모든 변경 이력이 남지는 않을 수 있다.
따라서 재처리가 필요하다면 먼저 필요한 기록이 얼마나 오래 남아 있어야 하는지 정해야 한다. 읽기 위치를 과거로 옮기더라도 이미 삭제된 기록까지 되살릴 수는 없다.
파티션은 데이터를 나누는 단위이자 순서가 유지되는 범위다
토픽의 기록을 여러 구간으로 나누면 나눠서 저장하고 동시에 처리할 수 있다. 이 독립적인 저장 구간을 파티션이라고 부른다. 새 이벤트는 토픽의 파티션 중 하나에 기록되며, 각 파티션에서는 기존 기록 뒤에 새 기록이 이어진다.
orders 토픽의 일부를 보면 다음처럼 생각할 수 있다. P0에는 order-42의 생성·결제·배송 기록이, P1에는 order-77의 생성·결제 기록이 쌓여 있다.
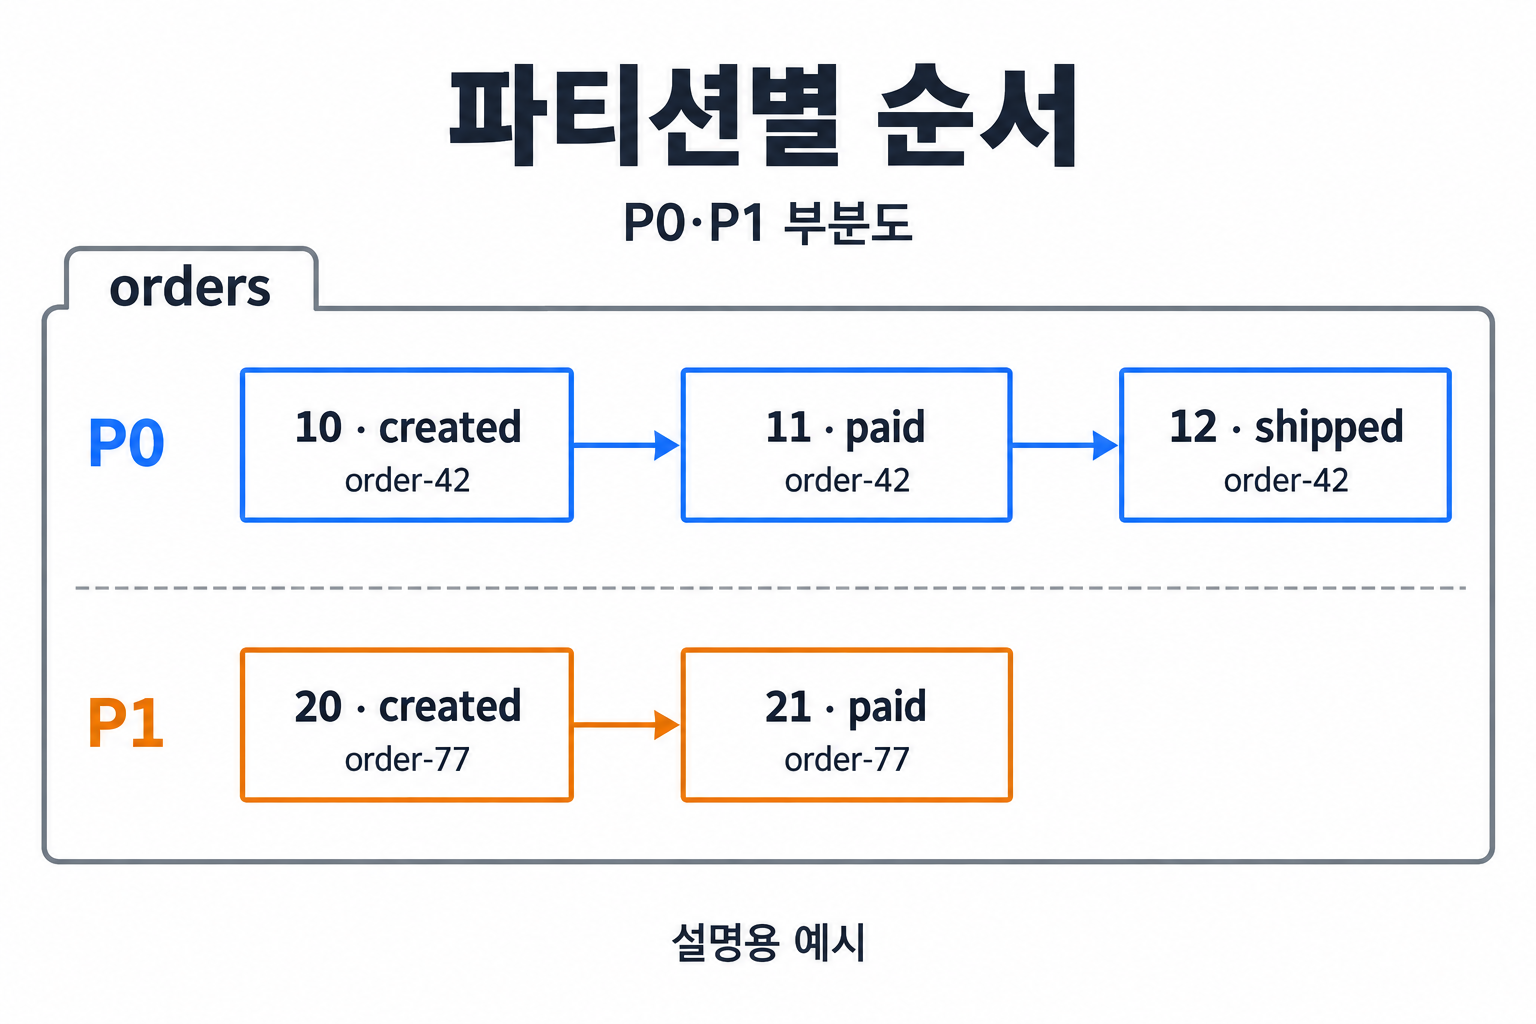
같은 파티션 안에서는 기록 순서가 이어지지만 서로 다른 파티션 사이에는 공통 순번이 없다
그림에서 이벤트 앞의 숫자는 오프셋이다. 파티션 안에서 각 기록의 위치를 나타내는 번호로, P0의 10·11·12는 그 파티션에 기록된 순서를 보여준다. P0의 12와 P1의 20을 비교해 어느 사건이 먼저 일어났는지 판단할 수는 없다.
오프셋은 토픽 전체의 공통 순번이 아니다. 파티션이 다르면 같은 오프셋이라도 다른 기록을 가리킨다. 따라서 특정 이벤트의 위치를 말하려면 토픽과 파티션, 오프셋을 함께 봐야 한다.
파티션 키 — 순서를 함께 지킬 대상을 정한다
같은 주문의 결제와 배송을 순서대로 읽어야 한다면, 두 이벤트를 같은 파티션에 모아야 한다. 키를 기준으로 파티션을 정하는 일반적인 방식에서는 같은 키가 같은 파티션으로 향한다. 앞의 예시에서 주문 번호를 키로 사용한 이유다.
다만 같은 키가 계속 같은 곳으로 가려면 파티션을 정하는 규칙과 파티션 수가 유지돼야 한다. 파티션 수를 바꾸면 같은 키라도 이후 이벤트가 다른 파티션에 기록될 수 있으므로, 순서가 중요한 흐름에서는 증설할 때도 이 관계를 확인해야 한다.
이때 Kafka가 유지하는 것은 파티션에 기록된 순서다. 배송 이벤트가 결제 이벤트보다 먼저 도착했다면, Kafka가 업무의 의미를 해석해 순서를 바로잡아 주지는 않는다. 읽은 이벤트를 애플리케이션이 별도 작업으로 동시에 처리한다면, 업무 완료 순서도 별도로 관리해야 한다.
반대로 모든 주문에 같은 키를 사용하면 기록이 한 파티션으로 몰릴 수 있다. 주문별 순서를 지키면서 여러 주문을 나눠 처리하려면, 어떤 대상을 같은 키로 묶을지가 중요하다. 파티션은 단순한 저장 공간 분할이 아니라 순서와 병렬 처리를 함께 결정하는 단위다.
컨슈머 그룹은 같은 업무를 나누고 다른 업무를 분리한다
같은 그룹 — 여러 컨슈머가 한 업무를 나눠 맡는다
창고 서비스 한 대가 모든 주문을 처리하기 어렵다면 같은 역할의 컨슈머를 여러 대 실행할 수 있다. 이들을 하나로 묶어 파티션을 나눠 맡게 하는 단위가 컨슈머 그룹이다. 같은 group.id를 사용하는 컨슈머들이 같은 그룹에 속한다.
일반적인 컨슈머 그룹 구독에서는 한 파티션을 같은 그룹의 컨슈머 한 대가 맡는다. 한 컨슈머가 여러 파티션을 맡을 수는 있다.
예를 들어 orders에 파티션이 3개이고 창고 그룹에 컨슈머가 2대라면, 한 대가 2개를 맡고 다른 대가 1개를 맡는 식으로 나눈다. 같은 토픽만 구독하는 이 그룹을 4대로 늘리면 적어도 한 대는 파티션을 할당받지 못한다. 따라서 이 소비 방식에서는 컨슈머 수만 늘려 읽기 병렬성을 계속 높일 수 없다.
다른 그룹 — 같은 이벤트를 업무마다 독립적으로 읽는다
창고 처리와 매출 분석은 일을 나눠 맡는 관계가 아니다. 둘 다 모든 주문을 받아서 각자의 일을 해야 한다. 이때는 warehouse와 analytics처럼 그룹을 분리한다.
서로 다른 그룹은 같은 토픽을 읽으면서도 읽기 위치를 따로 관리한다. 창고 그룹이 현재 주문까지 처리했더라도 분석 그룹은 더 이전 기록부터 읽고 있을 수 있다. 어느 한 그룹이 앞으로 읽었다고 다른 그룹의 위치까지 움직이지 않는다.
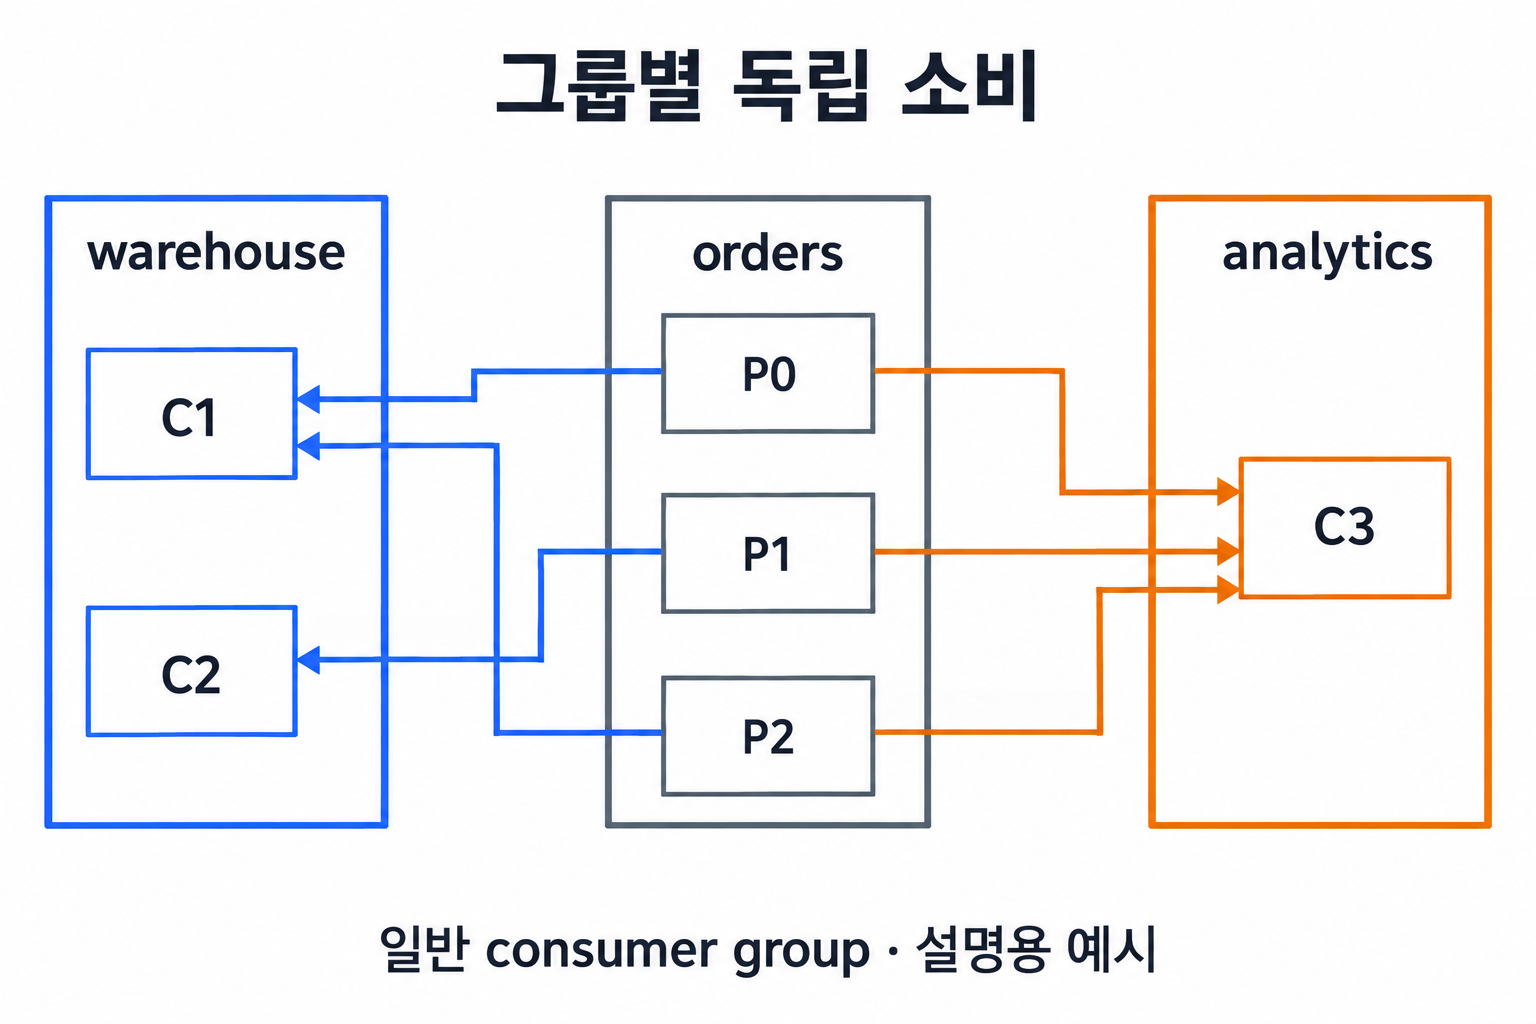
하나의 orders 토픽을 두 그룹이 독립적으로 구독하고 각 그룹 안에서만 파티션을 나눠 맡는다
| 비교 기준 | 같은 그룹의 컨슈머 | 서로 다른 그룹의 컨슈머 |
|---|---|---|
| 업무 관계 | 같은 일을 나눠 맡는다 | 각자의 일을 수행한다 |
| 파티션 읽기 | 그룹 안에서 담당을 나눈다 | 같은 파티션을 각각 읽을 수 있다 |
| 읽기 위치 | 그룹·토픽·파티션 기준으로 관리한다 | 다른 그룹과 분리해 관리한다 |
| 예시 | 창고 처리 인스턴스 2대 | 창고 처리와 매출 분석 |
창고와 분석을 같은 그룹에 넣으면 각 서비스가 모든 주문을 받는 대신, 일부 파티션씩 나눠 받게 된다. 그룹 ID는 업무를 함께 나눠 할 대상을 정하는 이름이다.
컨슈머가 종료되거나 새로 들어오면 파티션 담당이 바뀔 수 있다. 이를 리밸런싱이라고 한다. 다른 컨슈머가 이어서 처리하려면 어디까지 완료했는지 알 수 있어야 하므로, 그룹의 업무 분담은 오프셋 관리와 연결된다.
오프셋 커밋은 처리 결과가 아니라 다시 시작할 위치를 남긴다
커밋 — 다음에 읽을 위치를 저장한다
컨슈머가 데이터를 가져오면 현재 읽기 위치는 앞으로 이동한다. 하지만 데이터를 받았다는 사실만으로 DB 갱신이나 매출 계산까지 끝났다고 볼 수는 없다. 읽기와 업무 완료 사이에는 간격이 있다.
컨슈머는 재시작할 때 사용할 위치를 별도로 저장할 수 있는데, 이를 오프셋 커밋이라고 부른다. 책을 읽다가 책갈피를 꽂는 것과 비슷하다. 프로세스가 종료되더라도 마지막으로 저장한 위치를 기준으로 이어서 읽는다.
앞의 P0에서 오프셋 11까지 업무를 완료했다면 다음 읽기 위치인 12를 커밋하는 식이다. 커밋 값 12는 “12번까지 처리했다”가 아니라 “12번 위치부터 이어서 읽는다”는 뜻이다.
중복 처리 — DB 반영과 커밋 사이에도 장애가 날 수 있다
창고 컨슈머가 오프셋 11의 결제 이벤트를 읽고 DB에서 재고를 차감했다고 가정해보자. 그런데 다음 위치인 12를 커밋하기 직전에 프로세스가 종료됐다. 마지막으로 저장된 커밋 위치가 11이라면 새 컨슈머는 이미 재고에 반영한 이벤트를 다시 읽게 된다.
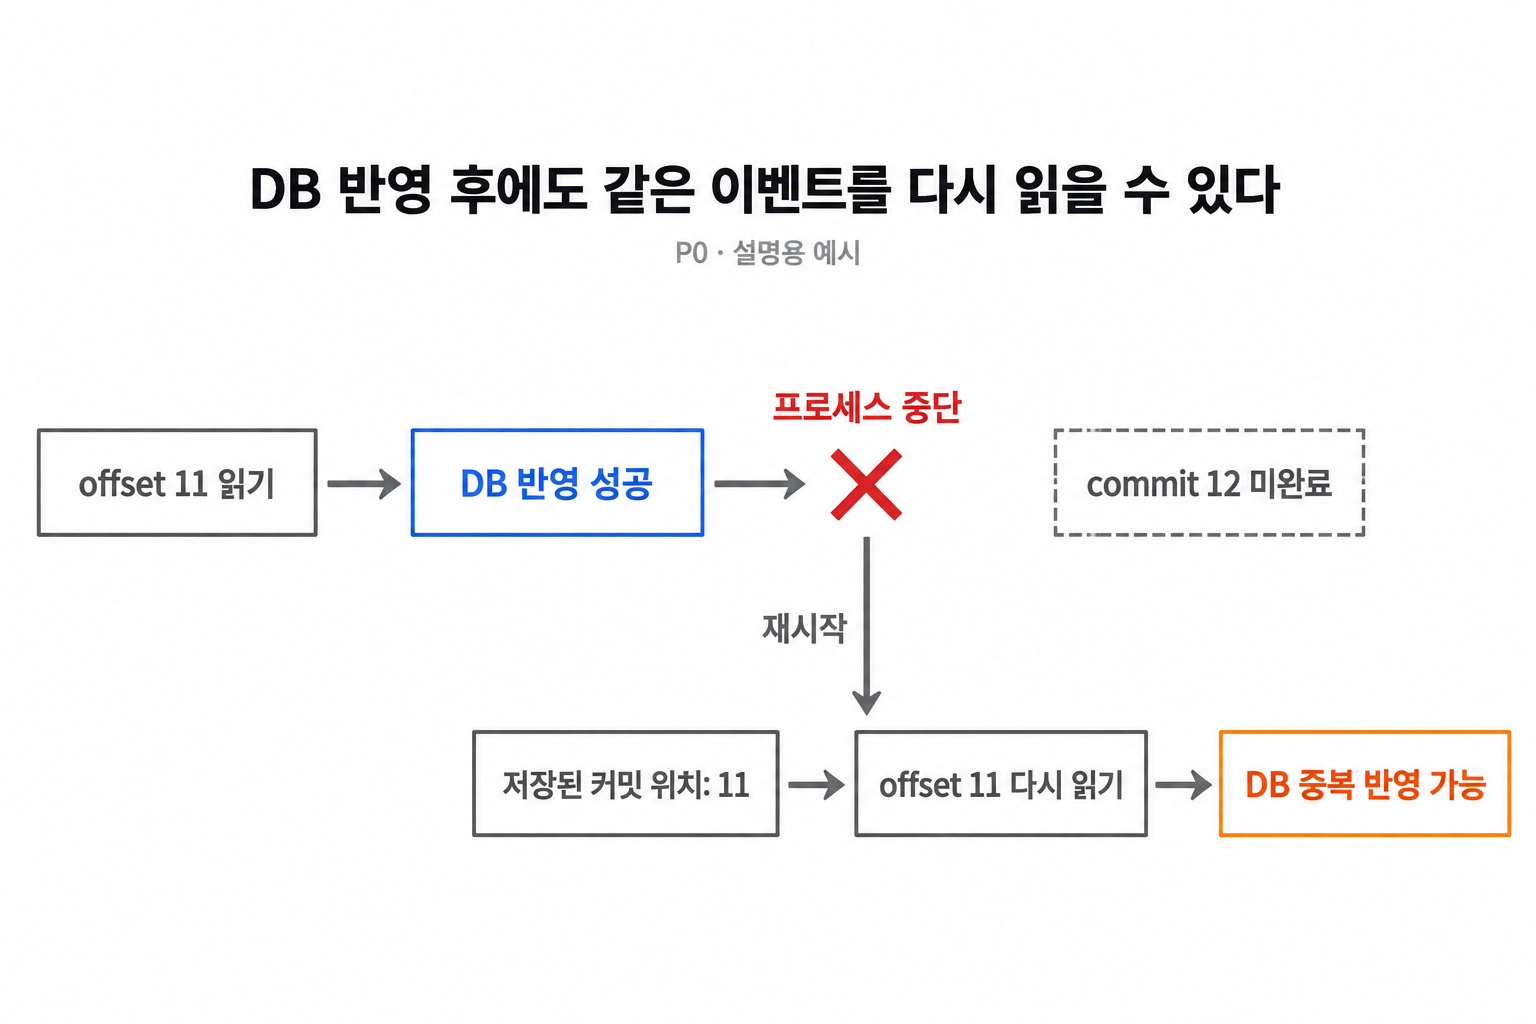
외부 DB 반영과 오프셋 커밋 사이에 장애가 나면 같은 이벤트의 업무가 다시 실행될 수 있다
그대로 재고를 한 번 더 차감하면 하나의 주문이 두 번 반영된다. 이벤트가 Kafka에 잘 보관돼 있어도, 외부 DB의 업무가 한 번만 실행되는 것까지 자동으로 보장되는 것은 아니다.
반대로 오프셋을 먼저 커밋하면 다른 문제가 생긴다. 12를 커밋한 뒤 재고를 바꾸기 전에 종료되면, 재시작한 컨슈머는 12부터 읽으므로 11의 재고 반영을 건너뛸 수 있다. 커밋 순서를 바꾸는 것만으로 중복과 누락을 동시에 없앨 수는 없다.
이미 처리한 이벤트가 다시 와도 결과가 달라지지 않도록 만드는 성질을 멱등성이라고 한다. 예시에서는 이벤트의 event_id를 이용해 처리 이력을 남기고, 같은 ID의 재고 변경을 반복하지 않도록 구성할 수 있다.
이때 처리 이력과 재고 변경은 하나의 DB 트랜잭션으로 묶어 함께 성공하거나 함께 취소되게 해야 한다. 이력만 저장된 뒤 재고 변경이 실패하거나, 재고만 바뀐 뒤 이력 저장이 실패하면 다시 불일치가 생기기 때문이다. 이것은 Kafka 설정 하나로 끝나는 문제가 아니라 애플리케이션과 DB가 함께 다뤄야 하는 부분이다.
Kafka 안에서 한 토픽을 읽고 다른 토픽에 결과를 쓰는 경우에는 결과와 소비 위치를 하나의 트랜잭션으로 묶는 기능을 사용할 수 있다. 하지만 그 트랜잭션에 외부 DB 변경이나 결제 API 호출까지 자동으로 포함되지는 않는다. “정확히 한 번 처리한다”는 보장을 볼 때는 어디까지 함께 반영하는지 확인해야 한다.
도입 여부는 독립적인 소비와 재처리 요구로 판단한다
Kafka는 같은 사건을 여러 서비스가 각자 사용하는 흐름에 잘 맞는다. 주문 처리는 계속 진행하면서 분석 서비스가 잠시 멈췄다가 이어서 읽거나, 집계 로직을 바꾼 뒤 남아 있는 기록을 다시 계산하는 식이다.
이런 흐름을 만들려면 토픽을 만든 다음 컨슈머를 붙이는 것만으로는 부족하다. 어떤 업무를 같은 그룹으로 묶을지, 어느 범위의 순서를 지킬지, 과거 기록을 얼마나 보관할지 정해야 한다. 장애 뒤 같은 이벤트를 다시 만났을 때 업무 결과가 어떻게 되는지도 함께 고려해야 한다.
| 확인할 요구 | 설계에서 정할 내용 |
|---|---|
| 여러 서비스가 같은 사건을 각각 처리한다 | 독립적인 업무별 컨슈머 그룹 |
| 같은 주문의 사건을 순서대로 처리한다 | 주문 키와 파티션 배치, 애플리케이션의 처리 순서 |
| 과거 기록을 다시 계산한다 | 필요한 이력이 남는 보관 정책 |
| 장애 뒤 처리를 이어간다 | 커밋 시점과 중복 처리 방지 방식 |
이력 공유나 재처리 없이 단일 작업을 다른 서비스에 위임하는 정도라면, 더 단순한 구성으로 요구를 충족할 수 있는지도 비교할 만하다. Kafka를 선택할 이유는 이름이나 처리량에 대한 기대보다, 여러 소비자의 진행 상태와 보관된 이벤트를 독립적으로 다뤄야 하는 요구에서 나온다.
마무리
토픽은 같은 주제의 이벤트를 모으고, 파티션은 그 기록을 나눠 저장하면서 순서의 범위를 정한다. 컨슈머 그룹 안에서는 파티션을 나눠 맡고, 그룹이 다르면 같은 기록을 각자의 위치에서 읽는다.
오프셋 커밋은 장애 뒤 다시 시작할 위치를 남긴다. 업무 완료와 커밋이 따로 일어나면 같은 이벤트를 다시 처리하거나 업무를 건너뛸 수 있으므로, 외부 DB를 변경하는 흐름에는 중복 처리를 고려한 설계가 필요하다.
이 구조 덕분에 여러 업무가 같은 사건을 서로 다른 속도로 처리하고, 필요한 기록이 남아 있는 동안 다시 사용할 수 있다. Kafka의 재처리와 병렬 처리는 파티션·그룹·커밋·보관 정책을 함께 정할 때 실제 업무 흐름으로 이어진다.
참고 자료
- Apache Kafka Introduction — 이벤트, 토픽, 프로듀서·컨슈머·브로커의 역할
- Apache Kafka Design — 저장 로그와 외부 시스템을 포함한 처리 보장의 범위
- Apache Kafka Topic Configs — 보관 기간·크기와 기록 정리 정책
- Confluent: Choose and Change the Partition Count — 파티션 수, 키 배치와 병렬 처리의 관계
- Confluent: What Are Apache Kafka Consumer Group IDs? — 그룹 내부의 분담과 그룹 간 독립 소비
- Confluent: Kafka Consumer Design — 파티션 할당과 컨슈머의 진행 위치
- Apache KafkaConsumer API — 읽기 위치, 커밋된 위치와 오프셋의 의미
- Confluent: Kafka Message Delivery Guarantees — 처리와 커밋 순서에 따른 중복·누락 가능성