macOS 로컬 STT 회의록 앱 구현
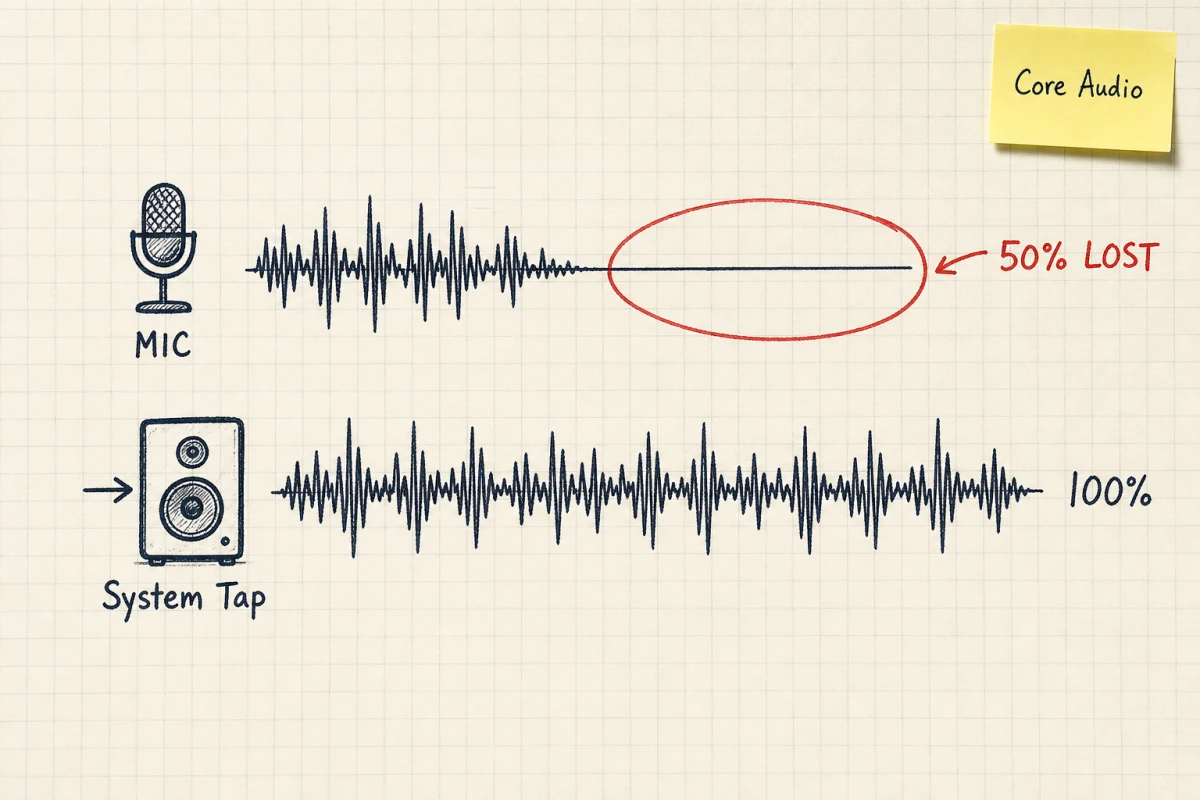
멘토님 STT 특강을 들었다. 실습은 미리 준비된 mp3 파일 하나를 노트북 셀에서 전사하는 데까지였고, 녹음은 Obsidian 마이크로 30초에서 2분을 잡는 게 전부였다.
그런데 내가 남기고 싶었던 건 5분짜리 mp3가 아니라 한 시간짜리 회의였다. 그동안 클로바노트를 썼지만, 회의 앱에서 시스템 소리로 나오는 상대방 목소리는 마이크에 잡히지 않았다. 강의가 준 파이프라인에도 “실제 회의를 어떻게 녹음하나”는 빠져 있었다.
그래서 강의 노트북을 macOS 로컬 앱으로 옮겼다. 전사 파이프라인은 내가 직접 짰고, 녹음과 UI는 AI에 맡겼다.
앱에서는 회의에 나올 이름을 모델에 알려주는 context biasing, 맥 GPU를 활용하는 MPS 배치, 중단한 전사를 이어가는 기능이 필요했다.
마이크 녹음에서는 회의 앱의 상대방 소리가 빠졌다
클로바노트를 쓰며 부딪힌 벽은 셋이었다. 무료 시간 제한, 시스템·앱 소리를 잡지 못하는 녹음 방식, 느린 업로드와 추출이었다.
결정타는 두 번째였다. 내가 사용한 마이크 녹음 방식에서는 회의 앱이 출력하는 상대방 목소리를 제대로 담지 못했다.
내 말만 텍스트로 남고 상대의 말은 비어 있는 기록을 회의록이라 부르기 어려웠다. 정작 결정이 오간 상대 쪽 발언이 남지 않으니 결국 다시 들어야 했다.
클라우드 STT의 세 벽 — 시간·소리·업로드
강의 자료의 진단도 같았다. 회의록이 결정과 R&R, 맥락을 제대로 남기지 못한다는 문제의식에서 출발해 클라우드 STT의 한계를 짚었다.
클라우드 STT는 사용량에 따라 과금되고 녹음 파일을 외부 서버에 올려야 한다는 부담이 있었다. 그래서 강의의 기준선은 처음부터 로컬 STT였다.
내가 겪은 불편과 강의의 진단이 정확히 겹쳤다. 긴 회의를 자주 돌릴수록 무료 시간은 금방 바닥났고, 파일을 클라우드로 왕복시키는 만큼 업로드와 추출도 느렸다.
로컬 처리와 Process Tap — 사용량 제한과 녹음 입력을 따로 해결한다
내 맥에서 전사하니 클라우드 서비스의 무료 사용량 제한과 업로드 대기에서 벗어날 수 있었다. 녹음 입력은 별도로 바꿔야 했다.
가장 중요한 건 소리였다. macOS의 Core Audio Process Tap으로 시스템·앱 오디오를 직접 따자, 마이크가 놓치던 상대방 목소리까지 통째로 잡혔다.
시간과 업로드는 로컬로 옮기는 것만으로 풀렸다. 소리 문제만큼은 녹음 방식을 마이크에서 시스템 오디오로 바꿔야 했다.
| 항목 | 당시 사용한 클로바노트 구성 | 로컬 앱 |
|---|---|---|
| 녹음 소스 | 마이크 | 시스템·앱 오디오 (Process Tap) |
| 시간 제한 | 무료 시간 제한 있음 | 서비스의 사용량 제한 없음 |
| 데이터 위치 | 외부 서버 업로드 | 내 맥 로컬 (outputs/) |
시스템 오디오 녹음과 전사 파이프라인을 연결했다
강의 실습의 녹음은 Obsidian의 Audio Recorder로 마이크를 30초에서 2분 잡는 게 전부였다. 모델을 비교하고 파이프라인을 한 번 통과시키는 목적에는 충분했다.
하지만 회의를 통째로 담으려니 마이크가 벽이 됐다. 마이크는 방 안의 공기를 타고 온 소리만 듣지만, 회의 앱의 상대방 목소리는 내 컴퓨터 안에서 스피커로 흘렀다.
상대방 소리를 담으려면 시스템·앱 오디오를 직접 캡처해야 했다. macOS에서는 Core Audio Process Tap이 그 일을 했다.
Process Tap — 마이크가 아니라 시스템·앱 소리를 직접 딴다
Process Tap은 특정 프로세스가 내는 소리를 시스템 오디오 경로에서 직접 가로챘다. 회의 앱이 스피커로 내보내는 상대방 목소리가 곧바로 녹음 파일에 들어왔다.
강의의 “마이크 → mp3”는 내 앱에서 “시스템·앱 오디오 → Process Tap → 세션 파일 → 전사 파이프라인”으로 바뀌었다. 이 경로로 회의 앱의 출력 소리를 전사 입력에 넣을 수 있었다.
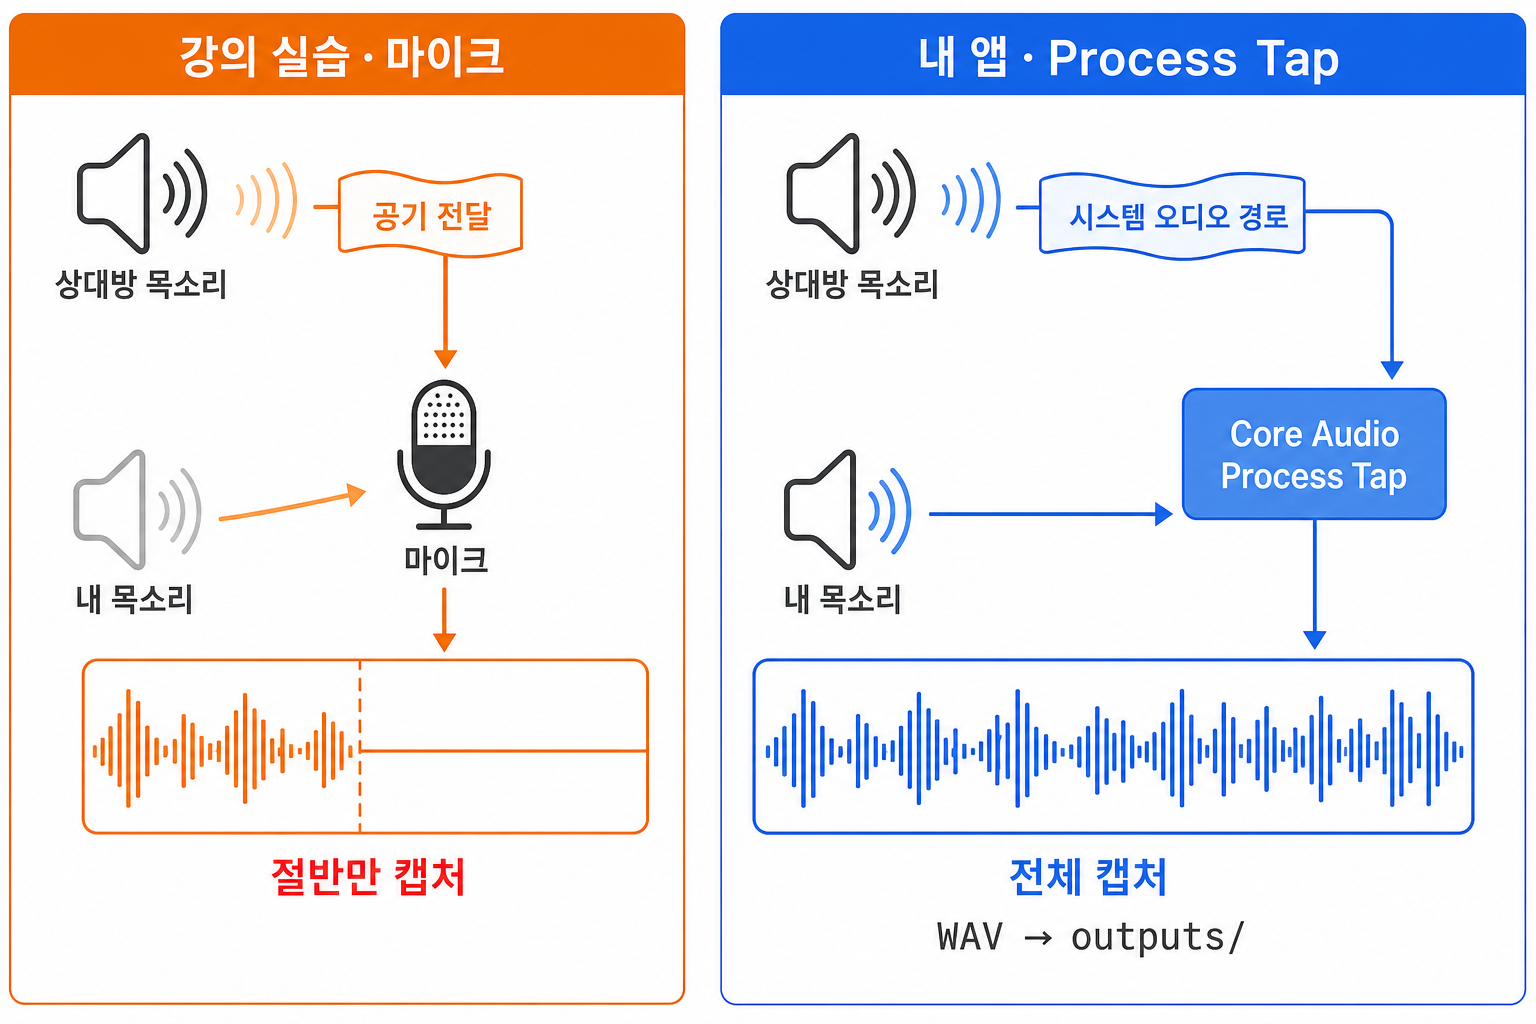 Process Tap은 시스템 출력 소리를 캡처하며, 그림의 ‘전체 캡처’와 달리 내 마이크 입력까지 자동으로 포함한다는 뜻은 아니다
바이브코딩으로 넘긴 경계 — 내가 판단한 건 파이프라인, 맡긴 건 녹음·UI
솔직히 이 Process Tap 부분은 내가 짜지 않았다. Swift/SwiftUI 앱(macos/)과 네이티브 Core Audio 코드(native/apptap.swift)는 바이브코딩으로 AI에 맡겼다.
내가 직접 짠 건 Python meeting_stt 패키지, 곧 강의 노트북을 앱 코드로 옮긴 전사 파이프라인이었다. 어떤 모델을 쓰고 어느 장치에 올리며 어디서부터 이어갈지는 내가 판단했고, 그 판단에 실제 소리를 공급하는 네이티브 녹음과 UI는 맡겼다.
강의는 녹음한 오디오를 Obsidian의 Audio Recorder로 저장했다. 나는 Obsidian을 쓰지 않아 앱이 로컬 파일(outputs/)로 바로 저장하게 했고, 강의와 갈라진 지점도 여기였다.
Qwen3는 한국어 지원과 context 입력을 기준으로 선택했다
강의에서는 같은 오디오를 두 모델로 전사해 나란히 비교했다. Whisper-large-v3와 Qwen3-ASR-1.7B였다.
강의의 비교에서는 Whisper를 별도 힌트 없는 기준 모델로 쓰고, Qwen3에는 context 인자로 배경지식을 넣었다. 앱에서 활용하려던 기능은 이 배경지식 입력이었다.
Whisper vs Qwen3 — 강의의 비교 기준과 앱의 선택
Whisper-large-v3는 2023년 11월 모델로 인코더-디코더 구조였다. 강의에서는 별도 힌트 없이 전사하는 비교 기준으로 사용했다.
Qwen3-ASR-1.7B는 2026년 1월 모델로 오디오 인코더에 LLM 디코더를 붙인 구조였다. 뒤에 붙은 LLM 덕분에 context로 고유명사 같은 배경지식을 줄 수 있었고, 긴 오디오에도 대응했다.
사람 이름과 프로젝트명이 쏟아지는 회의에서는 이 통로의 유무가 컸다. 그래서 선택은 Qwen3 쪽으로 기울었다.
리더보드 — 점수와 한국어 지원을 함께 확인했다
강의 자료는 당시 Open ASR 리더보드에서 Qwen3-ASR-1.7B보다 상위인 모델들의 한국어 미지원을 선택 근거로 설명했다.
나는 그 비교와 context 기능을 바탕으로 Qwen3를 채택했다. 이를 내 회의 데이터에서 모든 모델을 비교해 한국어 정확도가 가장 높다고 검증한 결과로 보지는 않는다.
| 항목 | Whisper-large-v3 | Qwen3-ASR-1.7B |
|---|---|---|
| 출시 | 2023-11 | 2026-01 |
| 구조 | 인코더-디코더 | 오디오 인코더 + LLM 디코더 |
| 강의에서 사용한 힌트 | 별도 힌트 없는 baseline | context 입력 |
| 한국어 | 지원 | 지원 |
| 역할 | baseline (비교 기준) | 채택 |
context biasing은 안 한 말까지 끼워넣을 위험을 감수하고 고유명사를 살린다
회의록은 전체 오류율이 낮아도 사람 이름이나 프로젝트명을 틀리면 쓰기 어려웠다. 나머지 문장이 아무리 매끄러워도 이름이 엉뚱하게 적히고 프로젝트명이 뭉개지면 신뢰는 거기서 깨졌다.
context biasing은 특정 단어의 출력 확률을 조정해 이런 고유명사를 살리는 기법의 총칭이었다. Qwen3의 context가 그 구현이었다.
soft hint — 명령이 아니라 배경지식이라 부작용이 있다
여기에는 주의할 점이 있었다. context는 특정 단어의 출력을 강제하는 명령이 아니라 전사를 돕는 배경지식, 즉 soft hint다.
그만큼 부작용도 따라왔다. 실제로 나오지 않은 말이라도 context에 들어 있으면 모델이 그 단어를 끼워 넣을 수 있었다.
정확도를 높이려고 넣은 힌트가 없는 말을 만들 수도 있다는 뜻이었다. 공짜로 얻는 이득은 아니었다.
양이 아니라 선별 — distractor를 피하고 no-context와 비교한다
그래서 context는 많이 넣는다고 좋아지지 않았다. 관련 없는 단어는 주의를 흐리는 힌트인 distractor가 되어 전사를 방해할 수 있었다.
실제로 나올 고유명사만 소수 골라 쉼표로 구분해 넣었다. 회의마다 등장인물과 프로젝트가 달랐으니, 실제 참석자와 안건 이름만 매번 추리는 게 맞았다.
내가 넣은 형식은 아래와 같았다. 참석자 이름은 익명으로 가렸다.
1
Obsidian, LLM-Wiki, 클로바노트, STT, 화자분리, pyannote, Qwen3-ASR, 김OO, 이OO, 박OO
효과를 판단하는 기준은 강의 자료에서 가져왔다. 전체 오류율은 WER로 쟀고, 틀린 단어인 치환·삽입·삭제를 전체 단어 수로 나눈 값이라 낮을수록 좋았다.
문제는 WER이 전체 평균이라 고유명사 하나가 틀려도 티가 잘 나지 않는다는 점이었다. 그래서 바이어싱 대상인 고유명사만 따로 재는 B-WER을 봐야 했다. context 전후의 B-WER을 비교하면 중요한 이름이 얼마나 살아났는지 드러났다.
다만 내 앱 코드에는 B-WER 계산까지 넣지 않았다. no-context와 with-context를 비교한다는 판단 기준만 개념으로 잡아뒀다.
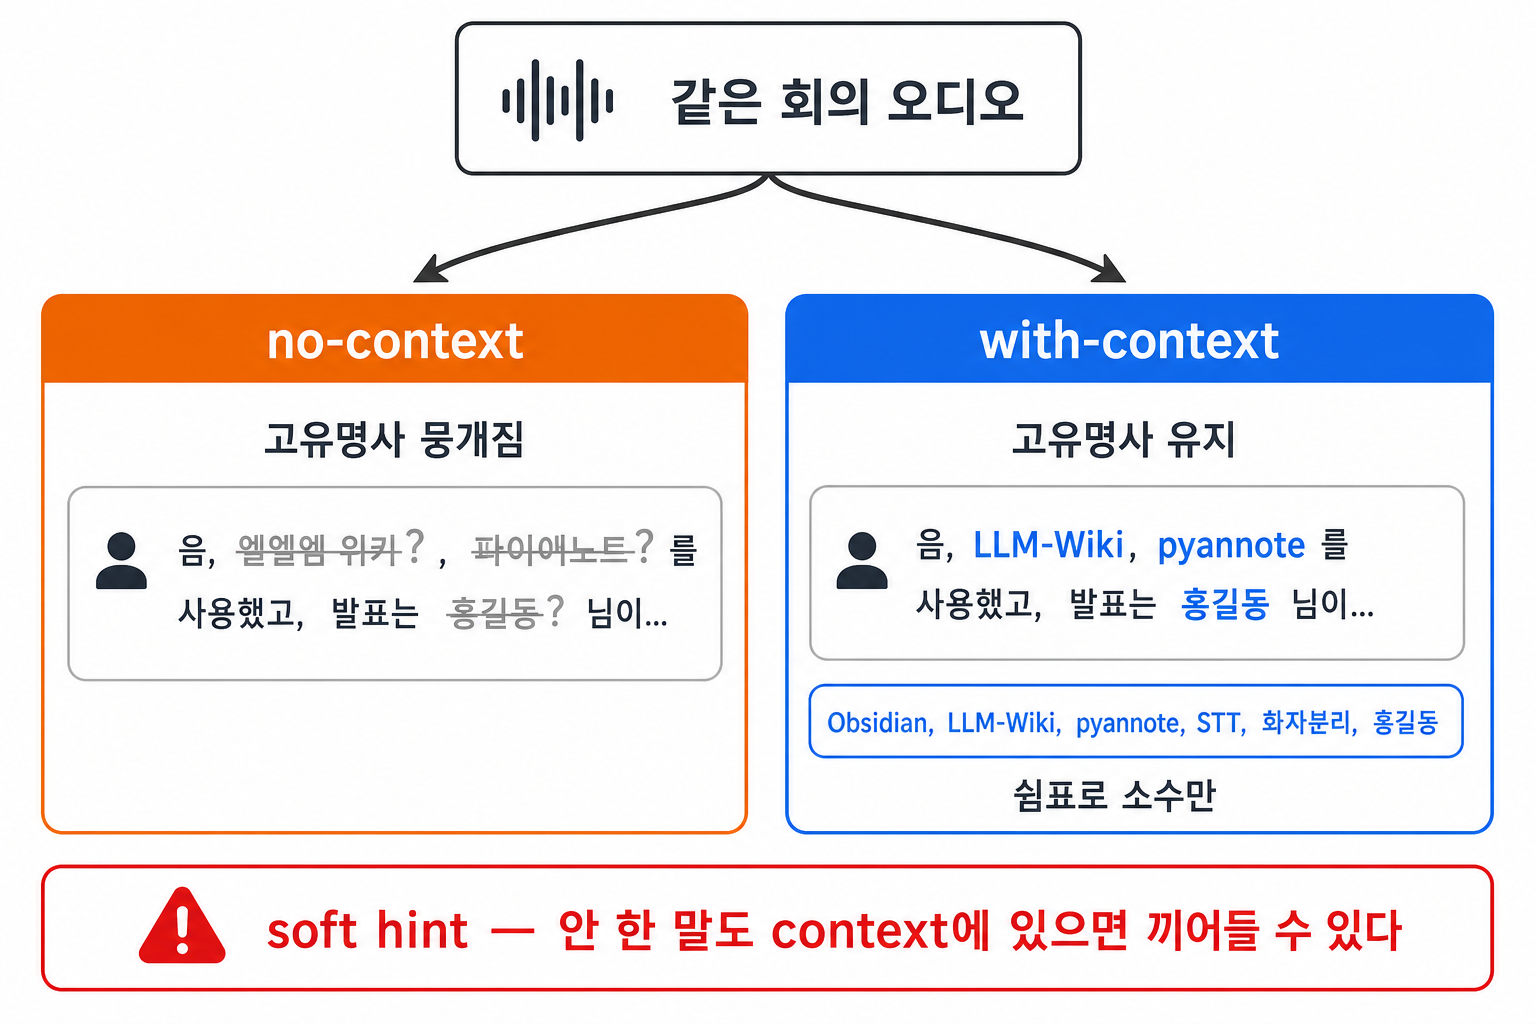 context는 고유명사를 살리는 대신 말하지 않은 단어까지 끼워넣을 수 있는 soft hint라, 많이 넣는 게 아니라 골라 넣어야 한다
API 확인 — 설명의 initial_prompt와 실제 context 인자가 달랐다
여기서 한 번 헛다리를 짚었다. 강의 노트북의 마크다운 설명은 이 파라미터를 initial_prompt라고 적어뒀지만, initial_prompt는 Whisper 쪽 용어였다.
바로 아래 셀의 실제 코드는 model.transcribe(..., context=CONTEXT_PROMPT)처럼 context를 쓰고 있었다. 설명과 실제 인자가 어긋나 있었다.
앱에서 사용한 qwen-asr API에는 해당 인자가 없었다. 설명에 적힌 이름보다 실제 호출 코드와 API를 기준으로 맞춰야 했다.
그래서 앱 코드(asr.py)는 실제 API에 맞춰 context=로 주입하도록 짰다. 다음에 또 헷갈리지 않도록 주석에도 근거를 남겼다.
1
2
3
4
5
# qwen-asr 0.0.6 실제 API: transcribe(audio, context=...)
# (노트북의 initial_prompt 인자는 실제 패키지에 없어 사용하지 않는다.)
if ctx:
    kwargs["context"] = ctx
model.transcribe(audio, language="Korean", **kwargs)
앱에서는 강의 자료의 쉼표 구분 키워드 형식을 따랐다. 넣기 전에 공백을 정리하는 처리(_clean_context)도 뒀다.
맥에는 CUDA가 없어서 ASR만 MPS로 올리고 화자분리는 CPU에 남겼다
강의 노트북의 디바이스 설정은 "cuda:0" if torch.cuda.is_available() else "cpu" 한 줄이었다. CUDA가 있으면 GPU, 없으면 CPU라는 이분법이었다.
문제는 내 맥에 CUDA가 없다는 점이었다. 이 코드를 그대로 돌리면 무조건 else로 빠져 모든 연산이 CPU로 갔다.
cuda-or-cpu 이분법 — 그대로 쓰면 맥은 전부 CPU였다
애플 실리콘 맥의 GPU에는 CUDA가 아니라 MPS로 접근했다. 그런데 강의의 셋업 노트북은 Windows를 전제로 GPU를 torch.cuda.is_available()로만 확인해서 MPS 경로가 아예 없었다.
강의 코드를 맥에 그대로 올리자 GPU가 눈앞에 있는데도 CPU만 썼다. 한 시간짜리 회의를 CPU로 전사하면 얼마나 걸릴지 감조차 잡히지 않았다.
그래서 강의 코드를 옮기며 디바이스 판정부터 다시 짰다. ASR은 MPS를 우선 사용하게 바꿨다.
ASR은 MPS, pyannote는 CPU — 같은 GPU에 안 올린 이유
그렇다고 전부 MPS로 올리지는 않았다. ASR(Qwen3)은 MPS로 가속하고 화자분리(pyannote)는 CPU에 남기는 비대칭 배치를 택했다.
내 실행 환경에서는 pyannote가 MPS에서 불안정했기 때문이다. 연산이 무거운 전사만 GPU로 끌어올리고, 화자분리는 조금 느려도 안정적으로 도는 CPU에 뒀다.
1
2
3
4
# ASR(Qwen3)은 GPU(MPS)가 있으면 GPU로, 없으면 CPU로.
# 화자분리(pyannote)는 안정성 위해 CPU.
def resolve_device_dtype():
    ...
이 판정 함수가 강의의 한 줄짜리 이분법을 대신했다.
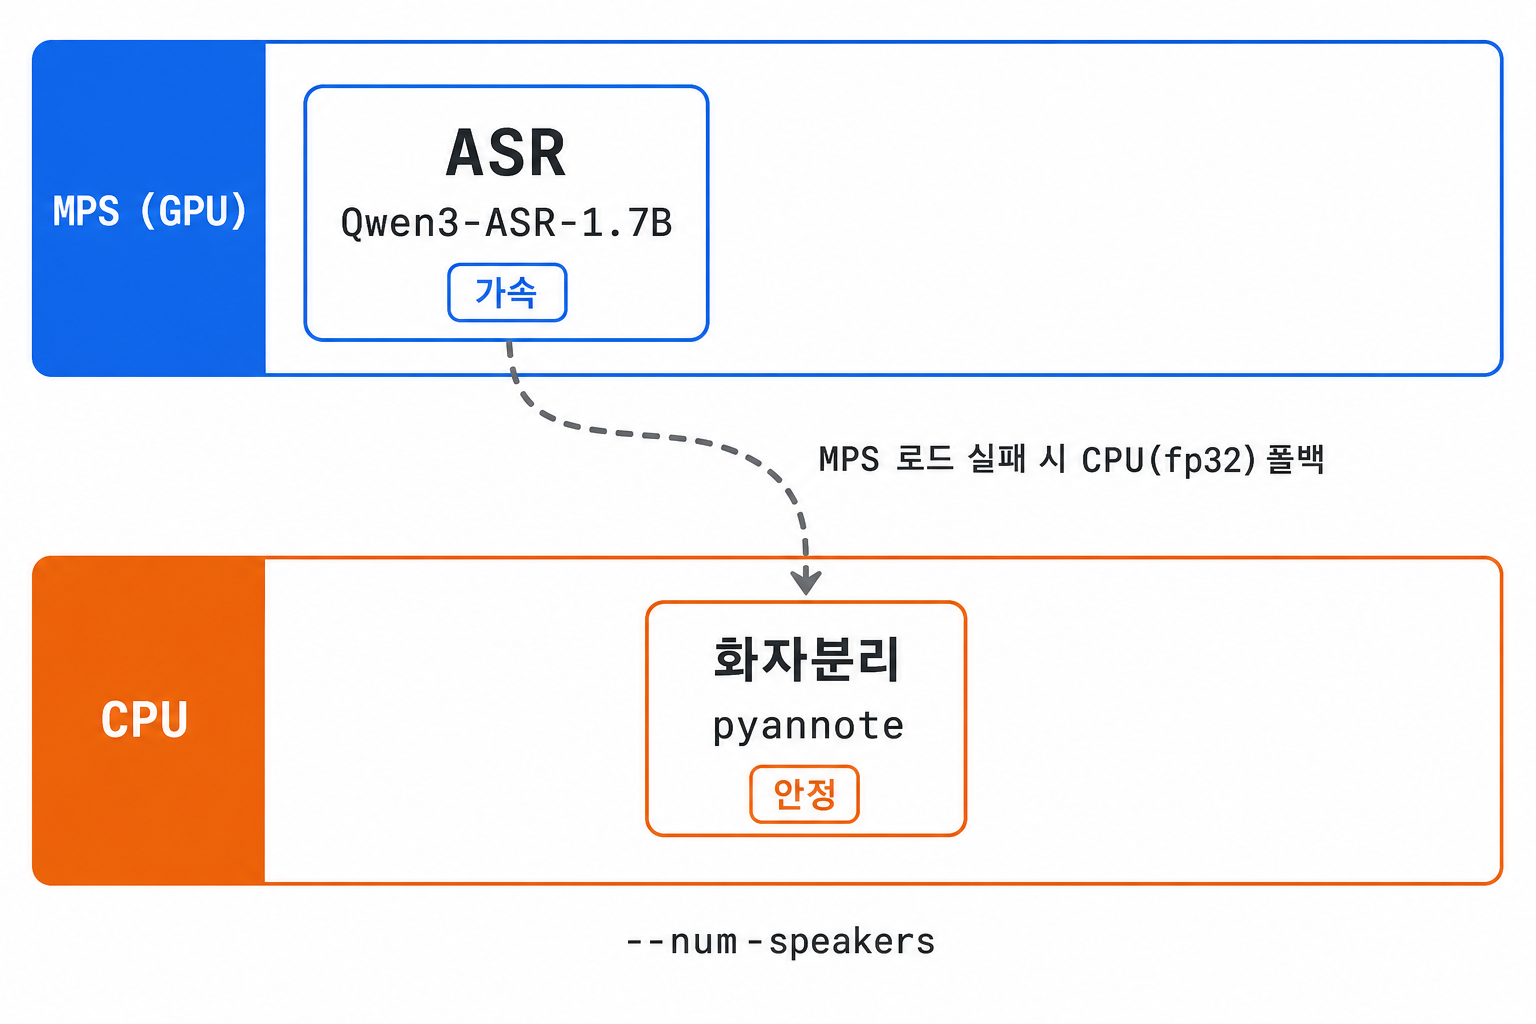 무거운 전사만 MPS로 끌어올리고 MPS에서 불안정한 화자분리는 CPU에 남긴, 강의의 한 줄 이분법을 대체한 비대칭 배치다
화자분리에는 pyannote를 썼는데, 발화자가 겹치는 구간에 약했다. 화자 수를 미리 알려주면 도움이 된다고 해서 --num-speakers로 참석 인원을 지정할 수 있게 뒀다.
화자 라벨은 SPEAKER_00, SPEAKER_01처럼 익명으로 나와 나중에 실제 사람과 매핑해야 했다. 1초 이하의 짧은 묵음은 같은 발화로 병합하도록(min_duration_off=1.0) 뒀는데, 잠깐 숨을 고른 순간을 발화가 끊긴 것으로 보지 않기 위해서였다.
삽질 — pyannote를 MPS에 올렸다가 CPU로 되돌렸다
처음에는 화자분리도 당연히 MPS에 올렸다. GPU가 있으니 모두 올리는 게 빠를 거라 생각했다.
하지만 MPS에서 불안정해 결국 CPU로 되돌렸다. 처리 속도보다 중단 없이 끝나는 실행을 우선했다.
이 경험은 ASR 모델 로드에도 반영했다. MPS나 GPU에서 로드에 실패하면 CPU의 fp32로 폴백하게 했다. 가속을 노리다 아예 멈추는 것보다 느리더라도 끝까지 도는 게 우선이었다.
한 시간짜리 회의가 중간에 끊겨도 처음부터 다시 돌리지 않게 했다
강의 실습은 5분짜리 mp3라 한 번에 끝났다. 실제 회의는 수십 분에서 한 시간이라 도중에 끊겼을 때의 손해가 컸다.
한 시간을 거의 다 전사한 뒤 마지막에 멈춰 처음부터 다시 돌리는 건 아까웠다. GPU가 무거운 전사를 오래 붙든 만큼 중간에 날아가면 들인 시간도 통째로 사라졌다.
그래서 중간저장과 이어하기를 넣었다.
.partial.json — 5구간마다 진행 상태를 저장한다
전사가 돌아가는 동안 5구간마다 진행 중인 세그먼트를 {stem}.partial.json에 저장했다. 끊기더라도 그 시점까지의 결과를 파일에 남기기 위해서였다.
로그에는 경과 시간과 남은 예상 시간(ETA)을 시·분·초 단위로 함께 찍었다. 긴 회의를 돌릴 때 현재 위치와 남은 기다림을 확인할 수 있게 했다.
1
2
3
4
def _dump_partial(...):
    # 진행 중 세그먼트를 {stem}.partial.json에 저장
    # → 끊겨도 다음 실행에서 이어할 수 있게
    ...
이어하기 — 같은 오디오·같은 세그먼트면 전사된 것을 재사용한다
여기서 세그먼트는 오디오를 일정 길이로 자른 조각이었다. 강의 실습은 30초 단위로 자르되 앞뒤 2초를 겹쳐 경계에서 말이 잘리지 않게 했고, 그렇게 잘린 조각 하나하나가 이어하기의 단위가 됐다.
다음 실행에서는 먼저 이전 .partial.json을 읽었다. 오디오 경로와 세그먼트 수가 같으면 이미 전사된 구간을 재사용했다. 이 검사는 파일 내용이나 모델·context의 동일성까지 보장하지 않으므로, 입력과 설정을 바꾸지 않은 실행을 이어가는 용도로 한정했다.
같은 파일을 같은 방식으로 자른 결과라면 이미 전사한 부분을 다시 돌릴 이유가 없다고 판단했다. 끊긴 지점부터 이어서 돌렸고, 로그에는 전체 중 몇 개를 재사용했는지도 찍었다.
전사가 끝나면 .partial.json을 지웠다. 완료된 회의에는 중간 파일을 남기지 않아, partial의 존재 자체가 아직 끝나지 않은 회의라는 신호가 됐다.
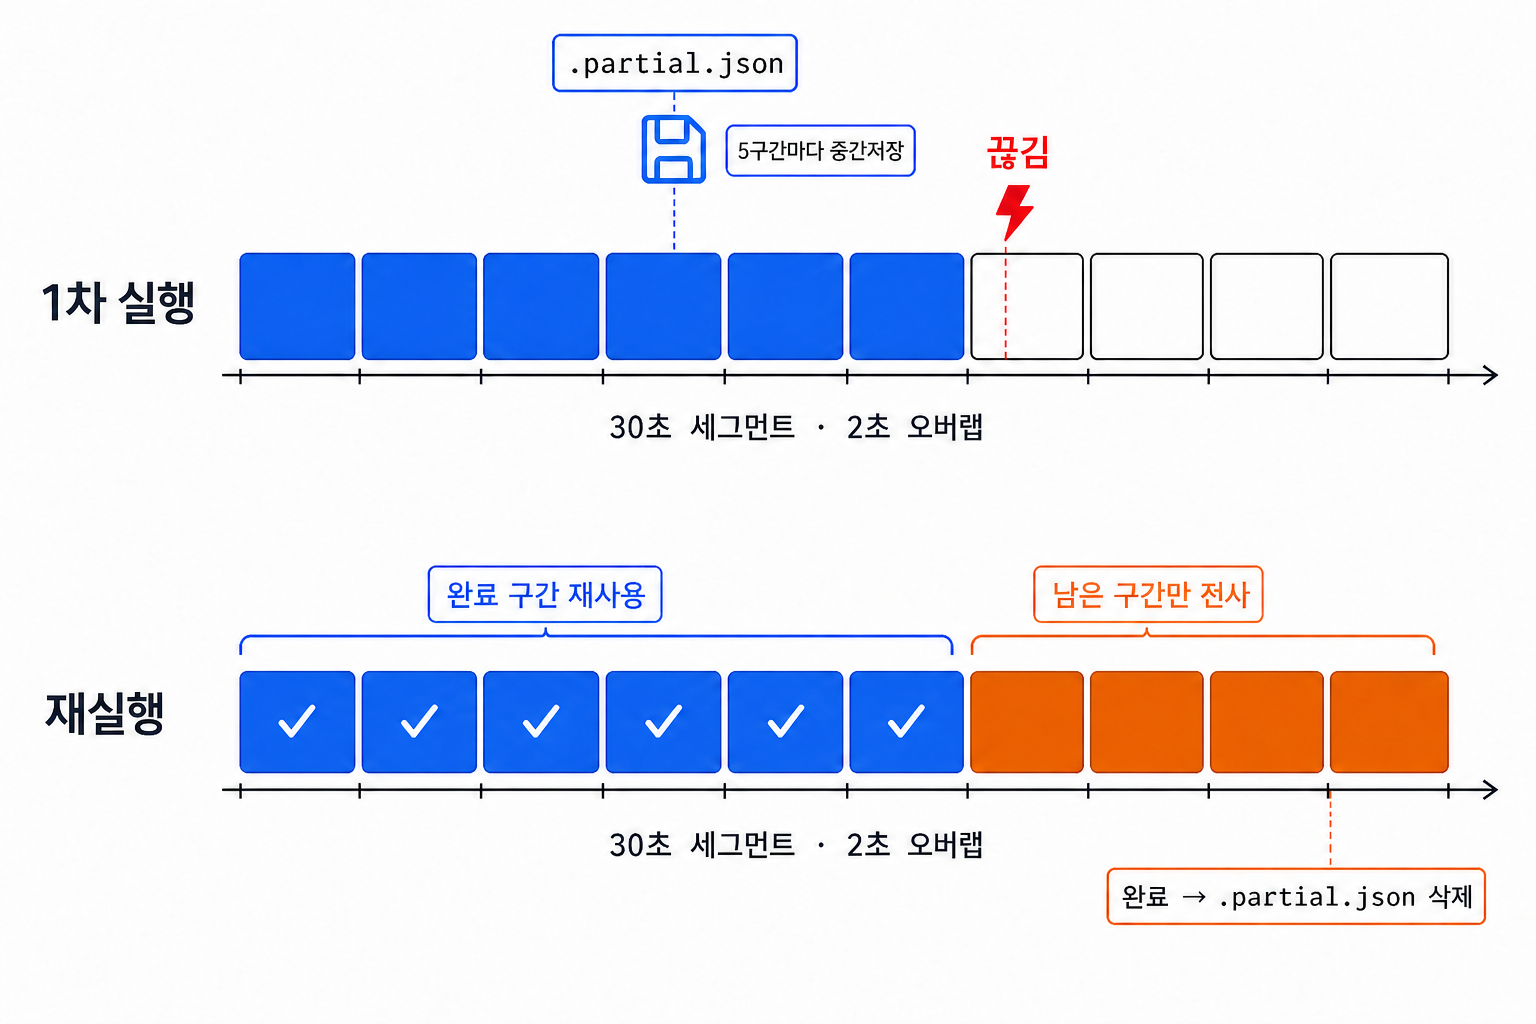 5구간마다 떨군 .partial.json 덕에, 한 시간짜리 회의가 끊겨도 완료 구간은 재사용하고 남은 구간만 다시 돌린다
마무리
강의의 실습 목표는 “완벽한 제품보다 파이프라인 한 번 끝까지 통과”였다. 노트북 마지막 셀에는 전사 결과를 파일로 저장하고 회의록으로 요약하는 일이 To-Do로 남아 있었다.
강의의 개념을 코드로 옮기며 이해가 굳었다. 머리로 아는 것과 인자 이름 하나까지 맞춰 실제로 돌리는 것은 다른 일이었고, 옮기는 과정에서 마주친 어긋남이 오히려 개념을 또렷하게 만들었다.
가장 오래 남은 건 context biasing의 “양이 아니라 선별”이라는 감각이었다. 많이 넣을수록 좋아질 거라는 직관이 틀렸음을 distractor라는 개념으로 확인한 순간이 인상 깊었다.
녹음 입력, 실행 장치, 중간 결과 저장을 함께 다루면서 노트북 실습을 반복해서 사용할 수 있는 앱으로 확장했다. 긴 회의를 처리하려면 모델 선택뿐 아니라 입력을 확보하고 중단된 실행을 이어가는 흐름도 필요했다.
앱 전체 코드는 github.com/jingi723/STT에 열어뒀다.
| 강의 노트북 (test.ipynb) | 내 앱 (meeting_stt) |
|---|---|
| mp3 하나 수동 전사 | 녹음(Swift/Process Tap) → 세션 → 전사 파이프라인 |
| Whisper vs Qwen3 비교 | Qwen3-ASR-1.7B 채택 |
cuda:0 / cpu | MPS(ASR) + CPU(pyannote) |
| context 프롬프트 셀 | asr.py context biasing + CLI --context |
| 30초/2초 청킹 | audio.chunk_audio (no-diarize 경로) |
min_duration_off=1.0 | diarize.py 화자 병합 |
| To-Do: 파일저장/요약 | pipeline 저장(.json/.md) + notes.py 회의록·프롬프트 |